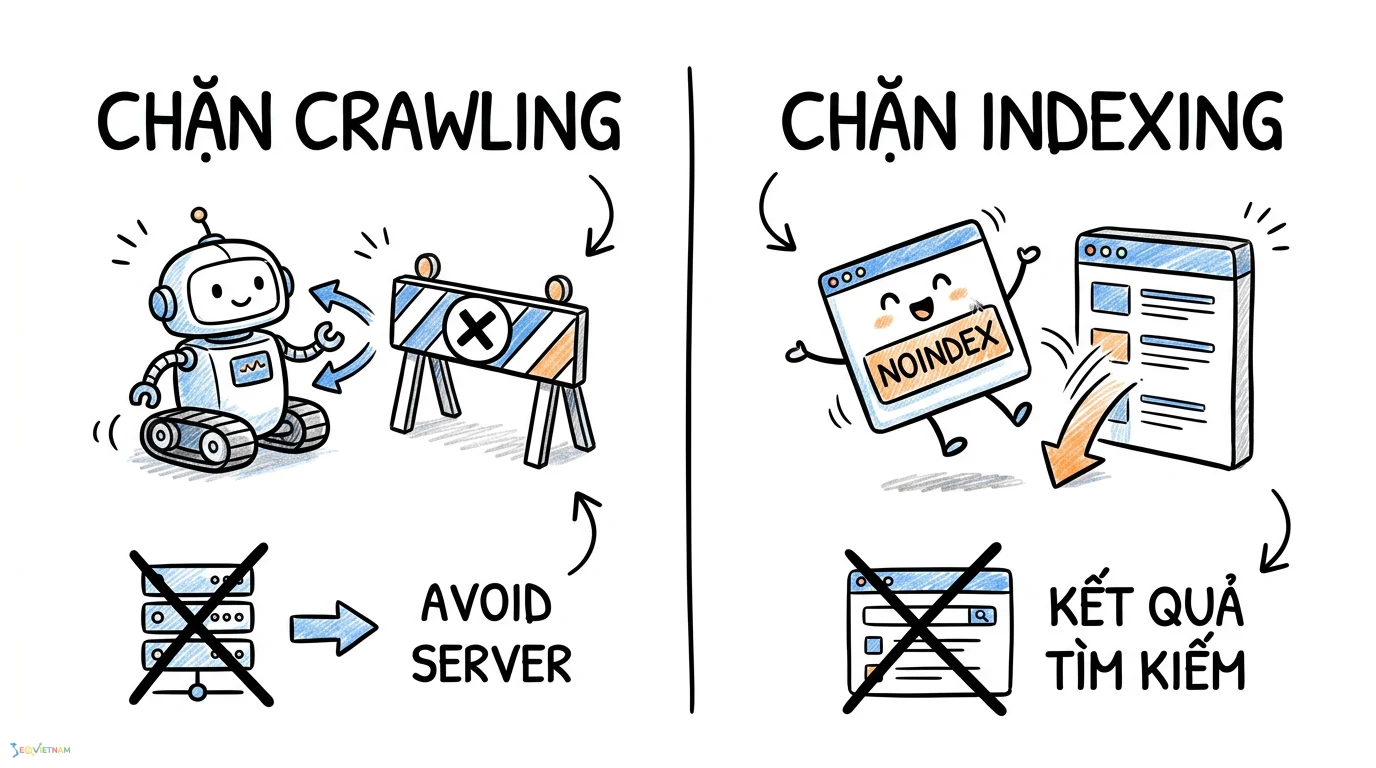
Sự nhầm lẫn giữa robots.txt và noindex là một trong những nguyên nhân hàng đầu dẫn đến các lỗi SEO nghiêm trọng. Nhiều quản trị viên web cho rằng việc chặn một trang trong tệp robots.txt sẽ tự động xóa trang đó khỏi kết quả tìm kiếm của Google. Tuy nhiên, thực tế không phải vậy. Việc hiểu rõ robots.txt vs noindex khác nhau gì sẽ giúp bạn kiểm soát chính xác cách Googlebot thu thập dữ liệu (crawling) và lập chỉ mục (indexing) website của mình. Bài viết này sẽ phân tích chi tiết sự khác biệt, cung cấp bảng so sánh trực quan và hướng dẫn bạn cách chọn đúng phương pháp cho từng mục tiêu SEO cụ thể.
Robots.txt là gì?
Robots.txt là một tệp văn bản đơn giản được đặt ở thư mục gốc của website, đóng vai trò như một bộ quy tắc hướng dẫn các trình thu thập dữ liệu (như Googlebot) biết họ được phép hoặc không được phép truy cập vào những phần nào của trang web.
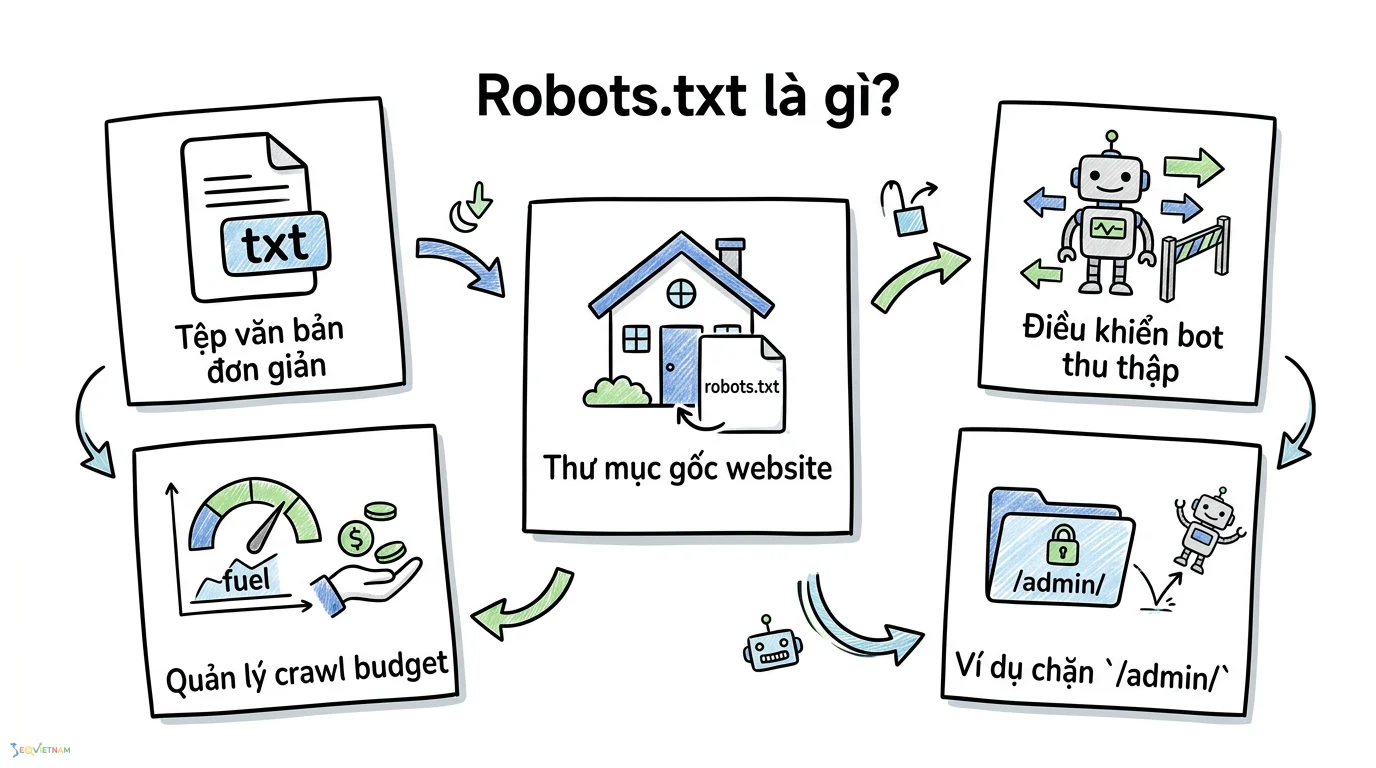
Mục đích chính của tệp này là quản lý quá trình thu thập dữ liệu (crawling) và tối ưu hóa crawl budget (ngân sách thu thập dữ liệu). Khi bạn không muốn các bot tìm kiếm lãng phí tài nguyên vào việc quét các thư mục quản trị, các trang kết quả tìm kiếm nội bộ hoặc các tệp không quan trọng, robots.txt là công cụ phù hợp nhất. Để hiểu sâu hơn về cách các lệnh này tương tác với bot tìm kiếm, bạn có thể tìm hiểu thêm về cơ chế hoạt động của file robots.txt.
Dưới đây là một ví dụ về cú pháp chặn Googlebot thu thập dữ liệu một thư mục cụ thể:
User-agent: Googlebot Disallow: /admin/
Noindex là gì?
Noindex là một chỉ thị trực tiếp yêu cầu các công cụ tìm kiếm không được đưa một trang web cụ thể vào cơ sở dữ liệu kết quả tìm kiếm (indexing). Chỉ thị này thường được triển khai dưới dạng thẻ Meta robots tag đặt trong phần head của mã HTML, hoặc thông qua HTTP response header (X-Robots-Tag).
Khác với robots.txt, noindex không ngăn cản Googlebot truy cập vào trang. Bot vẫn sẽ thu thập dữ liệu trang web, đọc nội dung, nhưng khi nhìn thấy thẻ noindex, nó sẽ quyết định loại bỏ trang đó khỏi Search engine results (kết quả tìm kiếm). Đây là giải pháp triệt để nhất khi bạn muốn bảo mật thông tin hoặc ẩn các trang có nội dung mỏng khỏi người dùng tìm kiếm.
Cú pháp thẻ meta noindex tiêu chuẩn thường có dạng như sau:
<meta name="robots" content="noindex, follow">
So sánh sự khác biệt giữa robots.txt và noindex
Để dễ dàng hình dung robots.txt vs noindex khác nhau gì, bạn cần nhớ một nguyên tắc cốt lõi: Robots.txt kiểm soát việc "Truy cập" (Crawling), trong khi Noindex kiểm soát việc "Hiển thị" (Indexing).
Dưới đây là bảng so sánh chi tiết giúp bạn phân biệt rõ hai khái niệm này:
|
Tiêu chí |
Robots.txt (Disallow) |
Thẻ Noindex |
|
Mục đích chính |
Ngăn chặn bot thu thập dữ liệu (Crawling) |
Ngăn chặn trang xuất hiện trên kết quả tìm kiếm (Indexing) |
|
Vị trí đặt lệnh |
Tệp robots.txt ở thư mục gốc |
Thẻ meta trong HTML hoặc HTTP header |
|
Tác động đến Crawl budget |
Giúp tiết kiệm ngân sách thu thập dữ liệu |
Không tiết kiệm (bot vẫn phải cào trang để đọc thẻ) |
|
Trang có xuất hiện trên Google không? |
Vẫn có thể xuất hiện nếu có backlink trỏ đến |
Chắc chắn không xuất hiện |
|
Khả năng truyền sức mạnh liên kết |
Không truyền được vì bot không cào được trang |
Có thể truyền được nếu dùng kèm lệnh follow |
Khi nào nên dùng robots.txt?
Bạn nên sử dụng tệp robots.txt khi mục tiêu chính là quản lý tài nguyên máy chủ và điều hướng luồng thu thập dữ liệu của Googlebot. Các trường hợp áp dụng phổ biến bao gồm việc chặn bot quét các trang đăng nhập, thư mục hệ thống, hoặc các trang có tham số URL tạo ra vô số phiên bản trùng lặp.
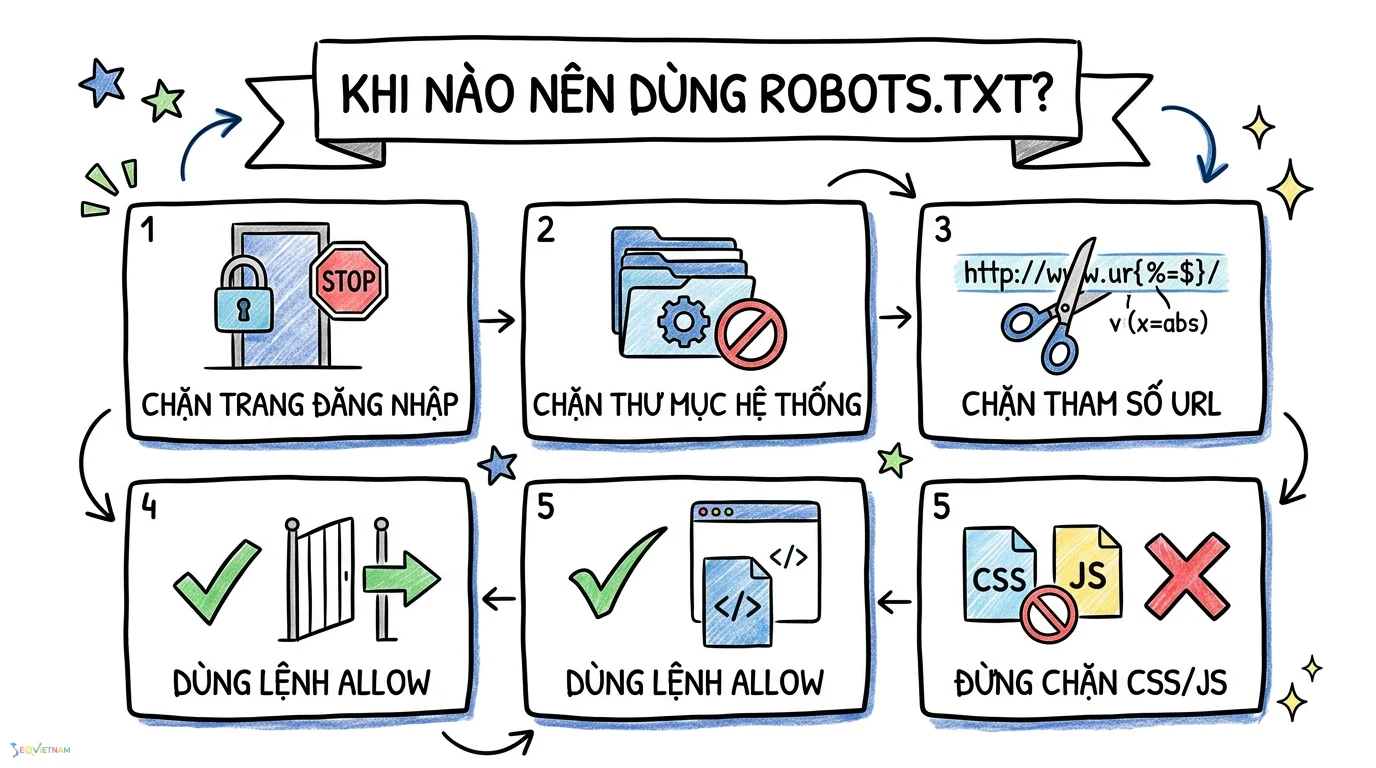
Bên cạnh việc chặn, bạn cũng có thể kết hợp các lệnh cho phép để mở đường cho bot vào các tài nguyên quan trọng. Việc nắm rõ cách sử dụng lệnh allow trong robots.txt để tối ưu crawl sẽ giúp bạn kiểm soát luồng dữ liệu một cách tinh tế hơn. Đồng thời, khi cấu hình tệp này, nhiều người thường thắc mắc liệu robots txt chặn css js có sao không để tránh ảnh hưởng đến khả năng render giao diện của Googlebot. Theo các nguyên tắc SEO best practices hiện đại, bạn không nên chặn các tệp tài nguyên tĩnh này vì Google cần chúng để hiểu toàn bộ bố cục trang.
Khi nào nên dùng noindex?
Thẻ noindex là lựa chọn bắt buộc khi bạn tuyệt đối không muốn người dùng tìm thấy một trang cụ thể trên Google. Các kịch bản thực tế thường gặp bao gồm:
- Các trang cảm ơn (Thank you pages) sau khi khách hàng điền form hoặc mua hàng.
- Các trang chính sách nội bộ, điều khoản dịch vụ không mang lại giá trị SEO.
- Môi trường staging (trang web đang thử nghiệm) cần ẩn khỏi công cụ tìm kiếm trước khi ra mắt chính thức.
- Các trang có nội dung mỏng (thin content) hoặc nội dung do người dùng tạo ra có chất lượng thấp, nhằm tránh bị thuật toán đánh giá xấu toàn trang.
Sai lầm phổ biến cần tránh khi kết hợp lệnh
Một trong những lỗi kỹ thuật SEO nghiêm trọng nhất là cố gắng sử dụng cả hai phương pháp này cùng lúc trên một trang mà không hiểu rõ cơ chế hoạt động của chúng.
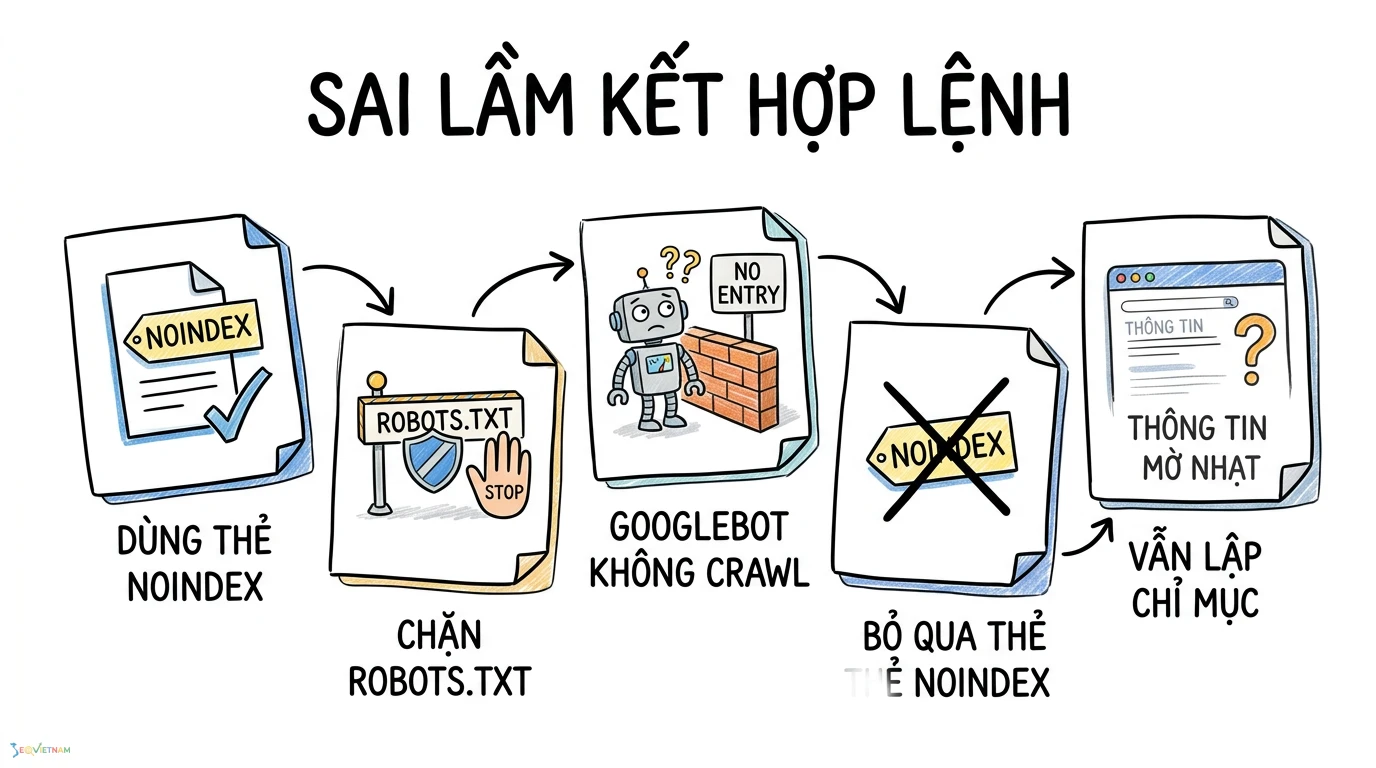
Pro-tip: Tuyệt đối không chặn một trang bằng robots.txt nếu trang đó đang gắn thẻ noindex.
Lý do rất đơn giản: Để Googlebot biết một trang có thẻ noindex, nó buộc phải thu thập dữ liệu (crawl) trang đó. Nếu bạn chặn URL này trong tệp robots.txt, Googlebot sẽ không bao giờ truy cập được vào mã HTML để đọc thẻ noindex. Kết quả là, Google vẫn có thể lập chỉ mục URL đó (thường hiển thị với tiêu đề mờ nhạt và dòng chữ "Không có thông tin nào cho trang này" trên kết quả tìm kiếm) vì nó tìm thấy URL thông qua các liên kết nội bộ hoặc backlink khác.
Câu hỏi thường gặp
Robots.txt có ngăn chặn được index không?
Không hoàn toàn. Tệp robots.txt chỉ ngăn Googlebot thu thập dữ liệu trang. Nếu URL của bạn được liên kết từ một trang web khác đã được lập chỉ mục, Google vẫn có thể đưa URL đó lên kết quả tìm kiếm mà không cần biết nội dung bên trong là gì.
Tôi có thể dùng cả hai lệnh cùng lúc không?
Về mặt kỹ thuật là có, nhưng đây là một thực hành SEO sai lầm. Nếu bạn dùng cả hai, lệnh disallow trong robots.txt sẽ ngăn Googlebot nhìn thấy thẻ noindex. Do đó, hãy chọn một trong hai tùy thuộc vào mục đích là chặn cào dữ liệu hay chặn lập chỉ mục.
Tại sao trang của tôi vẫn xuất hiện trên Google dù đã chặn trong robots.txt?
Điều này xảy ra do Google tìm thấy URL của bạn thông qua các backlink hoặc liên kết nội bộ từ các trang khác. Vì bị chặn cào dữ liệu, Google không thể đọc nội dung nhưng vẫn index URL. Để khắc phục, bạn cần gỡ lệnh chặn trong robots.txt và thêm thẻ noindex vào trang.
Thẻ noindex có giúp tiết kiệm crawl budget không?
Không. Khi bạn sử dụng thẻ noindex, Googlebot vẫn phải dành tài nguyên để truy cập vào trang, tải mã HTML và đọc thẻ meta đó. Nếu mục tiêu của bạn là tối ưu hóa ngân sách thu thập dữ liệu cho các trang web lớn, robots.txt mới là giải pháp đúng đắn.
Làm thế nào để kiểm tra trang đã bị chặn đúng cách chưa?
Bạn nên sử dụng công cụ Kiểm tra URL (URL Inspection Tool) trong Google Search Console. Công cụ này sẽ cho bạn biết chính xác trang có bị chặn bởi robots.txt hay không, và thẻ noindex có đang được Googlebot nhận diện thành công hay không.
Kết luận
Việc phân biệt rõ robots.txt vs noindex khác nhau gì là nền tảng vững chắc để xây dựng một chiến lược Technical SEO hiệu quả. Hãy nhớ rằng robots.txt dùng để quản lý ngân sách thu thập dữ liệu (Crawling), trong khi noindex là công cụ tối thượng để loại bỏ trang khỏi kết quả tìm kiếm (Indexing). Để đảm bảo website của bạn không mắc phải các xung đột kỹ thuật, hãy thường xuyên thực hiện audit SEO và kiểm tra trạng thái lập chỉ mục của toàn bộ trang web thông qua Google Search Console.
Bài viết liên quan
https://seovietnam.vn/cach-tao-file-robotstxt/