Tạo file robots.txt chuẩn SEO là bước kỹ thuật đầu tiên và quan trọng nhất để điều hướng Googlebot thu thập dữ liệu trên website của bạn. Một tệp robots.txt được cấu hình đúng không chỉ giúp tiết kiệm ngân sách thu thập dữ liệu (crawl budget) mà còn ngăn chặn các trang không quan trọng xuất hiện trên kết quả tìm kiếm. Bài viết này sẽ hướng dẫn chi tiết cách tạo file robots.txt từ cơ bản đến nâng cao, kèm theo các mẫu cấu hình sẵn cho WordPress, Shopify và các nền tảng phổ biến khác để bạn có thể áp dụng ngay lập tức.
File robots.txt là gì và tại sao nó quan trọng?
File robots.txt là một tệp văn bản đơn giản nằm ở thư mục gốc của website, đóng vai trò như một người chỉ đường cho các công cụ tìm kiếm. Khi Googlebot truy cập vào trang web của bạn, nó sẽ đọc tệp này đầu tiên để biết được những thư mục hoặc URL nào được phép quét và những phần nào cần bỏ qua.
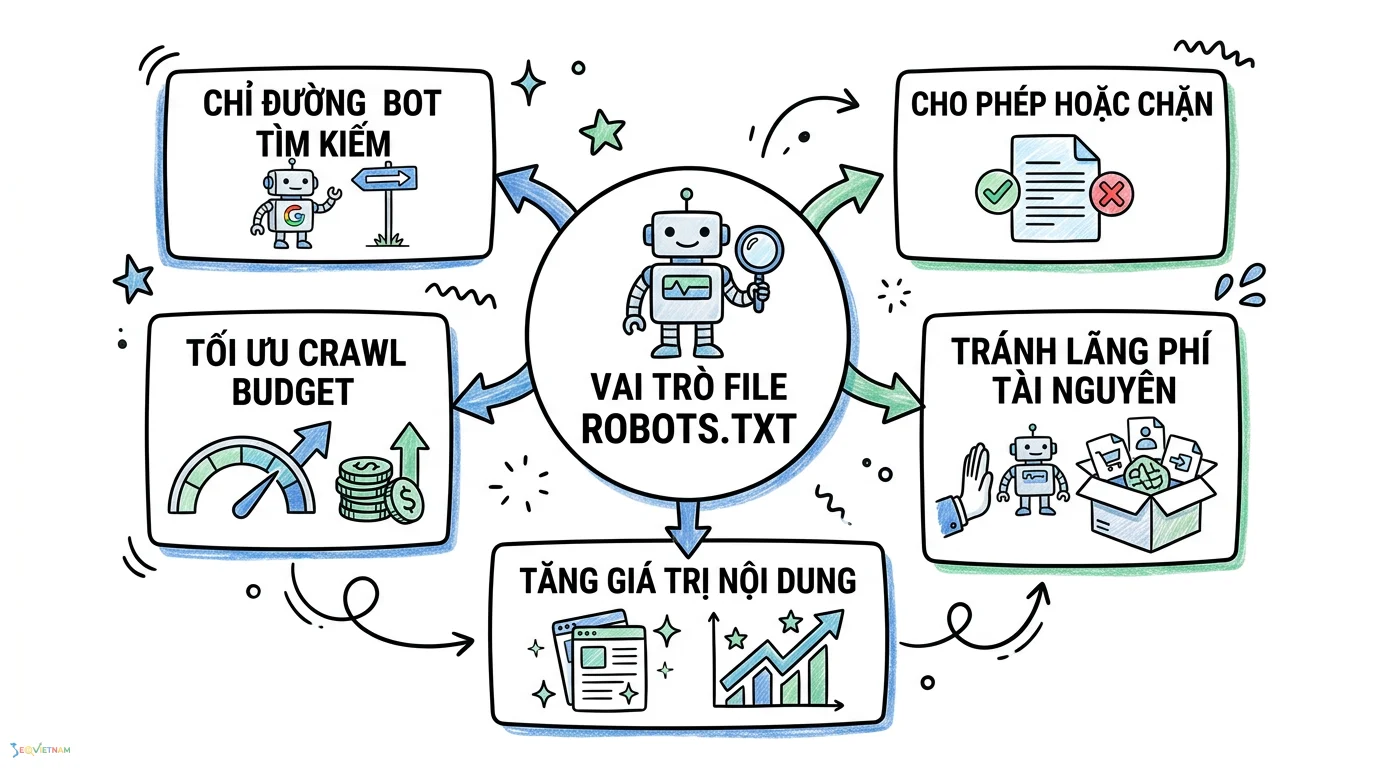
Việc thiết lập tệp này đúng cách mang lại lợi ích lớn cho quá trình SEO. Nó giúp tối ưu hóa crawl budget, đảm bảo bot tìm kiếm tập trung vào các nội dung mang lại giá trị chuyển đổi cao thay vì lãng phí tài nguyên vào các trang quản trị, trang giỏ hàng hay các tham số tìm kiếm nội bộ. Để nắm bắt toàn diện hơn về cách công cụ tìm kiếm tương tác với tệp này, bạn có thể tham khảo thêm tài liệu hiểu rõ bản chất và vai trò của file robots.txt để xây dựng nền tảng kỹ thuật vững chắc cho website.
Cấu trúc cơ bản của một file robots.txt
Một tệp robots.txt tiêu chuẩn được cấu thành từ các nhóm lệnh đơn giản. Hiểu rõ ý nghĩa của từng dòng lệnh sẽ giúp bạn tránh được những sai lầm nghiêm trọng khi chặn bot.
User-agent là dòng lệnh đầu tiên trong mỗi nhóm, dùng để xác định loại bot nào đang được nhắm mục tiêu. Nếu bạn sử dụng dấu sao (*), lệnh sẽ áp dụng cho tất cả các trình thu thập dữ liệu. Ngược lại, bạn có thể chỉ định đích danh Googlebot hoặc Bingbot nếu muốn thiết lập các quy tắc riêng biệt.
Disallow là lệnh dùng để chặn bot truy cập vào một đường dẫn hoặc thư mục cụ thể. Trong khi đó, Allow lại hoạt động ngược lại, cho phép bot truy cập vào một tệp cụ thể nằm trong một thư mục đã bị chặn. Việc kết hợp khéo léo hai lệnh này là kỹ năng bắt buộc đối với người làm SEO kỹ thuật. Bạn có thể tìm hiểu sâu hơn về cách sử dụng lệnh allow trong file robots.txt để tối ưu crawl để đảm bảo các tài nguyên quan trọng như hình ảnh, CSS hay JavaScript không bị chặn nhầm.
Cuối cùng, Sitemap là dòng lệnh cung cấp đường dẫn tuyệt đối đến sơ đồ trang web của bạn. Việc khai báo sitemap trong tệp robots.txt giúp các công cụ tìm kiếm khám phá cấu trúc website và lập chỉ mục các bài viết mới một cách nhanh chóng hơn.
Hướng dẫn cách tạo file robots.txt chi tiết
Tùy thuộc vào nền tảng quản trị nội dung (CMS) bạn đang sử dụng, cách tạo và chỉnh sửa tệp robots.txt sẽ có sự khác biệt. Dưới đây là các phương pháp phổ biến nhất.
Cách tạo thủ công bằng Notepad
Đối với các website code tay (Custom PHP, HTML), bạn cần tạo tệp thủ công. Hãy mở ứng dụng Notepad trên máy tính và tạo một tệp văn bản mới. Nhập các quy tắc User-agent, Disallow và Allow theo cấu trúc chuẩn. Sau khi hoàn tất, lưu tệp với tên chính xác là "robots.txt" (viết thường toàn bộ). Cuối cùng, sử dụng FTP client như FileZilla hoặc truy cập vào File Manager trên hosting (cPanel/DirectAdmin) để tải tệp này lên thư mục gốc (public_html) của website.
Cách tạo trên WordPress (sử dụng plugin)
WordPress là nền tảng phổ biến nhất và việc tạo tệp robots.txt trên đây cực kỳ đơn giản nhờ các plugin SEO. Nếu bạn sử dụng Yoast SEO, hãy truy cập vào mục Yoast SEO trên bảng điều khiển, chọn Tools, sau đó nhấp vào File editor. Tại đây, bạn có thể nhấn nút tạo tệp robots.txt và trực tiếp chỉnh sửa nội dung. Đối với Rank Math SEO, bạn chỉ cần vào General Settings, chọn Edit robots.txt và dán các quy tắc của mình vào ô trống.
Cách thiết lập trên Shopify
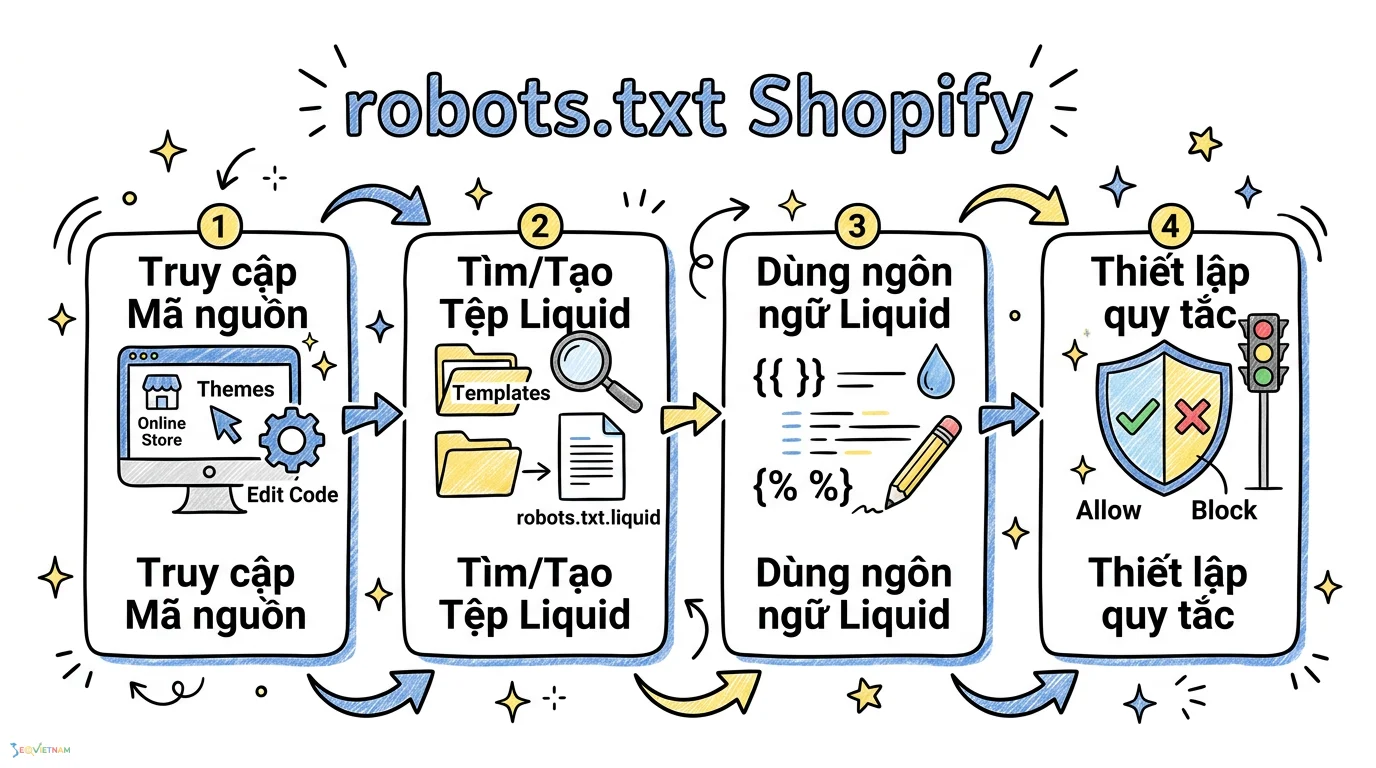
Shopify tự động tạo một tệp robots.txt mặc định cho mọi cửa hàng. Tuy nhiên, nếu bạn muốn tùy chỉnh, bạn cần can thiệp vào mã nguồn của giao diện. Truy cập vào phần Online Store, chọn Theme và nhấp vào Edit code. Tìm kiếm tệp robots.txt.liquid trong thư mục Templates. Nếu chưa có, bạn có thể thêm tệp mới và sử dụng ngôn ngữ Liquid để thiết lập các quy tắc chặn hoặc cho phép bot thu thập dữ liệu theo ý muốn.
Mẫu file robots.txt chuẩn SEO cho mọi website
Để tiết kiệm thời gian, bạn có thể sử dụng các mẫu tệp đã được tối ưu hóa dưới đây. Chỉ cần sao chép, thay đổi đường dẫn sitemap và dán vào website của bạn.
Mẫu dành cho website WordPress tiêu chuẩn
Đối với một blog hoặc trang web giới thiệu doanh nghiệp sử dụng WordPress, bạn cần chặn bot truy cập vào khu vực quản trị nhưng vẫn phải cho phép chúng đọc tệp admin-ajax.php để hiển thị giao diện chính xác.
User-agent: * Disallow: /wp-admin/ Allow: /wp-admin/admin-ajax.php Sitemap: https://tenmiencuaban.com/sitemap_index.xml
Mẫu dành cho website thương mại điện tử
Các trang web bán hàng thường tạo ra rất nhiều URL động từ bộ lọc sản phẩm, trang giỏ hàng và thanh toán. Việc chặn bot quét các trang này là bắt buộc để tránh lỗi trùng lặp nội dung.
User-agent: * Disallow: /cart/ Disallow: /checkout/ Disallow: /my-account/ Disallow: /?filter= Sitemap: https://tenmiencuaban.com/sitemap.xml
Những lưu ý và sai lầm nghiêm trọng khi chỉnh sửa robots.txt
Một sai lầm nhỏ trong tệp robots.txt có thể khiến toàn bộ website của bạn biến mất khỏi kết quả tìm kiếm của Google. Lỗi phổ biến và nguy hiểm nhất là sử dụng lệnh "Disallow: /". Dấu gạch chéo này đại diện cho toàn bộ thư mục gốc, đồng nghĩa với việc bạn đang chặn mọi công cụ tìm kiếm truy cập vào bất kỳ trang nào trên website. Hãy luôn kiểm tra kỹ lưỡng khoảng trắng và các ký tự đặc biệt trước khi lưu tệp.
Bên cạnh đó, nhiều người nhầm lẫn giữa việc chặn thu thập dữ liệu và chặn lập chỉ mục (index). Tệp robots.txt chỉ ngăn bot cào dữ liệu, nhưng URL đó vẫn có thể xuất hiện trên Google nếu có các trang khác liên kết đến nó. Để hiểu rõ hơn về cách ngăn chặn triệt để một trang xuất hiện trên kết quả tìm kiếm, bạn nên xem xét việc phân biệt giữa file robots.txt và thẻ meta robots để áp dụng đúng kỹ thuật cho từng trường hợp cụ thể.
Cách kiểm tra file robots.txt bằng Google Search Console
Sau khi tạo và tải tệp lên website, bước bắt buộc tiếp theo là xác minh xem tệp đã hoạt động chính xác hay chưa. Google Search Console cung cấp một công cụ kiểm tra chuyên dụng giúp bạn phát hiện lỗi cú pháp và mô phỏng cách Googlebot đọc tệp.
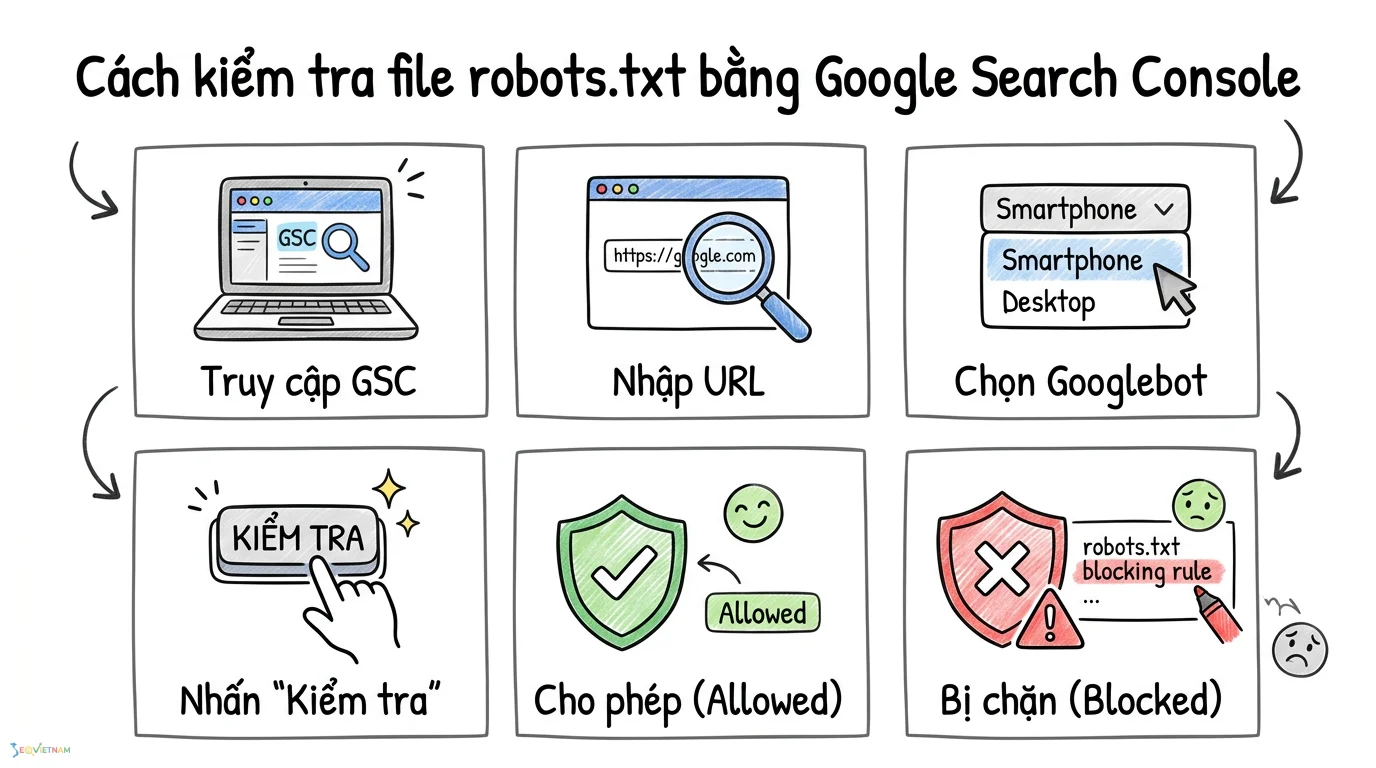
Đầu tiên, hãy truy cập vào Google Search Console và mở công cụ kiểm tra robots.txt. Công cụ này sẽ hiển thị nội dung tệp hiện tại mà Google đang nhận diện. Bạn có thể nhập một URL bất kỳ của website vào ô kiểm tra ở cuối trang, chọn loại Googlebot (ví dụ: Googlebot Smartphone) và nhấn nút Kiểm tra. Nếu kết quả trả về là "Đã cho phép" (Allowed), URL đó hoàn toàn bình thường. Nếu trả về "Bị chặn" (Blocked), công cụ sẽ bôi đỏ dòng lệnh đang gây ra việc chặn đó để bạn dễ dàng khắc phục.
Câu hỏi thường gặp (FAQ)
File robots.txt nằm ở đâu trên website?
Tệp robots.txt luôn được đặt ở thư mục gốc (root directory) của website. Bạn có thể xem trực tiếp tệp này bằng cách gõ tên miền của bạn kèm theo hậu tố /robots.txt trên thanh địa chỉ trình duyệt.
Tôi có bắt buộc phải có file robots.txt không?
Không bắt buộc nhưng cực kỳ khuyến khích. Nếu không có tệp này, Googlebot sẽ mặc định thu thập toàn bộ dữ liệu trên website của bạn. Tuy nhiên, đối với các trang web lớn, việc thiếu robots.txt sẽ dẫn đến lãng phí ngân sách thu thập dữ liệu vào các trang không quan trọng.
Sự khác biệt giữa robots.txt và sitemap.xml là gì?
Tệp robots.txt đóng vai trò như một biển báo cấm, chỉ định những nơi bot không được phép đi vào. Ngược lại, sitemap.xml là một bản đồ hướng dẫn, liệt kê tất cả các trang quan trọng mà bạn muốn bot tìm kiếm khám phá và lập chỉ mục.
Có nên chặn Googlebot trong robots.txt không?
Bạn chỉ nên chặn Googlebot đối với các trang không mang lại giá trị SEO như trang đăng nhập, giỏ hàng, kết quả tìm kiếm nội bộ hoặc các trang đang trong quá trình thử nghiệm. Tuyệt đối không chặn các trang bài viết, sản phẩm hoặc danh mục mà bạn muốn xếp hạng.
Làm sao để xử lý lỗi 403 forbidden hoặc 404 not found với robots.txt?
Lỗi 404 Not Found xảy ra khi tệp chưa được tạo hoặc tải lên sai thư mục. Hãy đảm bảo tệp nằm đúng ở thư mục public_html. Lỗi 403 Forbidden thường do phân quyền tệp (file permissions) trên máy chủ bị sai. Bạn cần thiết lập quyền của tệp robots.txt thành 644 thông qua File Manager hoặc FTP để bot có thể đọc được.
Kết luận
Tạo file robots.txt chuẩn SEO là một kỹ thuật nền tảng giúp bạn kiểm soát hoàn toàn cách các công cụ tìm kiếm tương tác với website. Bằng cách sử dụng đúng các lệnh Disallow và Allow, kết hợp với việc khai báo Sitemap rõ ràng, bạn sẽ tối ưu hóa được quá trình thu thập dữ liệu và nâng cao hiệu suất SEO tổng thể. Sau khi áp dụng các mẫu cấu hình phù hợp với nền tảng CMS của mình, hãy luôn nhớ kiểm tra lại bằng Google Search Console để đảm bảo không có bất kỳ URL quan trọng nào bị chặn nhầm. Bước tiếp theo, hãy rà soát lại cấu trúc sitemap của bạn để tạo ra một luồng thu thập dữ liệu hoàn hảo nhất cho Googlebot.
Bài viết liên quan
https://seovietnam.vn/nofollow-la-gi-meta-robots/