Khi quản trị một website, việc kiểm soát cách các công cụ tìm kiếm thu thập dữ liệu là vô cùng quan trọng. Lệnh Disallow trong file robots.txt chính là công cụ mạnh mẽ nhất giúp bạn chỉ định rõ những phần nào của trang web không nên được Googlebot hay các trình thu thập dữ liệu khác truy cập. Tuy nhiên, nếu cấu hình sai cú pháp, bạn có thể vô tình chặn nhầm các dữ liệu quan trọng, gây ảnh hưởng nghiêm trọng đến thứ hạng SEO. Bài viết này sẽ hướng dẫn chi tiết cách sử dụng lệnh Disallow chuẩn xác, an toàn và tối ưu nhất cho website của bạn.
Robots.txt là gì?
File robots.txt là một tập tin văn bản đơn giản được đặt ở thư mục gốc của website. Nó hoạt động dựa trên tiêu chuẩn Robots Exclusion Protocol, đóng vai trò như một người gác cổng, đưa ra các chỉ thị để hướng dẫn bot của công cụ tìm kiếm biết chúng được phép hoặc không được phép thu thập dữ liệu ở những khu vực nào.
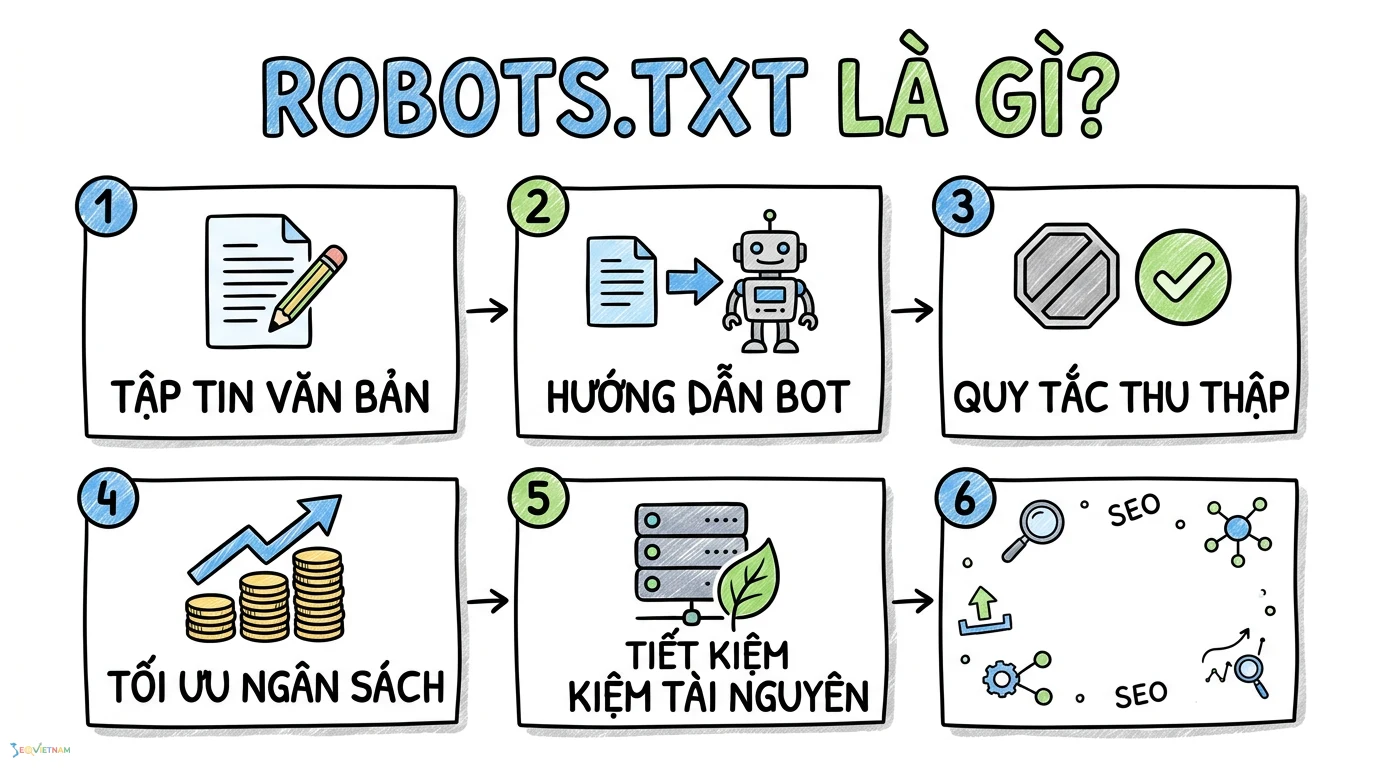
Việc nắm rõ cấu trúc cơ bản của file robots.txt sẽ giúp bạn dễ dàng thiết lập các quy tắc thu thập dữ liệu một cách chính xác, từ đó tối ưu hóa ngân sách thu thập dữ liệu (crawl budget) cho các trang quan trọng và tránh lãng phí tài nguyên máy chủ.
Lệnh Disallow trong robots.txt là gì?
Lệnh Disallow là một chỉ thị cốt lõi bên trong file robots.txt, được sử dụng để yêu cầu các trình thu thập dữ liệu không truy cập, cào dữ liệu (crawl) ở một URL, thư mục hoặc một loại tệp cụ thể trên website.
Khi bạn khai báo lệnh này, bot tìm kiếm sẽ bỏ qua đường dẫn được chỉ định, giúp bảo vệ các trang chứa thông tin nội bộ, trang quản trị, hoặc các trang có nội dung trùng lặp. Tuy nhiên, cần lưu ý rằng Disallow chỉ ngăn việc thu thập dữ liệu chứ không hoàn toàn ngăn chặn trang đó xuất hiện trên kết quả tìm kiếm (Index) nếu có các liên kết từ bên ngoài trỏ đến nó.
Cú pháp và cách sử dụng Disallow chuẩn SEO
Để lệnh Disallow hoạt động hiệu quả, bạn cần tuân thủ đúng cú pháp kỹ thuật. Một sai sót nhỏ như thiếu dấu gạch chéo cũng có thể làm thay đổi hoàn toàn ý nghĩa của câu lệnh.
Cú pháp cơ bản của lệnh Disallow
Một khối lệnh trong robots.txt luôn bắt đầu bằng việc xác định đối tượng áp dụng thông qua User-agent, sau đó mới đến các chỉ thị Disallow. Bên cạnh đó, bạn cũng có thể khai báo thêm Sitemap để hỗ trợ bot lập bản đồ trang web, hoặc Crawl-delay để kiểm soát tốc độ thu thập dữ liệu.
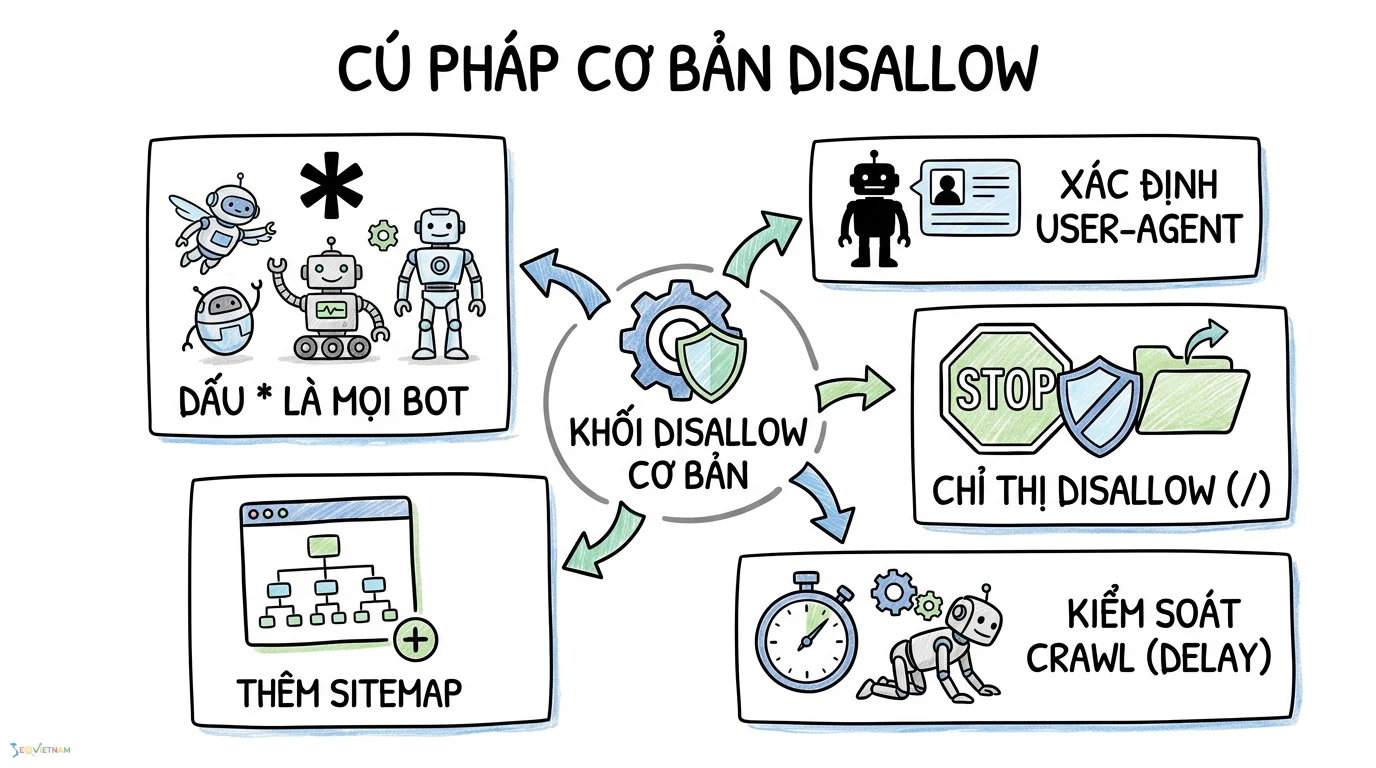
User-agent: * Disallow: /thu-muc-can-chan/ Sitemap: https://domain.com/sitemap.xml
Trong ví dụ trên, dấu sao (*) đại diện cho tất cả các loại bot. Lệnh Disallow chỉ định rằng không có bất kỳ bot nào được phép truy cập vào nội dung bên trong "thu-muc-can-chan".
Ví dụ chặn một thư mục cụ thể
Đối với các website sử dụng mã nguồn phổ biến như WordPress, việc chặn bot truy cập vào khu vực quản trị là một thao tác cơ bản để bảo mật và tiết kiệm ngân sách cào dữ liệu. Dưới đây là mẫu cấu hình chuẩn bạn có thể sao chép và áp dụng:
User-agent: Googlebot Disallow: /wp-admin/ Disallow: /readme.html
Đoạn mã này chỉ định đích danh Googlebot và yêu cầu nó không được phép thu thập dữ liệu bên trong thư mục quản trị wp-admin cũng như tệp tin readme.html.
Kết hợp Disallow và Allow
Trong nhiều trường hợp, bạn muốn chặn toàn bộ một thư mục nhưng lại muốn ngoại trừ một tệp tin cụ thể bên trong thư mục đó. Lúc này, bạn cần kết hợp thêm lệnh Allow. Việc hiểu rõ cách sử dụng lệnh allow để cấp quyền truy cập cho bot sẽ giúp bạn xử lý các tình huống cấu hình phức tạp, đảm bảo Googlebot vẫn đọc được các tài nguyên cần thiết.
User-agent: * Disallow: /wp-admin/ Allow: /wp-admin/admin-ajax.php
Cấu hình này chặn toàn bộ thư mục wp-admin nhưng vẫn cho phép bot truy cập vào tệp admin-ajax.php, một tệp thường xuyên được các plugin sử dụng để hiển thị nội dung động trên giao diện người dùng.
Những lưu ý quan trọng khi dùng Disallow
Sử dụng sai lệnh Disallow có thể dẫn đến thảm họa SEO khi toàn bộ website bị rớt hạng do Googlebot không thể truy cập. Dưới đây là những nguyên tắc và rủi ro bạn bắt buộc phải kiểm soát.
|
Lỗi cấu hình phổ biến |
Hậu quả đối với SEO |
Cách khắc phục chuẩn xác |
|
Disallow: / |
Chặn toàn bộ website, mất index hàng loạt trên Google |
Xóa dấu gạch chéo nếu muốn bot truy cập toàn trang |
|
Chặn file CSS và JS |
Googlebot không thể hiển thị (render) trang chính xác, đánh giá sai giao diện |
Sử dụng lệnh Allow cho các thư mục chứa CSS/JS |
|
Dùng Disallow để bảo mật |
Thông tin nhạy cảm vẫn có thể bị lộ nếu có link trỏ tới |
Sử dụng mật khẩu bảo vệ ở cấp độ máy chủ |
Phân biệt Disallow và các thẻ kiểm soát index khác
Rất nhiều quản trị viên nhầm lẫn giữa việc chặn thu thập dữ liệu (crawl) và chặn lập chỉ mục (index). Lệnh Disallow trong robots.txt chỉ ngăn bot cào dữ liệu URL đó. Nếu URL này được liên kết từ một trang web khác, Google vẫn có thể lập chỉ mục nó với một tiêu đề chung chung mà không có phần mô tả.
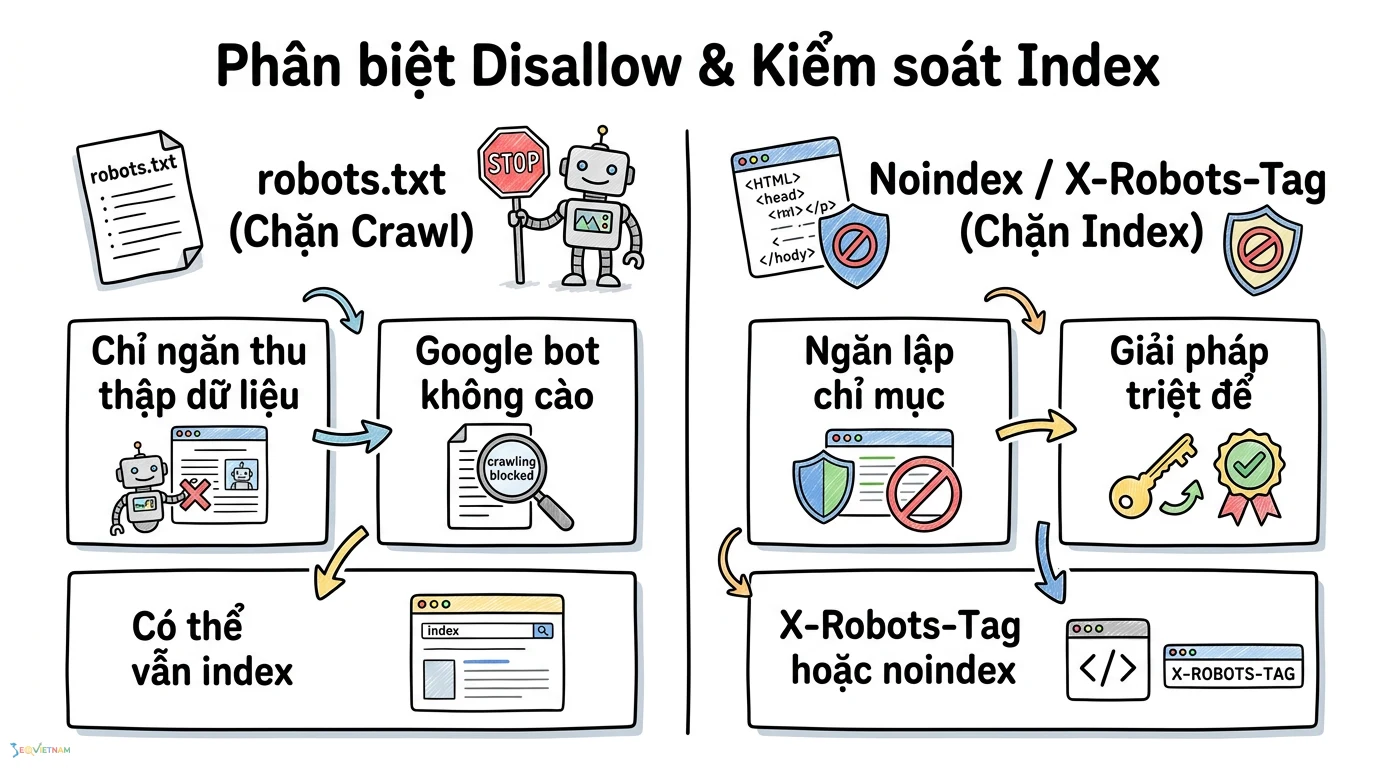
Để giải quyết triệt để việc không cho trang xuất hiện trên kết quả tìm kiếm, bạn cần tìm hiểu X-robots-tag là gì hoặc sử dụng thẻ meta robots mang giá trị noindex trực tiếp trên mã HTML của trang thay vì chỉ phụ thuộc vào Disallow.
Câu hỏi thường gặp về lệnh Disallow
Lệnh Disallow có chặn hoàn toàn việc index không?
Không. Disallow chỉ chặn quá trình cào dữ liệu. Nếu trang của bạn có backlink từ các nguồn khác trỏ về, Google vẫn có thể index URL đó. Để chặn index hoàn toàn, bạn phải dùng thẻ noindex.
Tôi có thể dùng Disallow cho tất cả các bot không?
Có. Bằng cách sử dụng dấu sao ở phần User-agent (User-agent: *), chỉ thị Disallow của bạn sẽ được áp dụng cho mọi trình thu thập dữ liệu từ các công cụ tìm kiếm khác nhau.
Sự khác biệt giữa Disallow và Allow là gì?
Disallow yêu cầu bot không được phép truy cập vào một đường dẫn cụ thể, trong khi Allow cấp quyền truy cập. Allow thường được dùng để tạo ngoại lệ ưu tiên bên trong một thư mục đã bị chặn bởi Disallow.
Có nên chặn wp-admin trong robots.txt không?
Rất nên. Thư mục wp-admin chứa các tệp tin quản trị nội bộ của WordPress. Việc dùng Disallow cho thư mục này giúp tiết kiệm crawl budget và tránh việc bot lập chỉ mục các trang đăng nhập không cần thiết.
Làm thế nào để kiểm tra lệnh Disallow đã hoạt động đúng chưa?
Bạn nên sử dụng công cụ kiểm tra robots.txt (Robots.txt Tester) bên trong Google Search Console. Công cụ này cho phép bạn nhập một URL bất kỳ để xem liệu Googlebot có bị chặn bởi các lệnh Disallow hiện tại hay không, giúp phát hiện lỗi trước khi ảnh hưởng đến SEO.
Kết luận
Lệnh Disallow trong file robots.txt là một thành phần không thể thiếu trong chiến lược SEO kỹ thuật. Nó giúp bạn điều hướng các trình thu thập dữ liệu một cách thông minh, bảo vệ tài nguyên máy chủ và tối ưu hóa ngân sách cào dữ liệu cho những nội dung thực sự quan trọng. Tuy nhiên, sức mạnh luôn đi kèm với rủi ro. Hãy luôn kiểm tra kỹ lưỡng cú pháp và sử dụng các công cụ hỗ trợ từ Google Search Console trước khi áp dụng bất kỳ thay đổi nào lên môi trường thực tế. Việc hiểu đúng và làm chuẩn ngay từ đầu sẽ giúp website của bạn phát triển bền vững trên các công cụ tìm kiếm.
Bài viết liên quan
https://seovietnam.vn/google-dien-giai-robotstxt-nhu-the-nao/