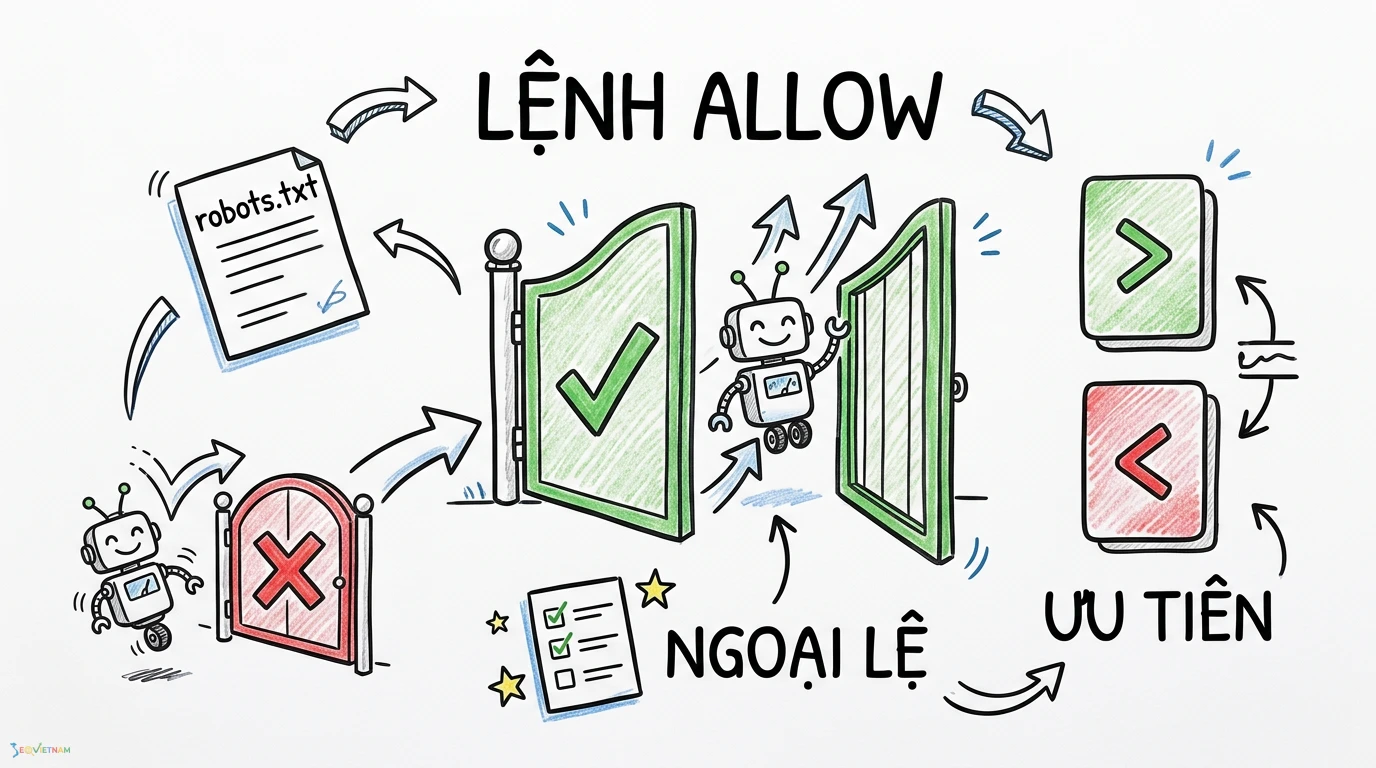
Khi quản trị một trang web, việc kiểm soát cách các công cụ tìm kiếm thu thập dữ liệu là bước tối quan trọng để tối ưu hóa ngân sách cào (crawl budget) và bảo mật thông tin. Thông thường, các quản trị viên web sử dụng lệnh Disallow để chặn bot truy cập vào các khu vực không mong muốn. Tuy nhiên, trong nhiều tình huống thực tế, bạn cần chặn một thư mục lớn nhưng lại muốn mở quyền truy cập cho một tệp tin cụ thể nằm bên trong thư mục đó. Đây chính là lúc lệnh Allow phát huy tác dụng. Bằng cách hoạt động như một quy tắc ngoại lệ, lệnh này cung cấp khả năng kiểm soát chi tiết, đảm bảo Googlebot có thể tiếp cận chính xác những tài nguyên cần thiết để đánh giá trang web của bạn.
Lệnh Allow trong robots.txt là gì?
Lệnh Allow là một chỉ thị được sử dụng bên trong tệp robots.txt nhằm cho phép các trình thu thập dữ liệu của công cụ tìm kiếm (như Googlebot) truy cập vào một đường dẫn URL hoặc một thư mục cụ thể.
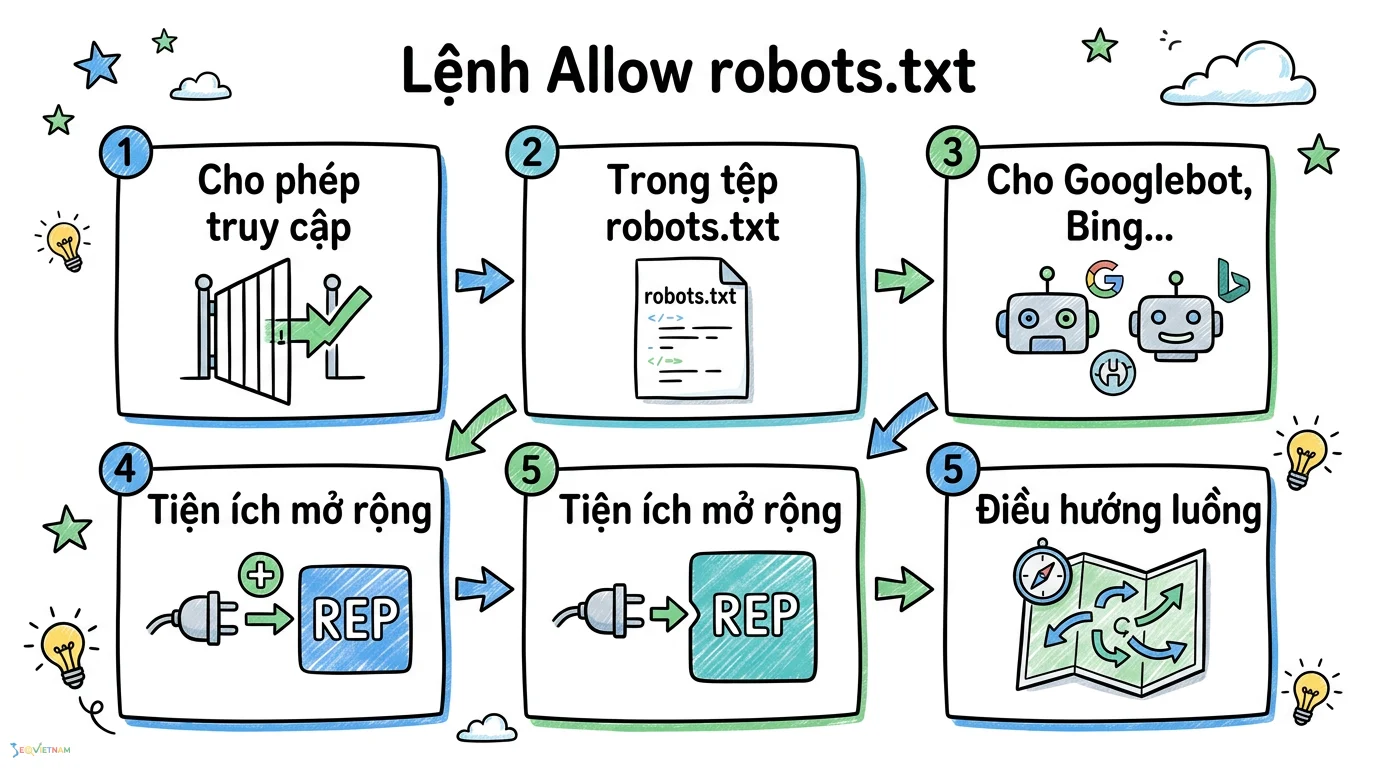
Về mặt lịch sử, tiêu chuẩn Robots Exclusion Protocol (REP) ban đầu chỉ định nghĩa lệnh Disallow để ngăn chặn việc cào dữ liệu. Tuy nhiên, khi các trang web trở nên phức tạp hơn, các công cụ tìm kiếm lớn như Google và Bing đã giới thiệu thêm lệnh Allow như một tiện ích mở rộng. Để nắm bắt cách lệnh này tương tác với toàn bộ hệ thống, bạn cần hiểu rõ về file robots.txt là gì và cách nó điều hướng luồng thu thập dữ liệu của các công cụ tìm kiếm.
Tại sao cần sử dụng lệnh Allow?
Mục đích duy nhất và quan trọng nhất của lệnh Allow là tạo ra một ngoại lệ cho một quy tắc Disallow rộng hơn. Theo mặc định, nếu không có bất kỳ lệnh chặn nào, các công cụ tìm kiếm sẽ tự động thu thập mọi dữ liệu mà chúng tìm thấy. Do đó, việc sử dụng Allow đứng độc lập (không đi kèm Disallow) là hoàn toàn vô nghĩa.
Bạn sẽ cần sử dụng lệnh Allow trong các trường hợp sau:
- Chặn bot cào toàn bộ thư mục quản trị nhưng cho phép cào một thư mục chứa hình ảnh công khai nằm trong đó.
- Chặn thu thập dữ liệu các trang tìm kiếm nội bộ nhưng cho phép cào một trang kết quả tìm kiếm đã được tối ưu hóa đặc biệt.
- Mở khóa các tệp tài nguyên tĩnh. Một trường hợp rất phổ biến trong SEO kỹ thuật là chặn thư mục giao diện nhưng vẫn phải dùng lệnh Allow để mở quyền truy cập cho các tệp tài nguyên, nhằm tránh những ảnh hưởng khi robots.txt chặn file CSS và JS làm giảm điểm trải nghiệm trang.
So sánh lệnh Allow và Disallow
Để hiểu rõ hơn về vai trò của từng lệnh, bảng dưới đây sẽ so sánh các đặc điểm cốt lõi giữa Allow và Disallow trong quá trình điều hướng bot.
|
Tiêu chí |
Lệnh Allow |
Lệnh Disallow |
|
Chức năng chính |
Cho phép bot truy cập một đường dẫn cụ thể. |
Ngăn chặn bot truy cập một đường dẫn cụ thể. |
|
Trạng thái mặc định |
Không cần khai báo nếu không có lệnh chặn trước đó. |
Phải khai báo rõ ràng để bot biết không được phép cào. |
|
Ứng dụng thực tế |
Tạo ngoại lệ chi tiết bên trong một khu vực đã bị chặn. |
Bảo vệ các trang quản trị, trang trùng lặp hoặc dữ liệu nhạy cảm. |
Cách hoạt động và quy tắc ưu tiên của Allow và Disallow
Khi bạn kết hợp cả hai lệnh trong cùng một tệp robots.txt, các công cụ tìm kiếm cần một bộ quy tắc để quyết định xem nên tuân theo lệnh nào. Theo tài liệu chính thức của Google về robots.txt, quy tắc ưu tiên được xác định dựa trên độ dài của đường dẫn (path length).
Cụ thể, quy tắc có đường dẫn dài hơn và cụ thể hơn sẽ giành chiến thắng. Nếu cả hai lệnh có cùng độ dài đường dẫn áp dụng cho cùng một URL, Googlebot thường sẽ ưu tiên lệnh ít hạn chế hơn, tức là lệnh Allow.
Dưới đây là một ví dụ mã lệnh minh họa cho quy tắc ưu tiên:
User-agent: Googlebot
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Trong ví dụ trên, thư mục /wp-admin/ bị chặn hoàn toàn. Tuy nhiên, tệp /wp-admin/admin-ajax.php lại được phép thu thập dữ liệu. Đường dẫn của lệnh Allow dài hơn và chi tiết hơn đường dẫn của lệnh Disallow, do đó Googlebot sẽ áp dụng ngoại lệ này thành công.
Mẹo chuyên gia: Luôn kiểm tra kỹ số lượng ký tự trong chuỗi đường dẫn của bạn. Nếu bạn khai báo Disallow: /folder/ (8 ký tự) và Allow: /folder/file.html (17 ký tự), bot sẽ hiểu ngay tệp file.html là một ngoại lệ hợp lệ.
Cần lưu ý rằng việc cho phép hoặc chặn cào dữ liệu bằng các lệnh này hoàn toàn khác với việc kiểm soát lập chỉ mục; bạn có thể xem thêm cách phân biệt robots.txt và noindex trong kiểm soát crawl để thiết lập chiến lược SEO kỹ thuật chính xác nhất.
Những lưu ý kỹ thuật khi cấu hình lệnh Allow
Việc thiết lập tệp robots.txt đòi hỏi sự cẩn trọng cao, bởi một sai sót nhỏ cũng có thể khiến các trang quan trọng không thể xuất hiện trên kết quả tìm kiếm.
Khả năng hỗ trợ của các User-agent khác nhau
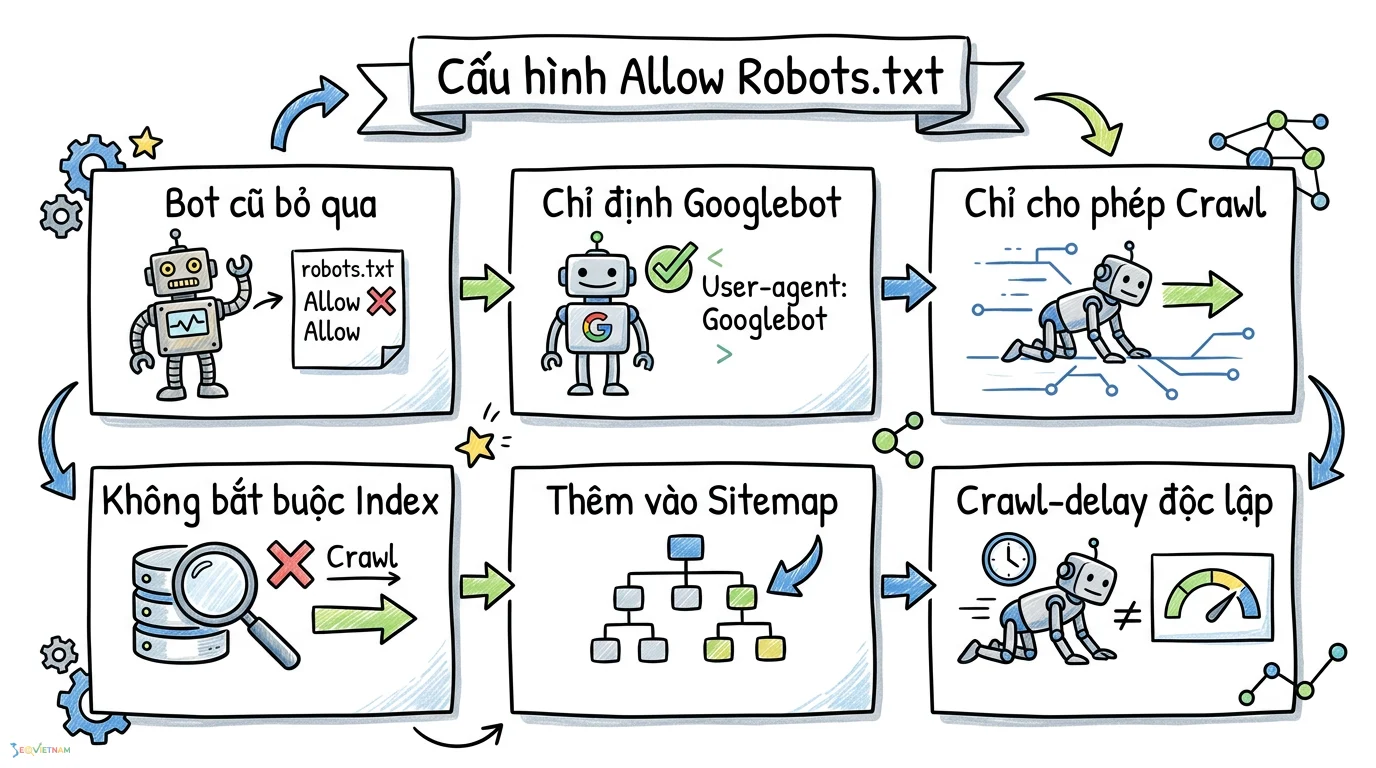
Mặc dù Googlebot và Bingbot hỗ trợ lệnh Allow một cách hoàn hảo, bạn không nên mặc định rằng mọi trình thu thập dữ liệu đều hiểu lệnh này. Một số bot cũ hoặc các bot thu thập dữ liệu độc lập tuân thủ nghiêm ngặt chuẩn REP nguyên thủy có thể bỏ qua lệnh Allow và chỉ thực thi lệnh Disallow. Do đó, hãy luôn chỉ định rõ User-agent: Googlebot hoặc các bot cụ thể nếu bạn đang sử dụng các quy tắc ngoại lệ phức tạp.
Tác động đến Sitemap và Crawl-delay
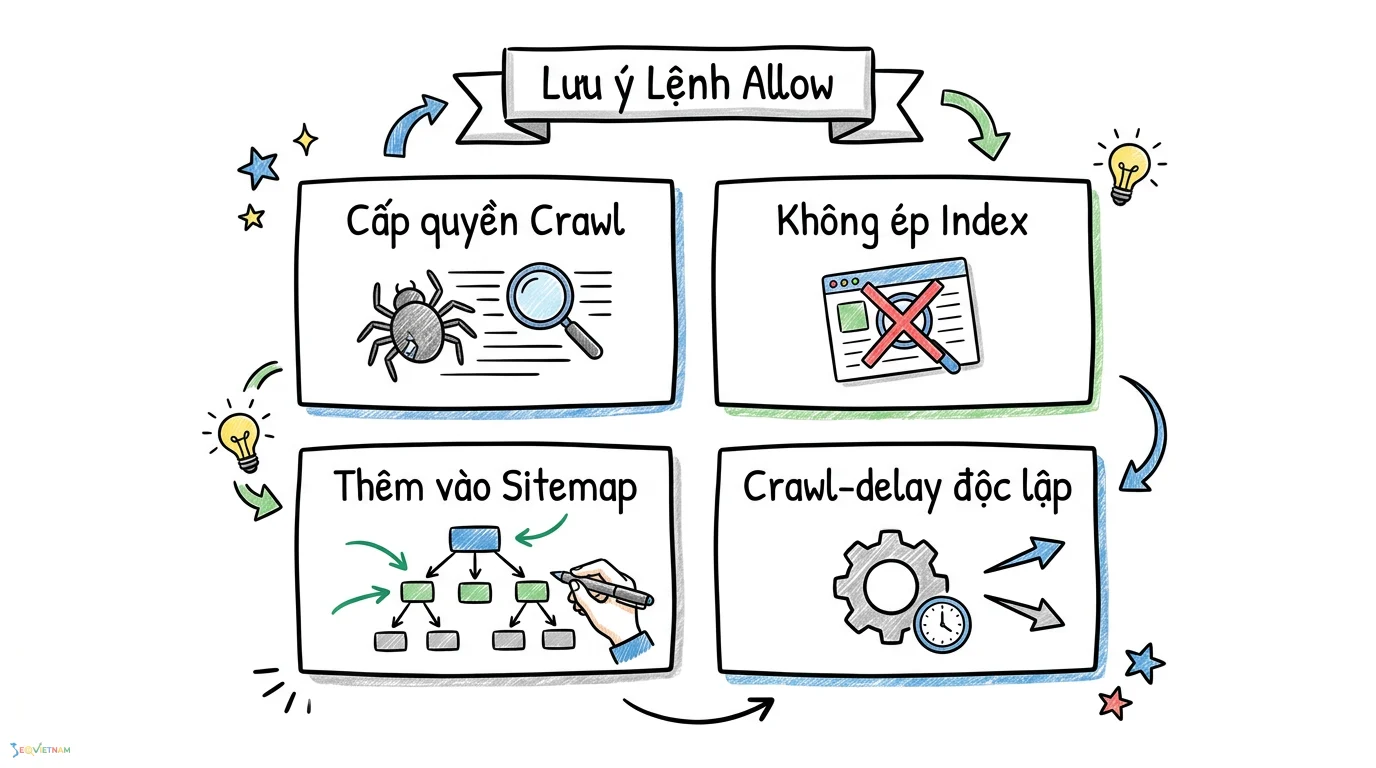
Lệnh Allow chỉ cấp quyền thu thập dữ liệu (crawl), nó không ép buộc công cụ tìm kiếm phải lập chỉ mục (index) trang đó. Đường dẫn được Allow nên xuất hiện trong Sitemap của bạn để khuyến khích bot cào dữ liệu nhanh hơn. Ngoài ra, các chỉ thị khác như Crawl-delay (được Bing và Yandex hỗ trợ để làm chậm tốc độ cào) hoạt động hoàn toàn độc lập và không bị ảnh hưởng bởi việc bạn dùng lệnh Allow hay Disallow.
Câu hỏi thường gặp về lệnh Allow
Lệnh Allow có được tất cả các bot hỗ trợ không?
Không. Lệnh Allow là một tiện ích mở rộng không chính thức của tiêu chuẩn REP ban đầu. Mặc dù các bot lớn như Googlebot và Bingbot hỗ trợ hoàn toàn, một số trình thu thập dữ liệu cũ hoặc bot rác có thể bỏ qua lệnh này và chỉ tuân thủ lệnh chặn.
Nếu dùng cả Allow và Disallow cho cùng một đường dẫn thì sao?
Theo tài liệu chính thức của Google, nếu hai lệnh có cùng độ dài đường dẫn và áp dụng cho chính xác cùng một URL, lệnh ít hạn chế hơn (Allow) sẽ được ưu tiên. Tuy nhiên, để tránh xung đột và đảm bảo tính rõ ràng, bạn nên thiết lập đường dẫn Allow cụ thể và dài hơn.
Có nên dùng Allow để cho phép truy cập toàn bộ website không?
Việc này là không cần thiết. Theo mặc định, các công cụ tìm kiếm đã được phép thu thập dữ liệu toàn bộ trang web của bạn. Việc viết Allow: / là dư thừa trừ khi bạn đang muốn ghi đè một lệnh Disallow: / đã được khai báo trước đó cho một nhóm bot cụ thể.
Sự khác biệt cốt lõi giữa Allow và Disallow là gì?
Disallow dùng để thiết lập rào chắn, ngăn bot truy cập vào một thư mục hoặc tệp cụ thể. Ngược lại, Allow được sử dụng để tạo ra một "cửa ngách" cho một tệp hoặc thư mục con nằm bên trong vùng đã bị Disallow chặn trước đó.
Googlebot có hỗ trợ lệnh Allow không?
Có, Googlebot hỗ trợ lệnh Allow một cách hoàn chỉnh. Google thậm chí còn khuyến khích sử dụng lệnh này để mở khóa các tệp tài nguyên quan trọng như CSS, JavaScript hoặc hình ảnh nằm trong các thư mục đang bị chặn, giúp bot hiển thị và hiểu rõ hơn về giao diện trang web.
Kết luận
Lệnh Allow trong robots.txt là một công cụ kỹ thuật mạnh mẽ giúp các chuyên gia SEO tinh chỉnh luồng thu thập dữ liệu của Googlebot. Bằng cách hiểu rõ quy tắc ưu tiên dựa trên độ dài đường dẫn, bạn có thể dễ dàng bảo vệ các khu vực nhạy cảm của website bằng Disallow mà không vô tình chặn mất các tài nguyên quan trọng cần thiết cho việc hiển thị trang. Nếu bạn không chắc chắn về cấu hình hiện tại của mình, hãy cân nhắc sử dụng các công cụ kiểm tra robots.txt của Google hoặc yêu cầu một dịch vụ Audit SEO kỹ thuật chuyên sâu để đảm bảo website luôn thân thiện với công cụ tìm kiếm.
Bài viết liên quan
https://seovietnam.vn/cach-tao-file-robotstxt/