Khi quản trị một website, việc kiểm soát cách các công cụ tìm kiếm thu thập dữ liệu và lập chỉ mục là vô cùng quan trọng. Đối với các trang HTML thông thường, thẻ meta robots là giải pháp phổ biến. Tuy nhiên, khi bạn cần ngăn Google lập chỉ mục các tệp không phải HTML như PDF, hình ảnh, hoặc video, X-Robots-Tag chính là công cụ kỹ thuật SEO mạnh mẽ nhất. Bài viết này sẽ giúp bạn hiểu rõ bản chất của HTTP Header này, đồng thời cung cấp hướng dẫn cấu hình chi tiết trên máy chủ Apache và Nginx để tối ưu hóa ngân sách thu thập dữ liệu.
X-Robots-Tag là gì?
X-Robots-Tag là một thành phần của phản hồi HTTP Header (tiêu đề HTTP) được máy chủ web gửi đến trình duyệt hoặc các bot tìm kiếm như Googlebot. Chức năng chính của nó là cung cấp các chỉ thị thu thập dữ liệu và lập chỉ mục, chẳng hạn như noindex hoặc nofollow, cho một URL cụ thể ở cấp độ máy chủ (server-side).
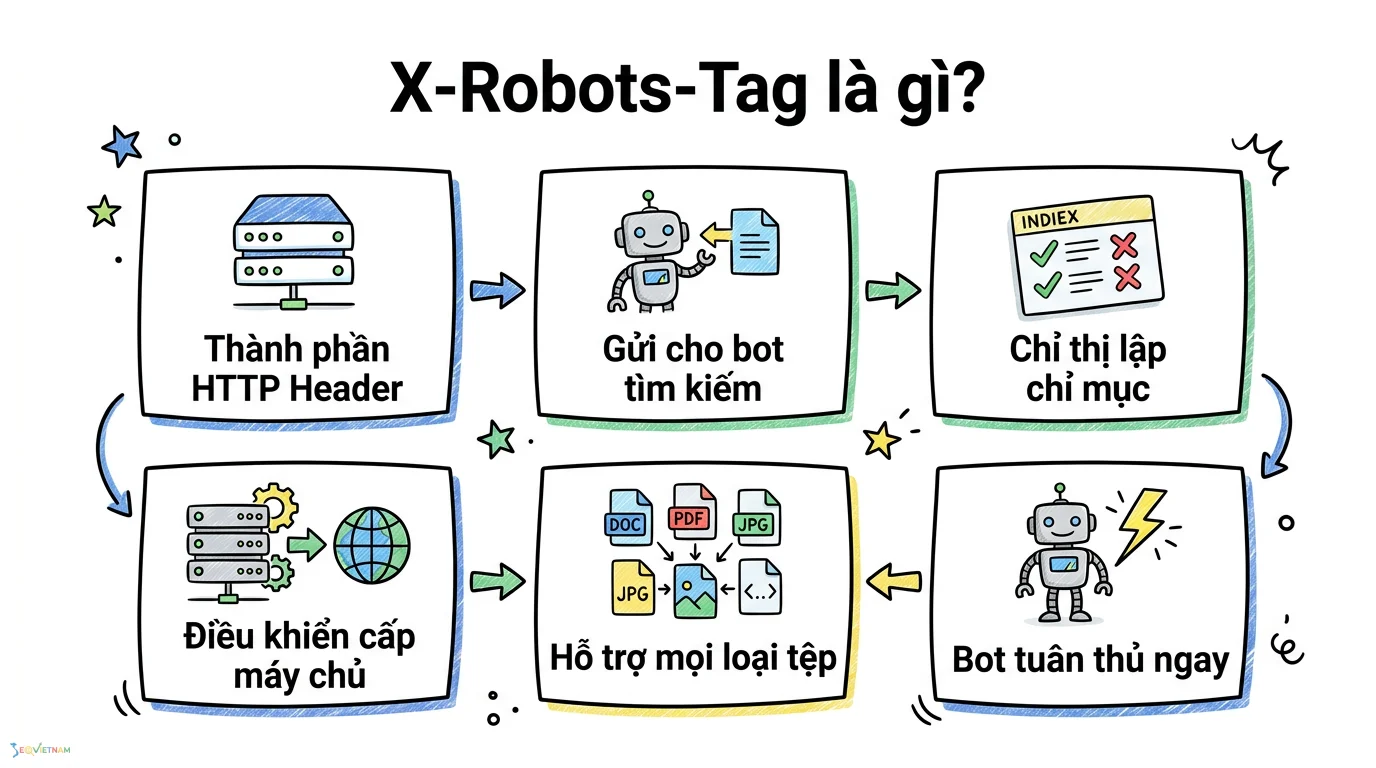
Theo tài liệu từ Google Search Central, X-Robots-Tag có thể được sử dụng cho bất kỳ loại tệp nào, không chỉ giới hạn ở các trang web định dạng HTML. Khi Googlebot gửi yêu cầu truy cập một tài nguyên, máy chủ sẽ trả về HTTP Header trước khi tải nội dung thực tế. Nếu phát hiện chỉ thị chặn lập chỉ mục trong tiêu đề này, bot sẽ tuân thủ ngay lập tức mà không cần phải phân tích toàn bộ nội dung tệp.
Dưới đây là một ví dụ về phản hồi HTTP Header hợp lệ có chứa X-Robots-Tag yêu cầu công cụ tìm kiếm không lập chỉ mục và không theo dõi các liên kết:
HTTP/1.1 200 OK
Date: Tue, 25 May 2025 21:42:43 GMT
X-Robots-Tag: noindex, nofollow
Tại sao cần sử dụng X-Robots-Tag trong SEO?
Việc triển khai X-Robots-Tag mang lại những lợi thế kỹ thuật đặc thù mà các phương pháp kiểm soát lập chỉ mục khác không thể đáp ứng được, đặc biệt là đối với các website có cấu trúc phức tạp.
Lý do phổ biến nhất là để quản lý các tệp tin không phải HTML. Bạn không thể chèn mã HTML vào một tệp PDF, tài liệu Word hay một bức ảnh. Nếu bạn có các tài liệu nội bộ, hóa đơn PDF hoặc hình ảnh bản quyền trên máy chủ và không muốn chúng xuất hiện trên kết quả tìm kiếm, việc cấu hình thông qua X-Robots-Tag là phương pháp duy nhất để gán thẻ noindex cho chúng.
Bên cạnh đó, phương pháp này cho phép áp dụng các quy tắc hàng loạt trên toàn bộ trang web. Thay vì phải chỉnh sửa mã nguồn của từng trang riêng lẻ, bạn có thể thiết lập một quy tắc duy nhất trên máy chủ để chặn lập chỉ mục toàn bộ một thư mục cụ thể. Điều này đặc biệt hữu ích khi bạn đang xây dựng chiến lược phân loại nội dung, tương tự như việc cân nhắc khi nào dùng noindex cho tag category để tránh lỗi trùng lặp nội dung trên các hệ thống quản trị nội dung lớn.
So sánh X-Robots-Tag, meta robots và robots.txt
Để triển khai SEO kỹ thuật chính xác, bạn cần phân biệt rõ vai trò của ba công cụ kiểm soát bot phổ biến nhất hiện nay. Việc sử dụng sai công cụ có thể dẫn đến việc trang web bị rớt hạng hoặc rò rỉ dữ liệu không mong muốn.
|
Tiêu chí |
X-Robots-Tag |
Meta Robots |
Robots.txt |
|
Vị trí đặt |
Phản hồi HTTP Header (Server-side) |
Trong phần head của mã HTML |
Tệp văn bản ở thư mục gốc |
|
Đối tượng áp dụng |
Mọi loại tệp (HTML, PDF, Image, Video) |
Chỉ dành cho trang HTML |
Toàn bộ website hoặc thư mục |
|
Chức năng chính |
Kiểm soát lập chỉ mục (Index) |
Kiểm soát lập chỉ mục (Index) |
Kiểm soát thu thập dữ liệu (Crawl) |
|
Khả năng xóa index |
Có thể xóa URL khỏi kết quả tìm kiếm |
Có thể xóa URL khỏi kết quả tìm kiếm |
Không thể xóa URL đã được index |
Sự khác biệt lớn nhất nằm ở cơ chế hoạt động. Tệp robots.txt đóng vai trò như một rào chắn ngăn bot truy cập. Nếu bạn muốn tìm hiểu sâu hơn về cách chặn bot hiệu quả, bạn có thể tham khảo cách thiết lập lệnh disallow trong robots.txt để chặn bot để đảm bảo không thiết lập sai quy tắc. Tuy nhiên, robots.txt không thể xóa một trang đã được lập chỉ mục khỏi kết quả tìm kiếm nếu trang đó được liên kết từ một nguồn khác.
Ngược lại, X-Robots-Tag và Meta Robots đưa ra chỉ thị trực tiếp về việc có được phép hiển thị trên kết quả tìm kiếm hay không. Để hiểu rõ hơn về cách các công cụ tìm kiếm xử lý các tệp tin này, việc nắm bắt google diễn giải robots txt như thế nào sẽ giúp bạn tránh được tình trạng xung đột giữa các chỉ thị kỹ thuật, đảm bảo Googlebot luôn nhận được thông điệp nhất quán.
Hướng dẫn cấu hình X-Robots-Tag trên máy chủ
Việc thiết lập X-Robots-Tag yêu cầu quyền truy cập vào tệp cấu hình của máy chủ web. Dưới đây là các đoạn mã chuẩn xác mà bạn có thể sao chép và áp dụng cho hai môi trường máy chủ phổ biến nhất.
Cấu hình trên máy chủ Apache
Đối với máy chủ sử dụng Apache, bạn sẽ cần chỉnh sửa tệp .htaccess nằm ở thư mục gốc của website.
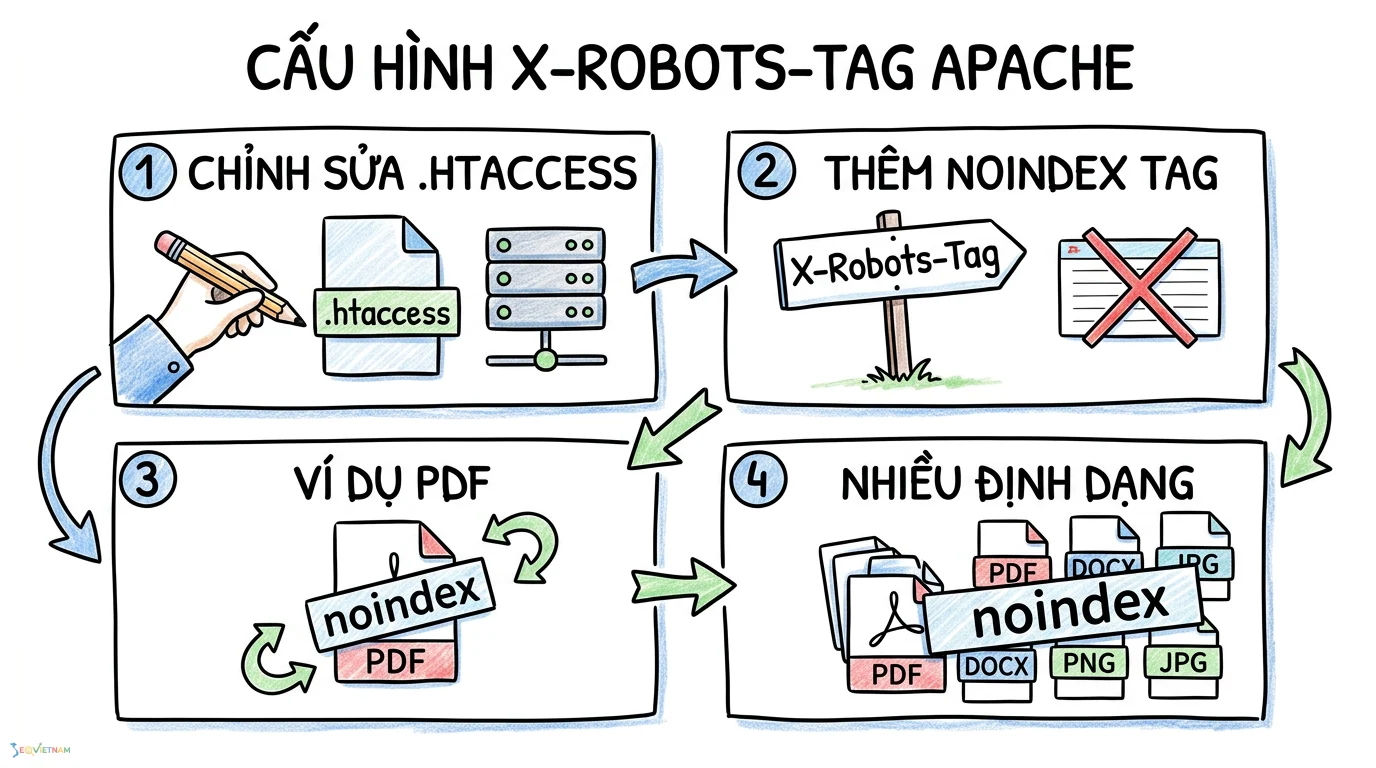
Nếu bạn muốn thêm thẻ noindex cho toàn bộ các tệp PDF trên trang web, hãy thêm đoạn mã sau vào tệp .htaccess:
<FilesMatch "\.(pdf)$">
Header set X-Robots-Tag "noindex, nofollow"
</FilesMatch>
Bạn cũng có thể mở rộng quy tắc này cho nhiều định dạng tệp khác nhau như hình ảnh hoặc tài liệu văn bản bằng cách điều chỉnh biểu thức chính quy:
<FilesMatch "\.(doc|docx|pdf|png|jpg|jpeg|gif)$">
Header set X-Robots-Tag "noindex"
</FilesMatch>
Cấu hình trên máy chủ Nginx
Máy chủ Nginx không sử dụng tệp .htaccess. Thay vào đó, bạn cần chỉnh sửa tệp cấu hình chính của trang web (thường là nginx.conf hoặc tệp cấu hình trong thư mục sites-available).
Để thêm chỉ thị noindex cho các tệp PDF trên Nginx, hãy thêm khối lệnh sau vào phần cấu hình server hoặc location:
location ~* \.pdf$ {
add_header X-Robots-Tag "noindex, nofollow";
}
Sau khi lưu tệp cấu hình, đừng quên khởi động lại dịch vụ Nginx bằng lệnh hệ thống để các thay đổi có hiệu lực ngay lập tức.
Những sai lầm thường gặp khi triển khai X-Robots-Tag
Mặc dù là một công cụ mạnh mẽ, việc cấu hình sai X-Robots-Tag có thể dẫn đến những hậu quả nghiêm trọng cho hiệu suất SEO của toàn bộ website.
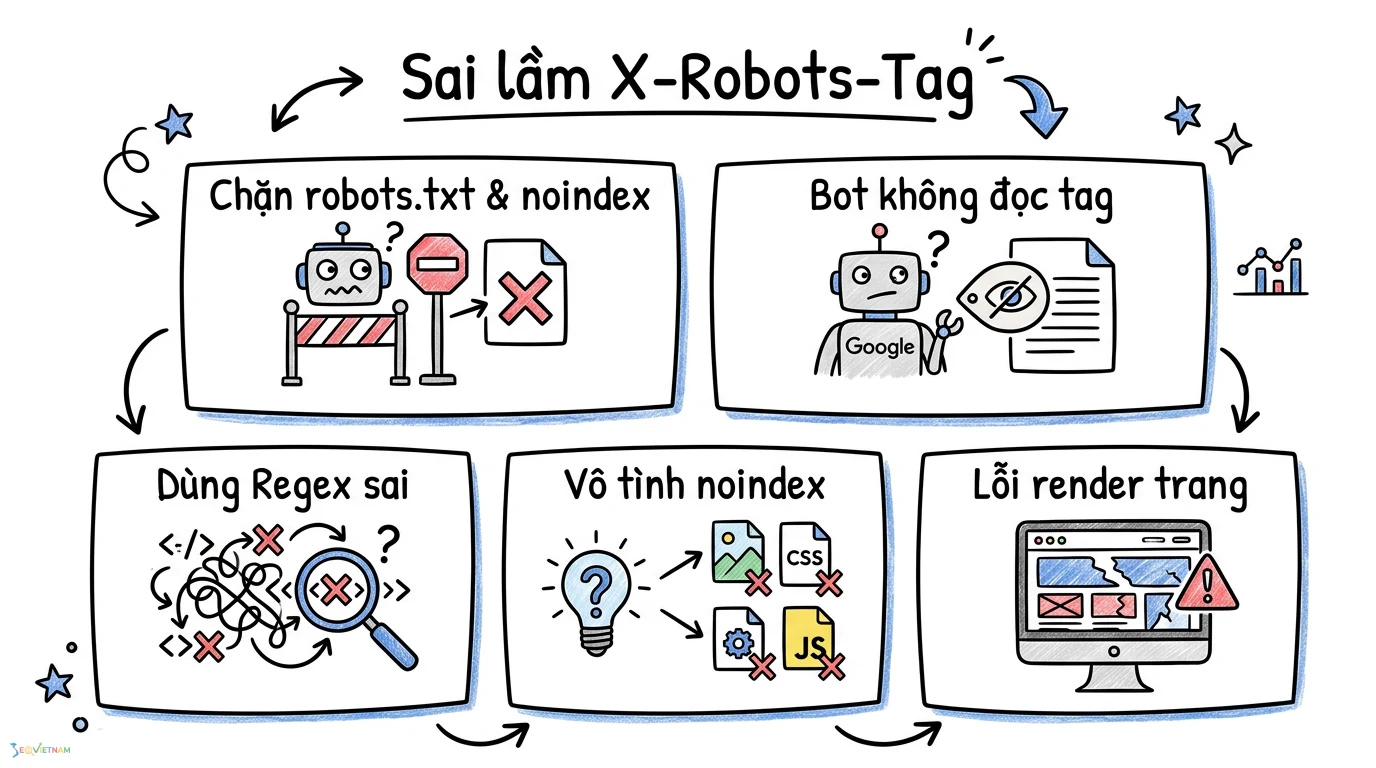
Sai lầm phổ biến nhất là chặn thu thập dữ liệu bằng robots.txt đối với các tệp đang được gắn X-Robots-Tag noindex. Nếu Googlebot bị chặn bởi robots.txt, nó sẽ không bao giờ truy cập được vào tệp để đọc phản hồi HTTP Header. Kết quả là tệp đó vẫn có thể xuất hiện trên kết quả tìm kiếm với thông báo thiếu mô tả. Bạn bắt buộc phải cho phép bot thu thập dữ liệu thì bot mới thấy được lệnh noindex.
Một rủi ro khác là áp dụng sai biểu thức chính quy (Regex) trong tệp cấu hình máy chủ. Việc đặt sai một dấu chấm hoặc dấu sao có thể vô tình gắn thẻ noindex cho toàn bộ hình ảnh trên website hoặc thậm chí là các tệp CSS và JavaScript quan trọng, khiến Googlebot không thể hiển thị trang web một cách chính xác.
Câu hỏi thường gặp
X-Robots-Tag có ảnh hưởng đến tốc độ tải trang không?
Không, X-Robots-Tag hoàn toàn không làm chậm tốc độ tải trang. Đây chỉ là một chuỗi văn bản rất nhỏ được thêm vào phản hồi HTTP Header của máy chủ. Quá trình xử lý diễn ra ở cấp độ server-side trong vài mili-giây, không gây ảnh hưởng đến trải nghiệm người dùng hay các chỉ số hiệu suất website.
Tôi có thể dùng cả X-Robots-Tag và meta robots cùng lúc không?
Bạn có thể sử dụng cả hai, nhưng điều này thường không cần thiết và dễ gây nhầm lẫn trong quá trình quản trị. Nếu cả hai cùng tồn tại và đưa ra các chỉ thị khác nhau, Googlebot sẽ ưu tiên tuân thủ chỉ thị khắt khe nhất. Ví dụ, nếu thẻ HTML cho phép index nhưng HTTP Header yêu cầu noindex, trang đó sẽ bị loại khỏi kết quả tìm kiếm.
Làm thế nào để kiểm tra X-Robots-Tag trên website?
Vì X-Robots-Tag không hiển thị trong mã nguồn HTML, bạn không thể dùng tính năng xem nguồn trang thông thường để kiểm tra. Thay vào đó, bạn cần sử dụng công cụ Developer Tools của trình duyệt (chuyển sang tab Network, tải lại trang và xem phần Response Headers của tệp). Ngoài ra, các công cụ SEO chuyên dụng hoặc tính năng kiểm tra URL trong Google Search Console cũng hỗ trợ phát hiện thẻ này.
Khi nào nên ưu tiên X-Robots-Tag thay vì thẻ meta HTML?
Bạn bắt buộc phải dùng X-Robots-Tag khi muốn kiểm soát việc lập chỉ mục cho các tệp không phải HTML như PDF, hình ảnh, video, hoặc tài liệu Word. Ngoài ra, phương pháp này cũng được ưu tiên khi bạn cần áp dụng quy tắc noindex hàng loạt cho một thư mục lớn thông qua cấu hình máy chủ, giúp tiết kiệm thời gian so với việc chèn mã vào từng trang riêng lẻ.
Googlebot mất bao lâu để nhận diện thay đổi từ X-Robots-Tag?
Thời gian nhận diện phụ thuộc hoàn toàn vào tần suất thu thập dữ liệu của Googlebot đối với URL đó. Ngay khi bot quay lại cào trang và đọc được HTTP Header mới, chỉ thị sẽ được ghi nhận. Đối với các tệp ít được thu thập dữ liệu như PDF cũ, quá trình này có thể mất từ vài ngày đến vài tuần.
Kết luận
X-Robots-Tag là một kỹ thuật nâng cao nhưng không thể thiếu trong bộ công cụ của bất kỳ chuyên gia SEO nào. Bằng cách tận dụng HTTP Header, bạn có thể kiểm soát chặt chẽ việc lập chỉ mục cho mọi loại tài nguyên trên máy chủ, từ đó tối ưu hóa ngân sách thu thập dữ liệu và bảo vệ các tài liệu nội bộ khỏi kết quả tìm kiếm công khai.
Sau khi cấu hình trên Apache hoặc Nginx, hãy luôn nhớ kiểm tra lại bằng các công cụ phân tích HTTP Header để đảm bảo máy chủ đang trả về đúng chỉ thị. Đừng quên thực hiện một đợt kiểm tra SEO kỹ thuật toàn diện hoặc sử dụng danh sách kiểm tra audit để xác nhận rằng bạn không vô tình chặn Googlebot thu thập dữ liệu các trang quan trọng mang lại doanh thu cho doanh nghiệp.
Bài viết liên quan
https://seovietnam.vn/noindex-header-x-robots-tag/