Tốc độ thu thập dữ liệu của công cụ tìm kiếm đóng vai trò quyết định đến việc nội dung trên website của bạn có được lập chỉ mục và xuất hiện kịp thời trên kết quả tìm kiếm hay không. Khi Googlebot crawl chậm, các bài viết mới, sản phẩm vừa cập nhật hoặc những thay đổi quan trọng về giá cả có thể mất nhiều ngày, thậm chí nhiều tuần để hiển thị với người dùng. Tình trạng này thường bắt nguồn từ các vấn đề kỹ thuật cốt lõi như Server Response Time kém, cấu trúc trang web thiếu tối ưu hoặc việc quản lý Crawl Budget chưa hiệu quả.
Để giải quyết triệt để vấn đề này, quản trị viên cần hiểu rõ cơ chế hoạt động của bot tìm kiếm, biết cách đọc dữ liệu từ báo cáo trong Google Search Console và áp dụng các tiêu chuẩn tối ưu hạ tầng máy chủ mới nhất. Bài viết này sẽ phân tích chi tiết các nguyên nhân khiến quá trình thu thập dữ liệu bị đình trệ và hướng dẫn bạn từng bước khắc phục để đảm bảo website luôn duy trì luồng dữ liệu thông suốt.
Googlebot crawl chậm là gì và tại sao nó quan trọng?
Googlebot crawl chậm là hiện tượng trình thu thập dữ liệu của Google giảm tần suất hoặc tốc độ truy cập vào các trang trên website của bạn. Thay vì quét hàng nghìn trang mỗi ngày, bot chỉ thu thập một lượng dữ liệu rất nhỏ, dẫn đến việc bỏ sót các nội dung mới xuất bản hoặc các trang vừa được cập nhật.
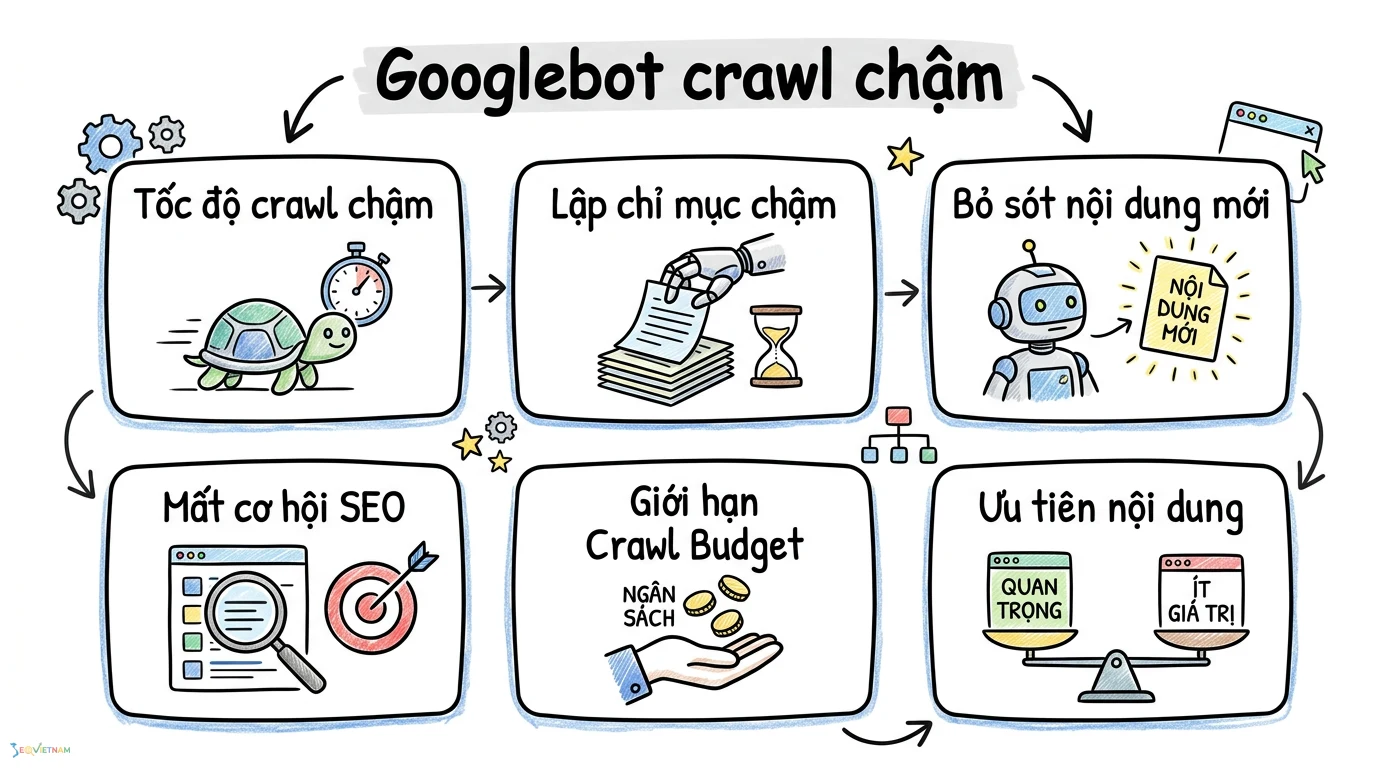
Hệ quả lớn nhất của việc này là sự chậm trễ trong quá trình lập chỉ mục (indexing). Trong môi trường SEO cạnh tranh, việc nội dung của bạn xuất hiện chậm hơn đối thủ đồng nghĩa với việc đánh mất cơ hội tiếp cận khách hàng tiềm năng. Đặc biệt với các trang thương mại điện tử hoặc trang tin tức, thông tin lỗi thời trên kết quả tìm kiếm có thể gây ảnh hưởng trực tiếp đến doanh thu và uy tín thương hiệu.
Nguyên nhân sâu xa của vấn đề này thường liên quan đến khái niệm Crawl Budget (ngân sách thu thập dữ liệu). Google chỉ phân bổ một lượng tài nguyên nhất định cho mỗi website dựa trên mức độ phổ biến và khả năng chịu tải của máy chủ. Việc nắm rõ cơ chế hoạt động của Googlebot desktop sẽ giúp bạn hình dung được cách công cụ tìm kiếm ưu tiên quét các trang quan trọng trước khi chuyển sang các nội dung ít giá trị hơn, từ đó có chiến lược điều hướng bot hợp lý.
Các nguyên nhân phổ biến khiến Googlebot crawl chậm
Để khắc phục tình trạng thu thập dữ liệu chậm, bạn cần xác định chính xác nút thắt kỹ thuật đang cản trở quá trình quét của bot. Dưới đây là những nguyên nhân cốt lõi thường gặp nhất.
Tốc độ phản hồi máy chủ (Server response time)
Đây là yếu tố kỹ thuật quan trọng nhất ảnh hưởng trực tiếp đến tốc độ crawl. Googlebot được lập trình để không làm sập website của bạn. Nếu thời gian phản hồi máy chủ (Time to First Byte – TTFB) quá cao hoặc máy chủ liên tục trả về các mã lỗi 5xx (như 500 Internal Server Error hay 503 Service Unavailable), Googlebot sẽ tự động giảm tốc độ hoặc ngừng hẳn việc thu thập dữ liệu để bảo vệ hệ thống của bạn.
Các công cụ như PageSpeed Insights thường cảnh báo rất rõ về chỉ số TTFB. Trong bối cảnh hạ tầng web hiện đại, nếu TTFB của bạn vượt quá 600ms, Googlebot sẽ bắt đầu đánh giá máy chủ của bạn đang gặp khó khăn và chủ động giãn cách các lần truy cập.
Cấu trúc website và lỗi điều hướng
Một cấu trúc website rườm rà với quá nhiều tầng liên kết nội bộ sẽ khiến bot mất phương hướng và tiêu tốn nhiều thời gian để tìm đến các trang đích quan trọng. Bên cạnh đó, việc lạm dụng chuỗi chuyển hướng (Redirect 301 chains) cũng là một rào cản lớn. Mỗi lần bot phải đi qua một chuỗi chuyển hướng dài, nó sẽ lãng phí một phần ngân sách thu thập dữ liệu, và nếu chuỗi này quá phức tạp, bot có thể từ bỏ việc quét trang đích cuối cùng.
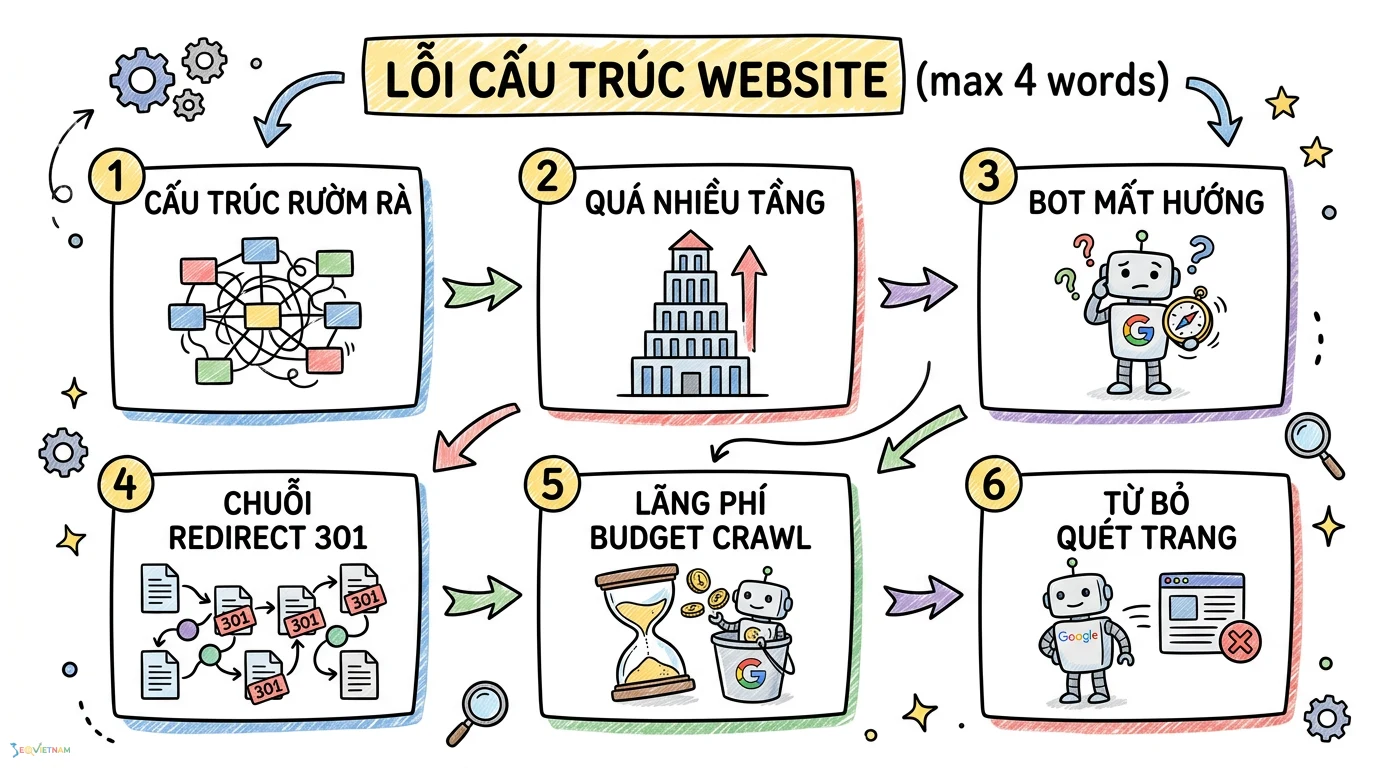
Lãng phí ngân sách thu thập dữ liệu
Nhiều website tạo ra hàng loạt trang có nội dung mỏng (thin content), trang bộ lọc tìm kiếm vô tận hoặc các trang thẻ (tag) không mang lại giá trị thực sự cho người dùng. Khi Googlebot dành quá nhiều thời gian để quét các trang kém chất lượng này, nó sẽ không còn đủ ngân sách để thu thập các bài viết hoặc sản phẩm quan trọng.
Trong quá trình tối ưu cấu trúc, việc hiểu rõ khi nào dùng noindex cho tag category là một kỹ thuật quan trọng để ngăn chặn bot lãng phí thời gian, giúp tập trung tài nguyên vào các trang có khả năng mang lại chuyển đổi cao.
Cách kiểm tra và nhận biết tốc độ crawl
Để biết chính xác website của bạn có đang bị crawl chậm hay không, công cụ đáng tin cậy nhất là báo cáo Crawl Stats (Số liệu thống kê về quá trình thu thập dữ liệu) bên trong Google Search Console. Báo cáo này cung cấp biểu đồ chi tiết về tổng số yêu cầu thu thập dữ liệu, tổng kích thước tải xuống và thời gian phản hồi trung bình.
Bảng dưới đây giúp bạn đối chiếu các dấu hiệu để nhận biết tình trạng sức khỏe của quá trình thu thập dữ liệu:
|
Tình trạng |
Dấu hiệu bình thường (Normal) |
Dấu hiệu crawl chậm (Slow Crawl) |
|
Thời gian phản hồi (TTFB) |
Dưới 300ms, đường biểu đồ ổn định. |
Thường xuyên vượt mức 800ms, biểu đồ biến động mạnh. |
|
Mã phản hồi HTTP |
Chủ yếu là mã 200 (OK) và 304 (Not Modified). |
Xuất hiện nhiều mã 5xx hoặc mã 4xx tăng đột biến. |
|
Tần suất thu thập |
Biểu đồ tổng số yêu cầu duy trì đều đặn hoặc tăng nhẹ. |
Biểu đồ tổng số yêu cầu giảm sâu và đi ngang trong nhiều ngày. |
|
Tình trạng Index |
Bài viết mới được index trong vòng 24 – 48 giờ. |
Bài viết mới mất hàng tuần vẫn ở trạng thái "Đã phát hiện – chưa lập chỉ mục". |
Hướng dẫn tối ưu hóa tốc độ crawl cho năm 2026
Khi đã xác định được nguyên nhân, bạn cần áp dụng các biện pháp kỹ thuật đồng bộ để khôi phục và tăng tốc độ thu thập dữ liệu. Dưới đây là các bước tối ưu hóa thiết yếu.
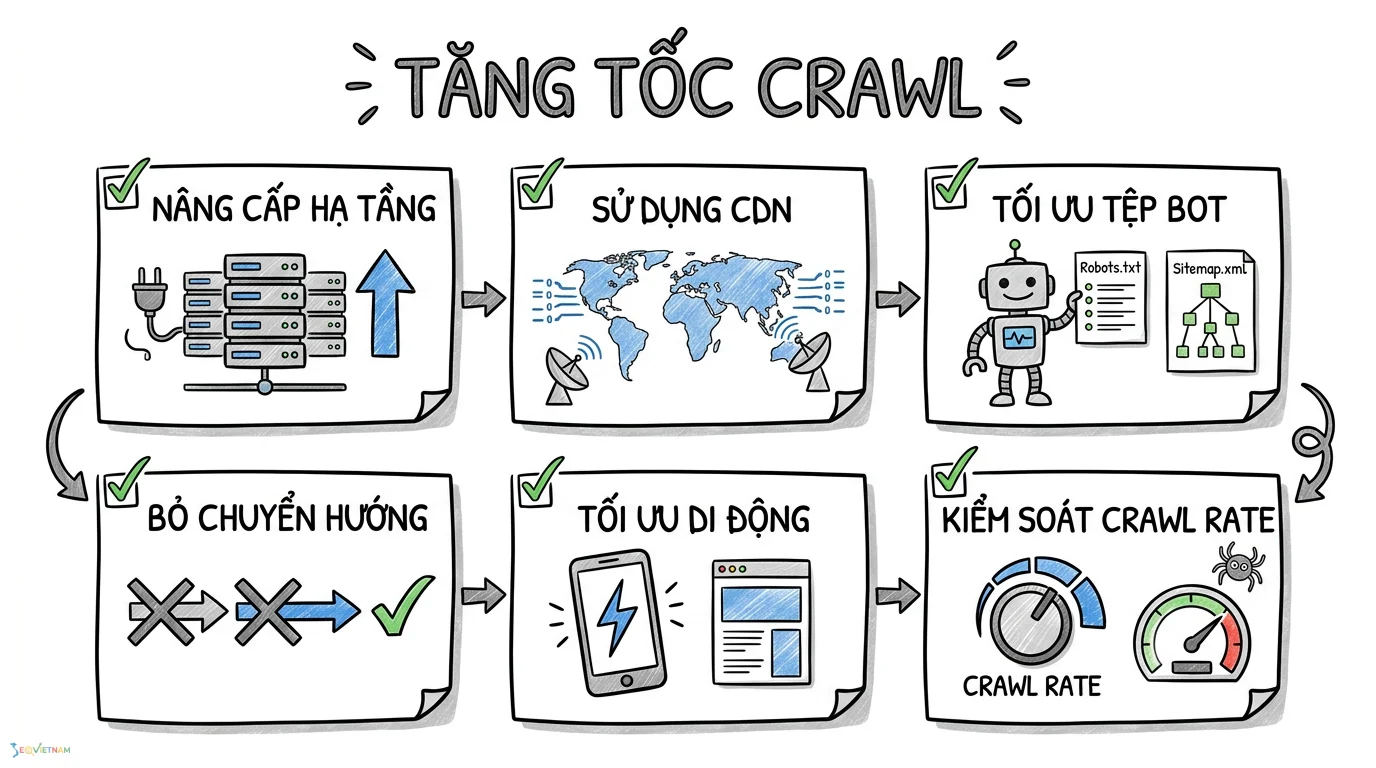
Cải thiện hạ tầng máy chủ là ưu tiên hàng đầu. Bạn cần đảm bảo hosting hoặc server có đủ tài nguyên để xử lý các yêu cầu đồng thời. Việc sử dụng mạng phân phối nội dung (CDN) và các công nghệ điện toán biên (edge computing) sẽ giúp giảm tải đáng kể cho máy chủ gốc, từ đó cải thiện TTFB.
Tiếp theo, hãy dọn dẹp lại các tệp tin định hướng bot. Đảm bảo tệp Robots.txt không vô tình chặn các thư mục quan trọng và tệp Sitemap.xml chỉ chứa các URL có mã phản hồi 200, nội dung chất lượng cao. Việc gửi một sitemap chứa đầy các trang lỗi 404 hoặc trang chuyển hướng sẽ làm giảm độ tin cậy của website trong mắt Googlebot.
Đồng thời, bạn cần rà soát và loại bỏ các chuỗi chuyển hướng không cần thiết. Hãy đảm bảo mọi liên kết nội bộ đều trỏ thẳng đến URL đích cuối cùng. Với xu hướng Mobile-first indexing, hãy chắc chắn rằng phiên bản di động của website tải nhanh và có cấu trúc liên kết tương đồng với phiên bản máy tính.
Trong một số trường hợp máy chủ quá tải do lưu lượng truy cập thực tế tăng đột biến, bạn thậm chí cần tìm hiểu các biện pháp tối ưu hóa và giảm crawl rate của Googlebot để bảo vệ tài nguyên hệ thống trước khi có thể nâng cấp hạ tầng toàn diện. Việc kiểm soát chủ động này tốt hơn nhiều so với việc để máy chủ sập và trả về lỗi 500.
Các câu hỏi thường gặp (FAQ)
Mất bao lâu để Google crawl lại trang web?
Thời gian thu thập dữ liệu lại phụ thuộc vào mức độ uy tín của website và tần suất bạn cập nhật nội dung. Với các trang tin tức lớn, Googlebot có thể quay lại sau vài phút. Tuy nhiên, với các blog nhỏ hoặc trang ít cập nhật, quá trình này có thể kéo dài từ vài ngày đến vài tuần.
Làm sao để biết Googlebot đang gặp khó khăn khi crawl?
Dấu hiệu rõ ràng nhất là khi bạn kiểm tra báo cáo Crawl Stats trong Google Search Console và thấy thời gian phản hồi trung bình tăng vọt, kèm theo sự sụt giảm mạnh về tổng số yêu cầu thu thập dữ liệu. Sự xuất hiện liên tục của lỗi 5xx cũng là một cảnh báo đỏ.
Tốc độ tải trang có ảnh hưởng đến crawl budget không?
Có, tốc độ tải trang (đặc biệt là thời gian phản hồi của máy chủ) ảnh hưởng trực tiếp đến ngân sách thu thập dữ liệu. Nếu máy chủ phản hồi chậm, Googlebot sẽ quét được ít trang hơn trong cùng một khoảng thời gian được phân bổ, dẫn đến việc lãng phí crawl budget.
Tại sao Google index chậm dù đã khai báo sitemap?
Sitemap chỉ là một bản đồ chỉ đường, không phải là lệnh bắt buộc Google phải lập chỉ mục. Nếu nội dung của bạn mỏng, trùng lặp, hoặc máy chủ phản hồi quá chậm khi bot truy cập vào các URL trong sitemap, Google vẫn sẽ trì hoãn việc lập chỉ mục các trang đó.
Cần làm gì khi báo cáo Crawl Stats báo lỗi máy chủ 5xx liên tục?
Bạn cần liên hệ ngay với nhà cung cấp dịch vụ hosting hoặc đội ngũ IT để kiểm tra log máy chủ (server logs). Lỗi 5xx thường do máy chủ bị quá tải tài nguyên (CPU, RAM) hoặc cấu hình tường lửa chặn nhầm IP của Googlebot.
Kết luận
Tình trạng Googlebot crawl chậm là một rào cản kỹ thuật lớn, trực tiếp làm giảm hiệu quả của mọi chiến dịch SEO. Bằng cách thường xuyên theo dõi báo cáo Crawl Stats trong Google Search Console, duy trì thời gian phản hồi máy chủ ở mức lý tưởng và tối ưu hóa cấu trúc liên kết nội bộ, bạn sẽ đảm bảo ngân sách thu thập dữ liệu luôn được sử dụng hiệu quả nhất. Nếu website của bạn liên tục gặp lỗi máy chủ 5xx kéo dài mà không thể tự khắc phục, hãy chủ động liên hệ với các chuyên gia quản trị hệ thống để nâng cấp hạ tầng, đảm bảo luồng dữ liệu giữa website và công cụ tìm kiếm không bị gián đoạn.
Bài viết liên quan
https://seovietnam.vn/cach-kiem-tra-ip-googlebot/