Cảnh báo quan trọng: Việc chủ động giảm tốc độ thu thập dữ liệu có thể ảnh hưởng trực tiếp đến độ tươi mới của dữ liệu (index freshness). Khi Googlebot ít truy cập vào trang web hơn, các bài viết mới hoặc nội dung vừa cập nhật sẽ mất nhiều thời gian hơn để xuất hiện trên kết quả tìm kiếm. Chỉ thực hiện điều chỉnh này khi máy chủ của bạn thực sự gặp nguy cơ quá tải.
Khi máy chủ liên tục báo lỗi hoặc tốc độ tải trang giảm sút nghiêm trọng, một trong những nguyên nhân phổ biến là do các trình thu thập dữ liệu hoạt động quá mức. Việc quản lý và giảm crawl rate Googlebot đúng cách giúp bảo vệ tài nguyên server mà không làm tổn hại đến chiến lược SEO tổng thể. Tuy nhiên, can thiệp vào tần suất thu thập dữ liệu đòi hỏi sự cẩn trọng và hiểu biết về các cơ chế kỹ thuật mà Google hỗ trợ.
Bài viết này sẽ hướng dẫn bạn cách đánh giá tình trạng máy chủ, nhận diện nguyên nhân và áp dụng các phương pháp an toàn nhất để kiểm soát lưu lượng từ Googlebot.
Crawl rate là gì và tại sao Google tự động quản lý?
Crawl rate (tốc độ thu thập dữ liệu) là số lượng yêu cầu (requests) mà Googlebot thực hiện trên trang web của bạn trong một khoảng thời gian nhất định. Mục tiêu của Google là thu thập càng nhiều nội dung hữu ích càng tốt mà không làm ảnh hưởng đến trải nghiệm của người dùng thật đang truy cập trang web.
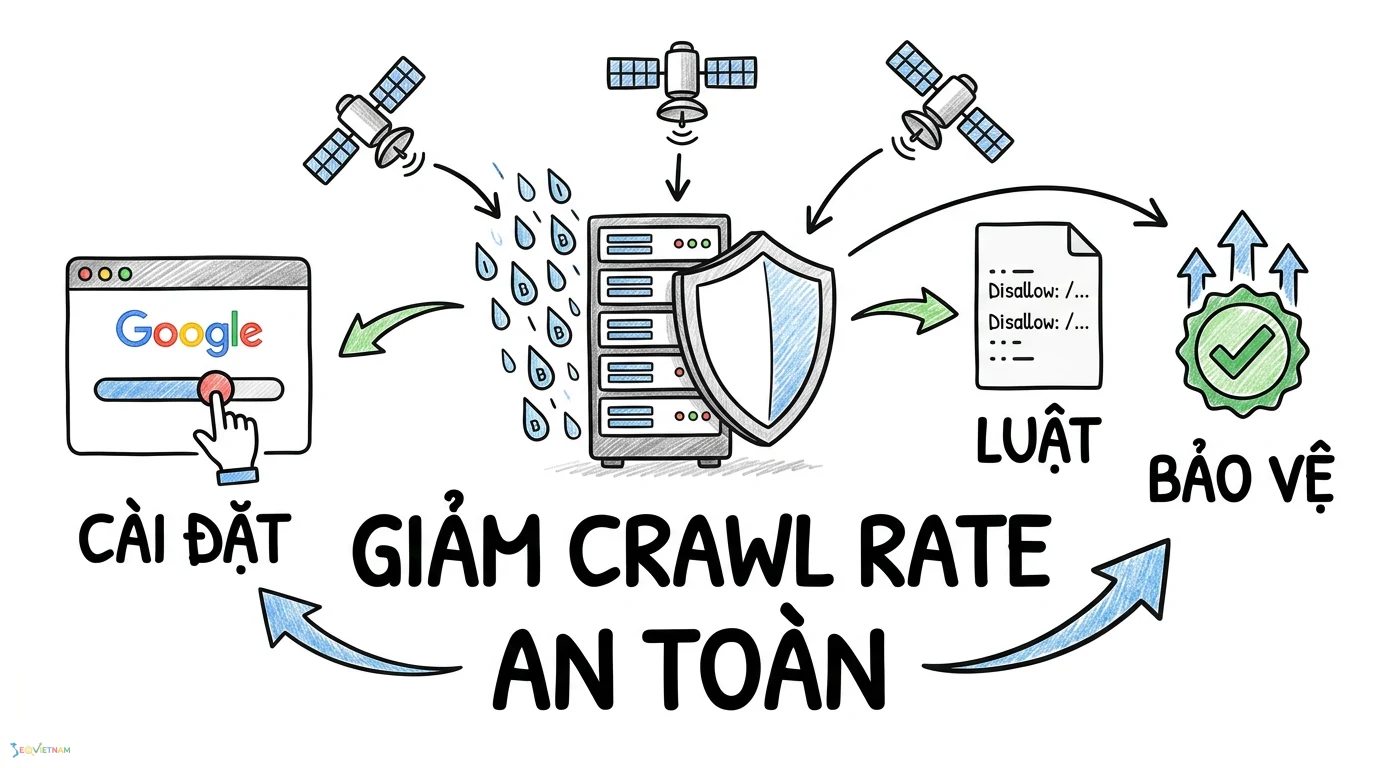
Theo tài liệu chính thức từ Google Search Central, Googlebot sử dụng các thuật toán tinh vi để tự động xác định tốc độ thu thập dữ liệu tối ưu. Hệ thống sẽ liên tục theo dõi thời gian phản hồi của máy chủ (server load). Nếu máy chủ phản hồi nhanh, Googlebot có thể tăng nhẹ số lượng yêu cầu. Ngược lại, nếu máy chủ bắt đầu chậm lại hoặc trả về các lỗi phản hồi, Googlebot sẽ tự động giảm tốc độ để tránh gây sập hệ thống.
Để hiểu rõ hơn về cách các trình thu thập dữ liệu phân bổ tài nguyên và tương tác với máy chủ, bạn có thể tham khảo cơ chế hoạt động của Googlebot desktop nhằm nắm bắt trọn vẹn quy trình hoạt động của hệ thống này.
Khi nào bạn thực sự cần giảm crawl rate?
Không phải lúc nào việc thấy Googlebot truy cập nhiều cũng là tín hiệu xấu. Bạn chỉ nên can thiệp vào tốc độ thu thập dữ liệu khi hệ thống xuất hiện các dấu hiệu quá tải rõ ràng.
Trước khi đưa ra quyết định, hãy kiểm tra kỹ các yếu tố sau:
Tài nguyên máy chủ bị cạn kiệt: CPU hoặc RAM của server thường xuyên đạt mức tối đa vào những thời điểm Googlebot hoạt động mạnh.
Lỗi phản hồi tăng đột biến: Người dùng thật hoặc các công cụ giám sát ghi nhận nhiều lỗi HTTP 500 (Internal Server Error) hoặc HTTP 503 (Service Unavailable).
Dữ liệu từ access logs: Phân tích file nhật ký truy cập (access logs) cho thấy phần lớn băng thông đang bị tiêu thụ bởi các dải IP của Google. Trong quá trình theo dõi, việc phân tích log file không chỉ giúp bạn phát hiện tình trạng quá tải mà còn giúp nhận biết thời điểm Googlebot crawl chậm bất thường để có phương án điều chỉnh cấu hình kịp thời.
Tại sao không nên dùng crawl-delay trong robots.txt?
Một sai lầm rất phổ biến của nhiều quản trị viên web là cố gắng sử dụng chỉ thị crawl-delay trong tệp robots.txt để kiểm soát Googlebot.
Trên thực tế, Googlebot hoàn toàn bỏ qua chỉ thị crawl-delay. Mặc dù một số công cụ tìm kiếm khác như Bing hay Yandex có thể tuân thủ quy tắc này, Google đã xác nhận rằng họ không hỗ trợ nó. Việc thêm dòng lệnh này vào robots.txt không mang lại bất kỳ tác dụng nào trong việc giảm tải cho máy chủ từ phía Google, đồng thời có thể gây ra những hiểu lầm về mặt cấu hình kỹ thuật.
Thay vì phụ thuộc vào một chỉ thị không được hỗ trợ, bạn cần sử dụng các công cụ chính thức của Google hoặc can thiệp trực tiếp từ phía máy chủ.
Các phương pháp giảm crawl rate an toàn
Để bảo vệ server load mà vẫn duy trì trạng thái SEO ổn định, bạn có thể áp dụng hai phương pháp chính dưới đây. Hãy ưu tiên sử dụng công cụ của Google trước khi can thiệp sâu vào hệ thống.
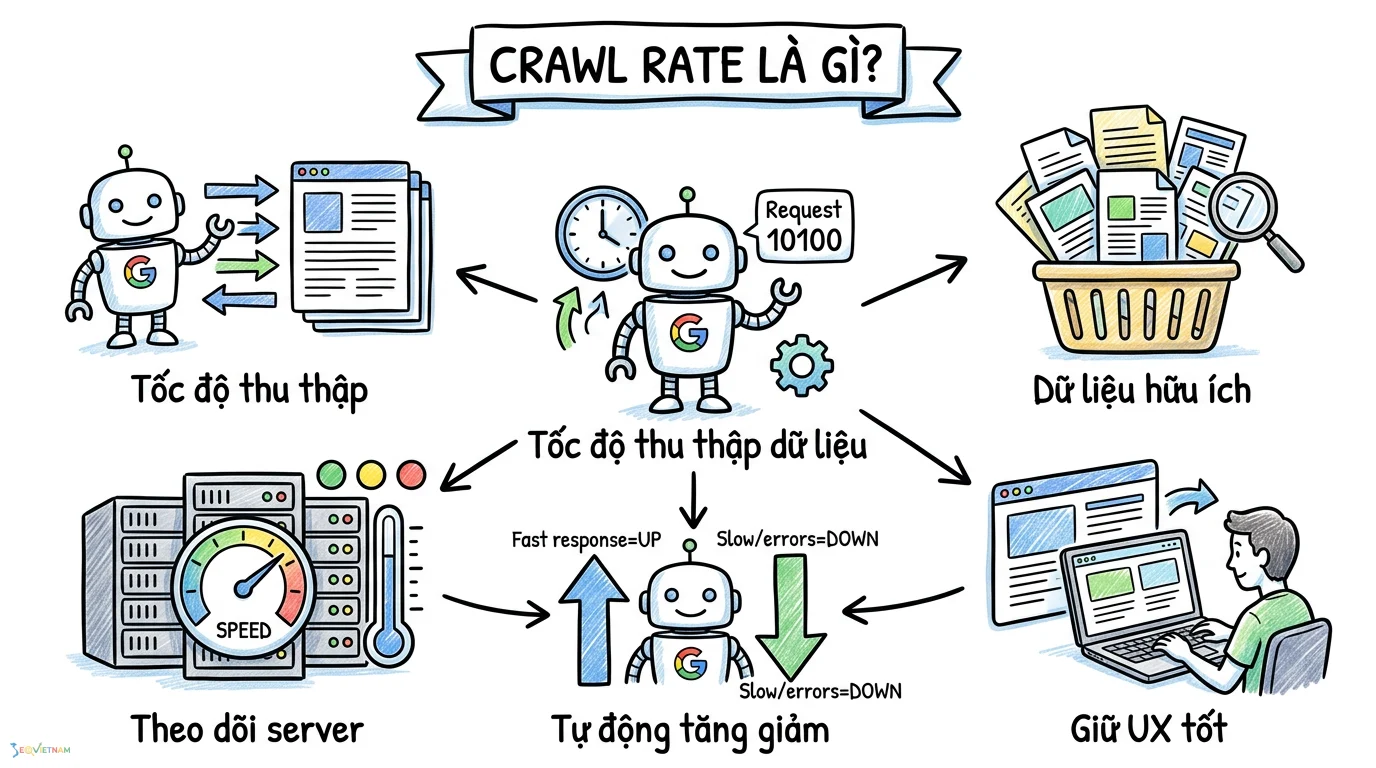
Sử dụng Google Search Console
Đây là phương pháp an toàn và được Google khuyến nghị nhất. Google Search Console cung cấp một tính năng ẩn giúp bạn giới hạn tốc độ thu thập dữ liệu trong trường hợp khẩn cấp.
Quy trình thực hiện bao gồm việc truy cập vào trang Cài đặt tốc độ thu thập dữ liệu (Crawl Rate Settings) dành riêng cho các phiên bản Search Console cũ vẫn được Google duy trì. Tại đây, bạn chọn thuộc tính trang web cần điều chỉnh và kéo thanh trượt để giảm số lượng yêu cầu mỗi giây.
Cần lưu ý rằng cài đặt này chỉ có hiệu lực tạm thời trong vòng 90 ngày. Google thiết kế cơ chế này nhằm cho phép bạn có đủ thời gian nâng cấp máy chủ hoặc tối ưu hóa hiệu suất trang web. Sau 90 ngày, tốc độ thu thập dữ liệu sẽ tự động quay trở lại mức do thuật toán của Google quyết định.
Cấu hình phía server (server-side throttling)
Trong trường hợp tính năng của Search Console không đáp ứng đủ nhanh hoặc bạn đang bị tấn công bởi các bot giả mạo, việc thiết lập giới hạn tỷ lệ (rate limiting) từ phía máy chủ là giải pháp kỹ thuật triệt để nhất.
Sử dụng mã trạng thái HTTP 503 hoặc 429: Khi máy chủ của bạn không thể xử lý thêm yêu cầu, hãy cấu hình để trả về mã lỗi HTTP 503 (Service Unavailable) hoặc HTTP 429 (Too Many Requests) riêng cho các bot. Googlebot được lập trình để hiểu các mã trạng thái này. Khi nhận được tín hiệu 503 hoặc 429, Googlebot sẽ tự động giãn cách thời gian thu thập dữ liệu và quay lại sau.
Thiết lập Rate Limiting qua WAF hoặc Web Server: Bạn có thể sử dụng Tường lửa ứng dụng web (WAF) như Cloudflare để tạo các quy tắc giới hạn số lượng yêu cầu dựa trên User-Agent. Nếu sử dụng Nginx, bạn có thể cấu hình module limitreqzone để kiểm soát tần suất truy cập. Đối với Apache, module modevasive hoặc modratelimit sẽ đảm nhiệm vai trò tương tự.
Tuy nhiên, trước khi thiết lập các quy tắc chặn hoặc giới hạn IP nghiêm ngặt ở cấp độ server, bạn cần thực hiện quy trình xác thực IP Googlebot chính chủ để đảm bảo không vô tình chặn nhầm người dùng thật hoặc các dịch vụ hợp lệ khác của Google.
Những rủi ro khi giảm crawl rate quá mức
Việc thắt chặt tốc độ thu thập dữ liệu mang lại sự an toàn cho máy chủ nhưng lại tiềm ẩn nhiều rủi ro lớn đối với hiệu suất SEO.
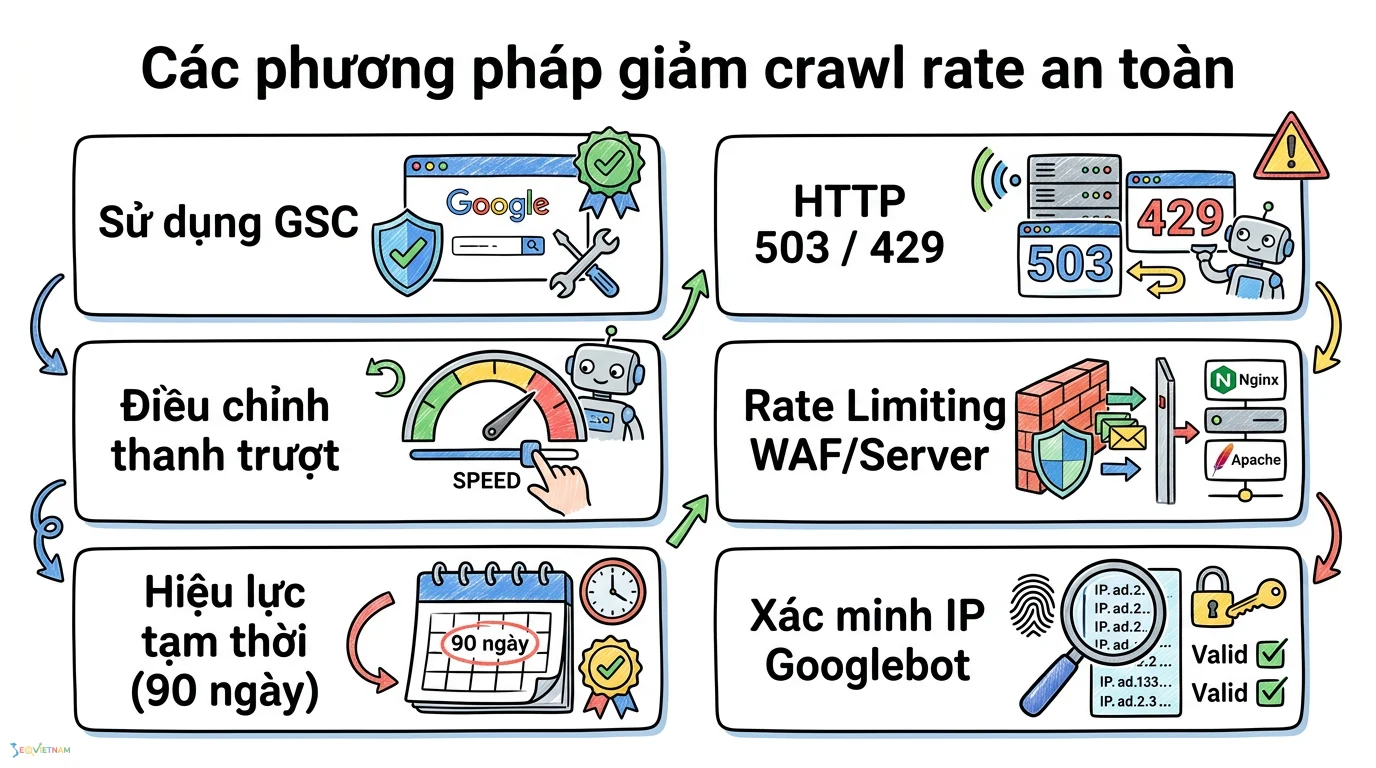
Rủi ro lớn nhất là sự suy giảm về index freshness. Khi Googlebot bị hạn chế, các bài viết mới xuất bản sẽ mất nhiều ngày, thậm chí nhiều tuần để được lập chỉ mục. Điều này đặc biệt nghiêm trọng đối với các trang web tin tức hoặc thương mại điện tử cần cập nhật giá cả và sản phẩm liên tục.
Bên cạnh đó, những thay đổi quan trọng trên các trang cũ (như tối ưu lại thẻ tiêu đề, cập nhật nội dung mới) cũng sẽ chậm được Google ghi nhận. Nếu đối thủ cạnh tranh có tốc độ thu thập dữ liệu tốt hơn, họ có thể vượt lên trong kết quả tìm kiếm nhờ việc nội dung được cập nhật và lập chỉ mục nhanh chóng hơn.
Câu hỏi thường gặp về quản lý crawl rate
Googlebot có tuân thủ chỉ thị crawl-delay không?
Không. Googlebot hoàn toàn bỏ qua chỉ thị crawl-delay trong tệp robots.txt. Để kiểm soát tốc độ thu thập dữ liệu của Google, bạn bắt buộc phải sử dụng tính năng trong Google Search Console hoặc cấu hình trả về mã trạng thái HTTP 503/429 từ phía máy chủ.
Giảm crawl rate có làm mất thứ hạng SEO không?
Việc giảm tốc độ thu thập dữ liệu không trực tiếp làm giảm thứ hạng từ khóa. Tuy nhiên, nó làm chậm quá trình Google phát hiện và cập nhật nội dung mới. Nếu nội dung của bạn bị lỗi thời trên kết quả tìm kiếm do không được crawl kịp thời, thứ hạng có thể bị ảnh hưởng gián tiếp.
Làm sao để biết Googlebot đang crawl quá mức?
Bạn có thể kiểm tra báo cáo Thống kê thu thập dữ liệu (Crawl Stats) trong Google Search Console để xem biểu đồ số lượng yêu cầu mỗi ngày. Kết hợp với việc kiểm tra access logs của máy chủ, nếu thấy IP của Google chiếm phần lớn tài nguyên và gây ra lỗi 5xx, đó là dấu hiệu của việc crawl quá mức.
Giới hạn crawl rate trong Search Console có hiệu lực bao lâu?
Khi bạn thiết lập giới hạn tốc độ thu thập dữ liệu thông qua công cụ của Google Search Console, cài đặt này sẽ có hiệu lực trong vòng 90 ngày. Sau thời gian này, Google sẽ tự động khôi phục lại cơ chế tự động điều chỉnh tốc độ dựa trên thuật toán.
Trạng thái HTTP 503 và 429 khác nhau như thế nào đối với Googlebot?
Cả hai mã trạng thái đều báo hiệu cho Googlebot biết máy chủ đang gặp vấn đề và cần giảm tốc độ. HTTP 503 thông báo rằng dịch vụ tạm thời không khả dụng do quá tải hoặc bảo trì, trong khi HTTP 429 chỉ định rõ ràng rằng có quá nhiều yêu cầu đang được gửi đến trong một khoảng thời gian ngắn.
Kết luận
Giảm crawl rate Googlebot là một biện pháp kỹ thuật cần thiết khi máy chủ của bạn đối mặt với tình trạng quá tải. Việc ưu tiên sử dụng Google Search Console để điều chỉnh tốc độ là phương pháp an toàn nhất, giúp bảo vệ server load mà không gây ra các cú sốc cho hệ thống SEO. Trong những trường hợp khẩn cấp, cấu hình server-side throttling với mã HTTP 503 hoặc 429 sẽ là chốt chặn cuối cùng. Hãy luôn nhớ kiểm tra access logs kỹ lưỡng và cân nhắc rủi ro về index freshness trước khi áp dụng bất kỳ thay đổi nào.
Bài viết liên quan
https://seovietnam.vn/giam-sat-toc-do-thu-thap-thong-tin-google/