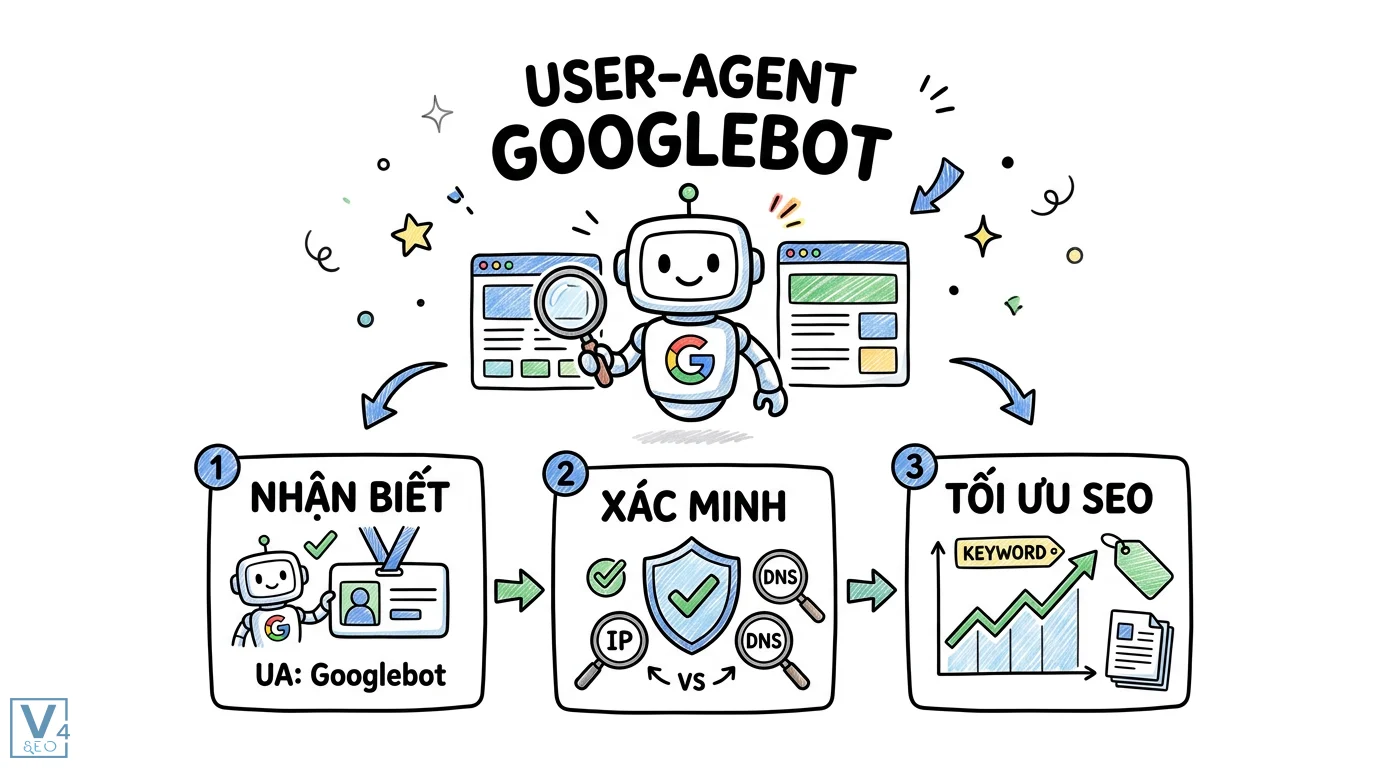
Mỗi khi một trình thu thập dữ liệu truy cập vào trang web của bạn, nó sẽ để lại một "danh thiếp" kỹ thuật số nhằm khai báo danh tính. Đối với các quản trị viên website và chuyên gia SEO, việc nhận diện chính xác danh thiếp này là bước đầu tiên để đảm bảo nội dung được lập chỉ mục hiệu quả.
Trong môi trường internet phức tạp, không phải bất kỳ lượt truy cập nào tự xưng là công cụ tìm kiếm cũng đều đáng tin cậy. Việc hiểu rõ cách hệ thống nhận diện hoạt động sẽ giúp bạn phân biệt được đâu là trình thu thập dữ liệu thực sự của Google và đâu là những phần mềm tự động giả mạo đang cố gắng đánh cắp tài nguyên máy chủ.
Bài viết này sẽ cung cấp cho bạn cái nhìn toàn diện về cách thức hoạt động của chuỗi nhận diện này, đồng thời hướng dẫn chi tiết các bước kỹ thuật để kiểm tra và bảo vệ website của bạn một cách an toàn nhất.
User-Agent Googlebot là gì?
User-Agent là một chuỗi văn bản nằm trong HTTP header mà trình duyệt hoặc trình thu thập dữ liệu (bot) gửi đến máy chủ web mỗi khi yêu cầu một trang. Chuỗi văn bản này chứa các thông tin cơ bản về loại phần mềm, hệ điều hành và phiên bản đang được sử dụng để truy cập.
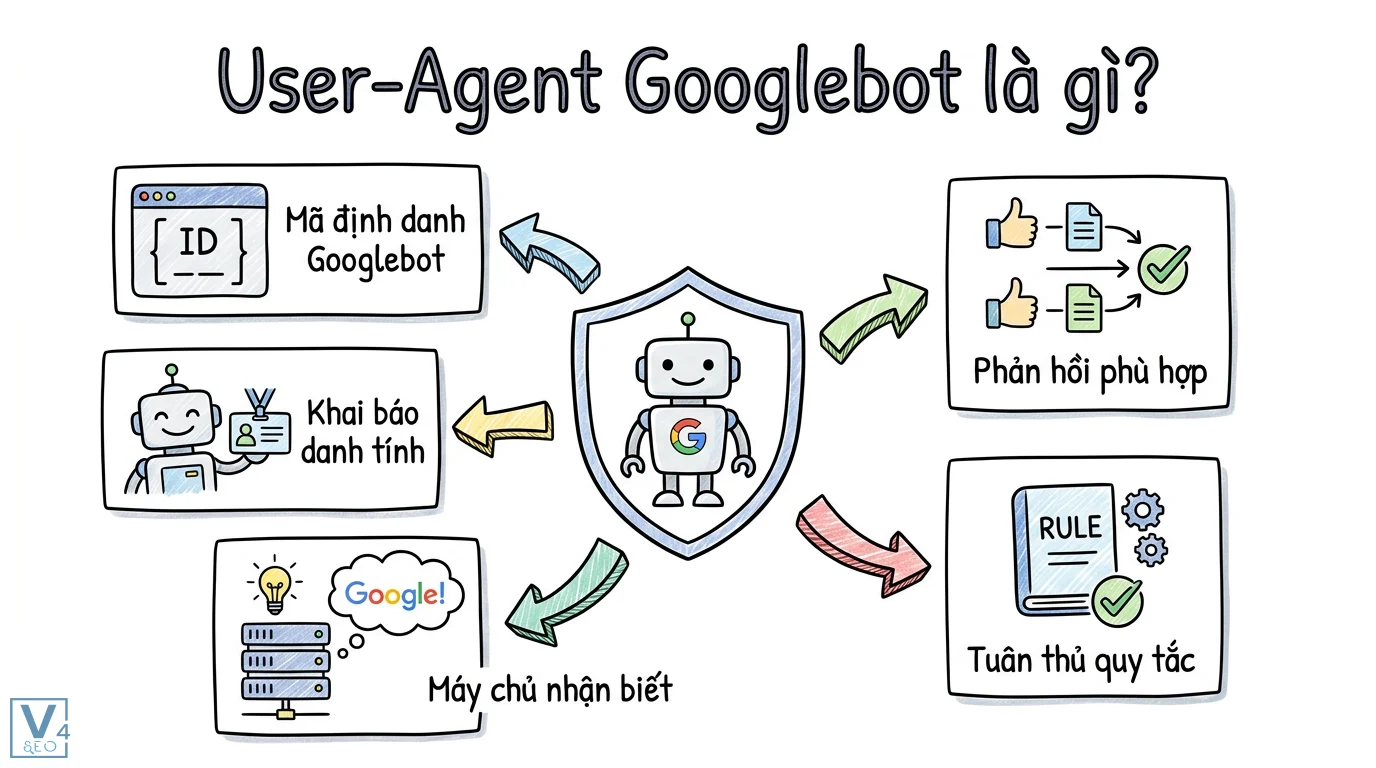
Googlebot là tên gọi chung cho trình thu thập dữ liệu web của Google. Nhiệm vụ chính của nó là liên tục khám phá, quét và thu thập nội dung trên internet để đưa vào cơ sở dữ liệu tìm kiếm.
Khi kết hợp lại, User-Agent Googlebot chính là chuỗi mã định danh cụ thể mà hệ thống của Google sử dụng để khai báo danh tính với máy chủ của bạn trong quá trình Crawling (thu thập dữ liệu). Nhờ có chuỗi này, máy chủ web biết được rằng Google đang ghé thăm và có thể phản hồi bằng các nội dung phù hợp hoặc tuân thủ các quy tắc thu thập dữ liệu đã được thiết lập.
Tại sao cần quan tâm đến User-Agent của Googlebot?
Việc theo dõi và quản lý chuỗi nhận diện của Google mang lại hai lợi ích cốt lõi cho bất kỳ trang web nào: tối ưu hóa SEO và bảo mật hệ thống.
Về mặt SEO optimization, máy chủ của bạn cần nhận diện đúng Googlebot để đảm bảo không vô tình chặn công cụ này truy cập vào các bài viết quan trọng. Nếu Google không thể đọc được nội dung do bị tường lửa chặn nhầm, trang web của bạn sẽ hoàn toàn biến mất khỏi kết quả tìm kiếm.
Về mặt bảo mật, chuỗi User-Agent rất dễ bị làm giả. Nhiều phần mềm cào dữ liệu (scraper) hoặc các bot độc hại thường tự gắn mác là Googlebot để vượt qua các lớp bảo mật, nhằm mục đích đánh cắp nội dung hoặc làm quá tải máy chủ (DDoS). Việc nhận biết và lọc bỏ các lượt truy cập giả mạo này giúp tiết kiệm băng thông và bảo vệ tài nguyên hệ thống.
Các loại Googlebot phổ biến
Google không chỉ sử dụng một trình thu thập dữ liệu duy nhất. Tùy thuộc vào loại nội dung và thiết bị mục tiêu, hệ thống sẽ cử các bot khác nhau đến trang web của bạn. Theo tài liệu chính thức từ Google Search Central, dưới đây là những loại phổ biến nhất:
|
Tên trình thu thập |
Mục đích chính |
Dấu hiệu nhận biết trong chuỗi User-Agent |
|
Googlebot Smartphone |
Thu thập dữ liệu cho lập chỉ mục ưu tiên thiết bị di động. |
Chứa từ khóa "Android" và "Mobile Safari". |
|
Googlebot Desktop |
Thu thập dữ liệu cho giao diện máy tính truyền thống. |
Chứa từ khóa "Windows NT" hoặc "Macintosh". |
|
Googlebot Image |
Chuyên tìm kiếm và lập chỉ mục hình ảnh. |
Chứa từ khóa "Googlebot-Image". |
|
Googlebot Video |
Chuyên quét và phân tích các tệp video. |
Chứa từ khóa "Googlebot-Video". |
Hiểu rõ sự khác biệt giữa các loại bot này giúp bạn kiểm soát tốt hơn cách nội dung hiển thị trên từng nền tảng. Chẳng hạn, cơ chế hoạt động của Googlebot phiên bản desktop sẽ giúp bạn đánh giá xem giao diện web trên máy tính có đang được cào dữ liệu đúng cách hay không, từ đó điều chỉnh chiến lược SEO cho phù hợp.
Cách xác minh Googlebot thật và giả
Vì bất kỳ ai cũng có thể thay đổi chuỗi HTTP header để giả danh Google, bạn không thể chỉ dựa vào tên User-Agent để cấp quyền truy cập. Dưới đây là các bước kỹ thuật chuẩn xác để xác minh danh tính thực sự của bot.
Sử dụng tra cứu DNS ngược
Tra cứu DNS ngược (Reverse DNS lookup) là phương pháp đáng tin cậy nhất để xác minh IP address của bot. Logic của phương pháp này dựa trên việc Google sở hữu độc quyền các tên miền của họ, do đó không một kẻ giả mạo nào có thể tạo ra bản ghi DNS trỏ về tên miền chính thức của Google.
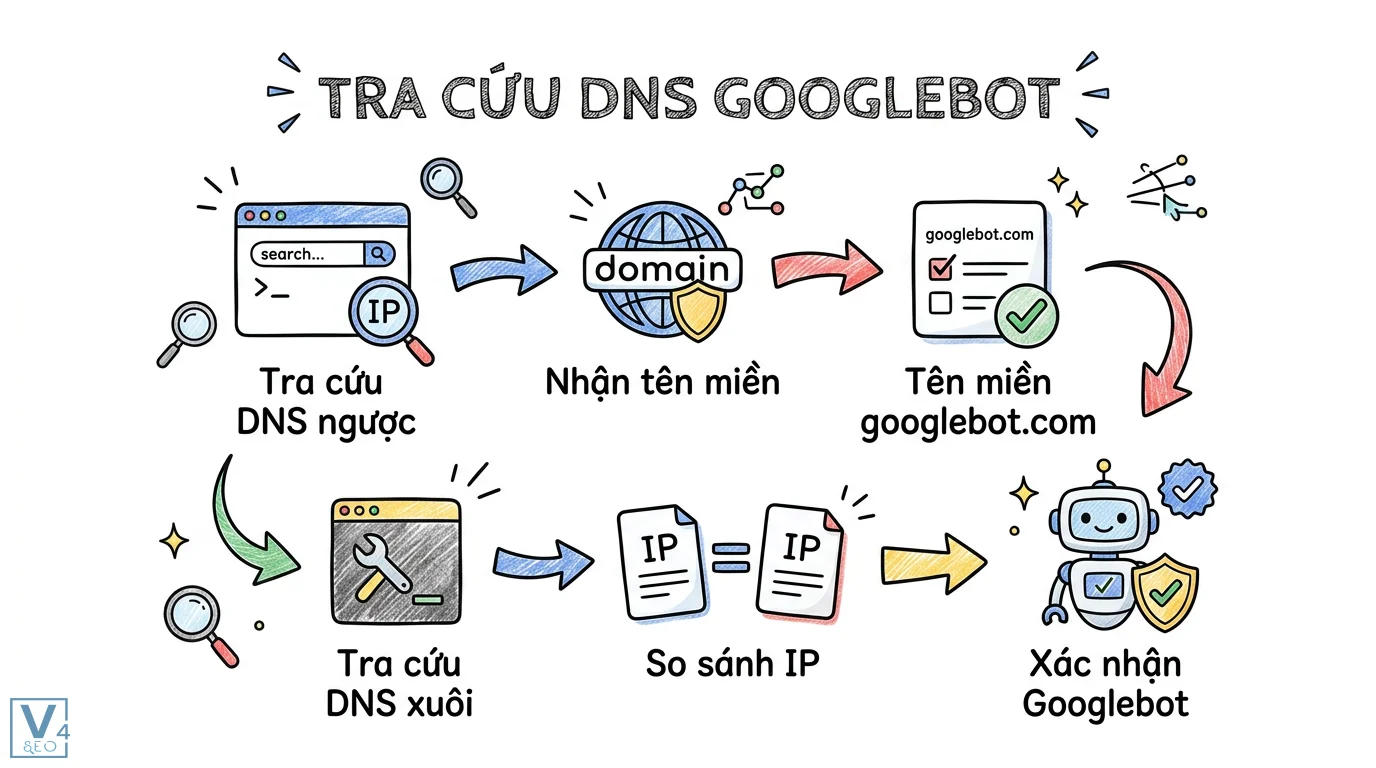
Quá trình xác minh diễn ra theo hai bước:
- Chạy lệnh tra cứu DNS ngược trên địa chỉ IP đang truy cập. Nếu kết quả trả về một tên miền kết thúc bằng googlebot.com hoặc google.com, bạn chuyển sang bước tiếp theo.
- Chạy lệnh tra cứu DNS xuôi (Forward DNS lookup) trên chính tên miền vừa nhận được. Nếu địa chỉ IP trả về khớp hoàn toàn với địa chỉ IP ban đầu, đó chính là Googlebot thật.
Việc áp dụng phương pháp xác minh danh tính Googlebot chính chủ thông qua hệ thống DNS sẽ tạo ra một rào chắn vững chắc, giúp bạn tự tin chặn đứng các IP giả mạo đang cố tình tiêu hao tài nguyên máy chủ.
Phân tích server logs và HTTP header
Nếu bạn muốn kiểm tra nhanh lịch sử truy cập, server logs (nhật ký máy chủ) là nơi cung cấp bằng chứng rõ ràng nhất. Bằng cách trích xuất dữ liệu từ các tệp nhật ký này, bạn có thể lọc ra toàn bộ các yêu cầu có chứa từ khóa Googlebot.
Đối với các hệ thống sử dụng Nginx hoặc Apache trên Linux, bạn có thể sử dụng một dòng lệnh đơn giản trực tiếp trong terminal để tìm kiếm: grep -i "googlebot" /var/log/nginx/access.log. Lệnh này sẽ liệt kê mọi dòng có chứa chuỗi nhận diện của Google, từ đó bạn có thể lấy địa chỉ IP và tiến hành tra cứu DNS ngược như đã hướng dẫn ở trên.
Tối ưu hóa website cho Googlebot
Khi đã xác định được bot truy cập là chính chủ, bước tiếp theo là hướng dẫn chúng thu thập dữ liệu một cách hiệu quả nhất. Công cụ đầu tiên bạn cần sử dụng là tệp Robots.txt. Tệp này đóng vai trò như một biển chỉ dẫn, nói cho Google biết thư mục nào được phép quét và thư mục nào cần bỏ qua.
Bên cạnh đó, Google Search Console là nền tảng không thể thiếu để theo dõi báo cáo thống kê thu thập dữ liệu (Crawl Stats). Báo cáo này cho bạn biết chính xác Googlebot đang gặp khó khăn ở đâu, mã lỗi HTTP nào đang phát sinh và tốc độ phản hồi của máy chủ ra sao.
Trong trường hợp bạn có những trang nội bộ, trang giỏ hàng hoặc các bài viết nháp không muốn xuất hiện trên kết quả tìm kiếm, việc nắm rõ cách sử dụng thẻ noindex để kiểm soát lập chỉ mục sẽ giúp bạn điều hướng ngân sách thu thập dữ liệu (crawl budget) tập trung vào các bài viết thực sự mang lại giá trị chuyển đổi.
Những sai lầm thường gặp khi xử lý User-Agent
Trong quá trình Technical troubleshooting, nhiều quản trị viên thường mắc phải những sai lầm nghiêm trọng làm ảnh hưởng trực tiếp đến thứ hạng SEO.
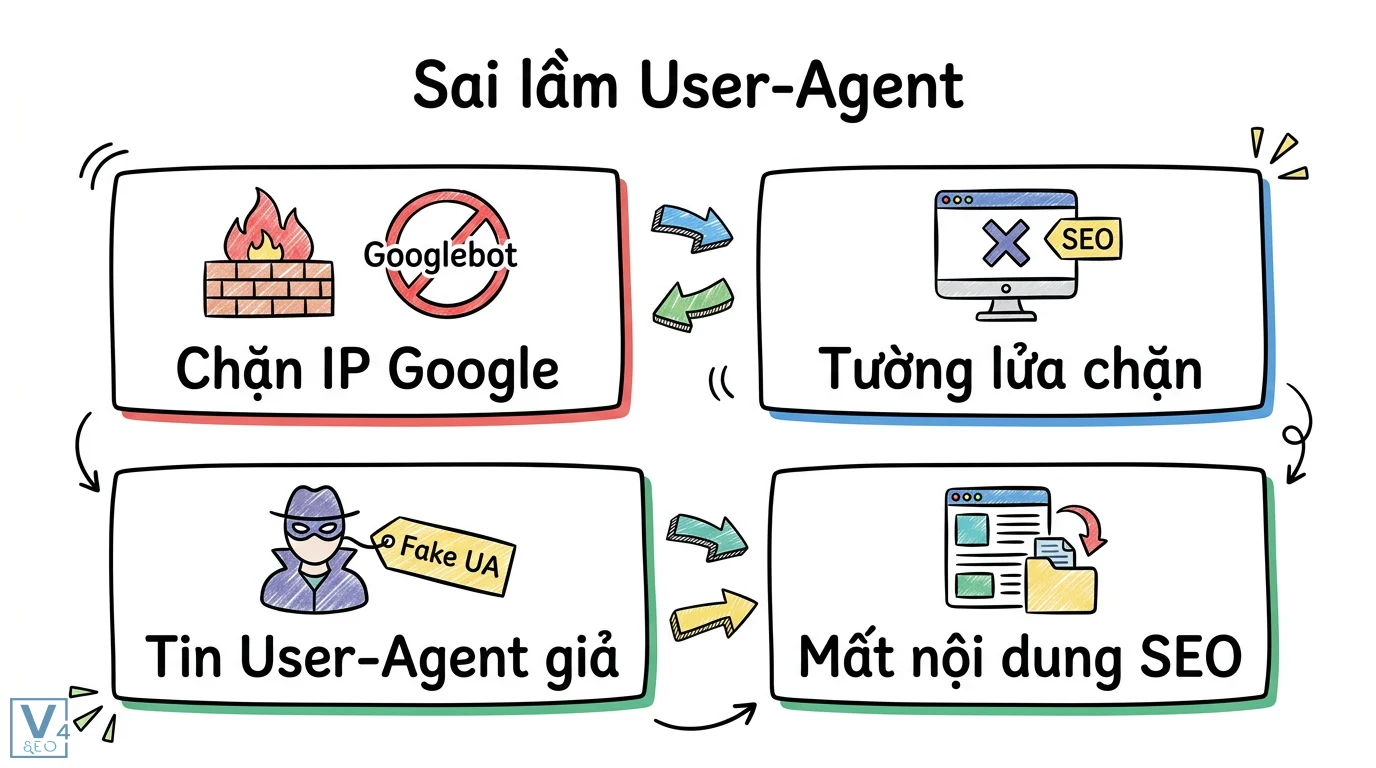
Sai lầm phổ biến nhất là thiết lập tường lửa (Firewall) quá khắt khe, vô tình chặn luôn các dải IP hợp lệ của Google. Điều này thường xảy ra khi hệ thống bảo mật tự động đánh dấu các lượt truy cập liên tục từ Googlebot là một cuộc tấn công từ chối dịch vụ.
Một rủi ro khác là việc chỉ tin tưởng vào chuỗi User-Agent mà bỏ qua bước xác minh IP. Nếu bạn cấu hình máy chủ ưu tiên hiển thị nội dung cho bất kỳ ai khai báo là "Googlebot", những kẻ cào dữ liệu giả mạo sẽ dễ dàng vượt qua lớp bảo vệ, sao chép toàn bộ nội dung độc quyền của bạn và xuất bản trên các trang web rác.
Câu hỏi thường gặp
Làm sao để chặn Googlebot giả mạo?
Để chặn các bot giả mạo, bạn cần kết hợp tra cứu DNS ngược để xác định các địa chỉ IP không thuộc quyền sở hữu của Google. Sau khi có danh sách IP giả, bạn có thể thêm chúng vào danh sách đen (blacklist) trong cấu hình tường lửa, tệp .htaccess (đối với Apache) hoặc cấu hình chặn trực tiếp trên Nginx.
Googlebot có truy cập vào tất cả các trang không?
Không. Googlebot hoạt động dựa trên ngân sách thu thập dữ liệu (crawl budget) được cấp cho từng website. Nếu trang web của bạn có cấu trúc liên kết nội bộ kém, tốc độ tải trang chậm hoặc bị chặn bởi tệp Robots.txt, bot sẽ rời đi trước khi kịp quét hết toàn bộ các trang con.
Sự khác biệt giữa Googlebot Desktop và Mobile là gì?
Sự khác biệt lớn nhất nằm ở cách chúng mô phỏng thiết bị người dùng. Googlebot Mobile sử dụng chuỗi User-Agent chứa thông tin của điện thoại thông minh và đánh giá trang web dựa trên trải nghiệm di động. Trong khi đó, phiên bản Desktop mô phỏng trình duyệt trên máy tính bàn. Hiện nay, Google ưu tiên lập chỉ mục trên thiết bị di động (Mobile-first indexing), nên bot Mobile sẽ hoạt động thường xuyên hơn.
Có nên chặn Googlebot không?
Trong hầu hết các trường hợp, bạn không nên chặn Googlebot nếu muốn trang web xuất hiện trên kết quả tìm kiếm. Bạn chỉ nên chặn bot đối với các môi trường thử nghiệm (staging site), các trang chứa thông tin cá nhân nội bộ, hoặc các trang kết quả tìm kiếm động trên website để tránh việc tạo ra nội dung trùng lặp.
Làm sao để biết Googlebot đang truy cập website?
Cách chính xác nhất là kiểm tra tệp nhật ký máy chủ (server logs) để xem các yêu cầu HTTP theo thời gian thực. Nếu bạn không rành về kỹ thuật, bạn có thể truy cập vào Google Search Console, mở mục "Cài đặt" và xem báo cáo "Thống kê thu thập dữ liệu" để theo dõi tần suất và lịch sử truy cập của bot trong 90 ngày gần nhất.
Kết luận
Hiểu rõ User-Agent Googlebot là gì và cách thức nó tương tác với máy chủ là nền tảng vững chắc cho mọi chiến lược SEO kỹ thuật. Bằng cách chủ động xác minh danh tính thông qua tra cứu DNS và theo dõi sát sao nhật ký máy chủ, bạn không chỉ bảo vệ website khỏi các rủi ro bảo mật mà còn đảm bảo Google luôn tiếp cận được những nội dung chất lượng nhất của bạn. Hãy bắt đầu bằng việc kiểm tra báo cáo thu thập dữ liệu trong Google Search Console ngay hôm nay để đánh giá tình trạng tương tác giữa website và các công cụ tìm kiếm.
Bài viết liên quan
https://seovietnam.vn/meta-robots-la-gi/