Nhiều chuyên gia SEO vẫn còn hoài nghi về giá trị của file PDF trong chiến lược nội dung, thường xem chúng là tài sản kỹ thuật số khó theo dõi và tối ưu. Tuy nhiên, bỏ qua PDF đồng nghĩa với việc bỏ lỡ một kênh tiềm năng để thu hút traffic và củng cố thẩm quyền chuyên môn. Giải đáp cho câu hỏi google có index pdf không là một lời khẳng định chắc chắn: Có, và chúng có thể xếp hạng rất tốt nếu được tối ưu đúng cách. Tại SEO Việt Nam, chúng tôi nhận thấy rằng việc tiếp cận PDF với tư duy kỹ thuật và phân tích dữ liệu có thể biến những tài liệu này thành một lợi thế cạnh tranh thực sự, đặc biệt là trong các lĩnh vực B2B, học thuật và tài chính. Google xử lý các loại file khác nhau theo những cách riêng, và hiểu rõ quy trình Index tài liệu là bước đầu tiên để làm chủ định dạng này.
Câu trả lời ngắn gọn: Google có index PDF không?
Google hoàn toàn có khả năng đọc và index nội dung trong các file PDF, miễn là chúng ở dạng văn bản (text-based) chứ không phải là một file ảnh quét. Googlebot sẽ chuyển đổi file PDF thành HTML để xử lý, trích xuất văn bản, liên kết và các yếu tố khác để đưa vào chỉ mục. Về cơ bản, Google xem một file PDF được tối ưu tốt gần như tương đương với một trang web thông thường, có khả năng xếp hạng cho các truy vấn liên quan và xuất hiện trong kết quả tìm kiếm.

Chẩn đoán tình trạng index PDF hiện tại với Google search console (GSC)
Trước khi tối ưu, cần xác định xem Google đã tìm thấy và index các file PDF trên website của bạn hay chưa.
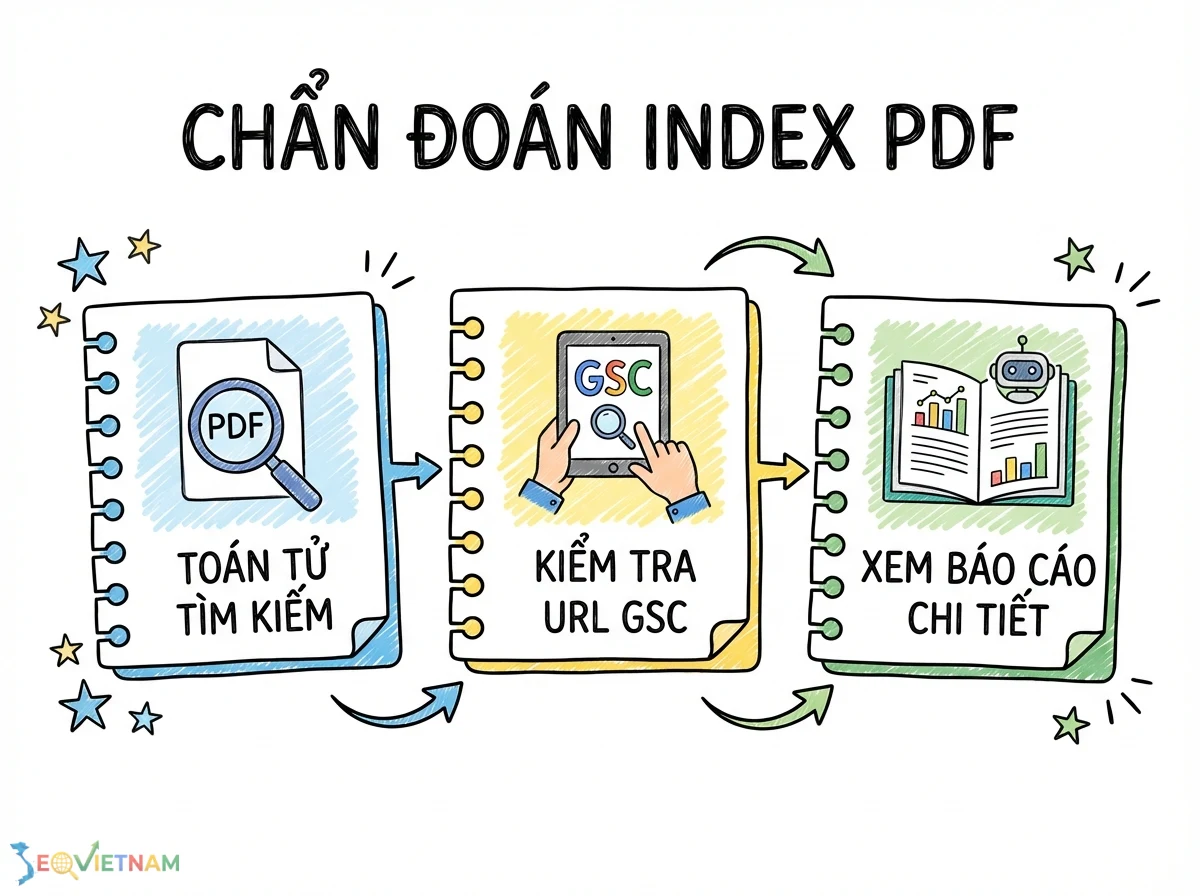
Kiểm tra bằng toán tử tìm kiếm: Sử dụng toán tử site:yourdomain.com filetype:pdf trực tiếp trên Google Search. Lệnh này sẽ liệt kê tất cả các file PDF từ tên miền của bạn mà Google đã index. Đây là cách nhanh nhất để có cái nhìn tổng quan.
Sử dụng công cụ URL Inspection: Để kiểm tra một URL PDF cụ thể, hãy dán URL đó vào thanh công cụ URL Inspection trong GSC. Báo cáo sẽ cho bạn biết trạng thái index chi tiết, bao gồm lần thu thập dữ liệu cuối cùng, trang giới thiệu (referring page), và liệu URL có đủ điều kiện để xuất hiện trên Google hay không.
Quy trình tối ưu SEO on-page nâng cao cho file PDF
Tối ưu on-page cho PDF không chỉ dừng lại ở nội dung. Các thuộc tính ẩn của file và cấu trúc bên trong đóng vai trò quan trọng.
Tối ưu thuộc tính metadata của tài liệu (document properties)
Metadata của file PDF hoạt động tương tự như thẻ meta trên một trang HTML. Bạn có thể chỉnh sửa chúng bằng các công cụ như Adobe Acrobat Pro.
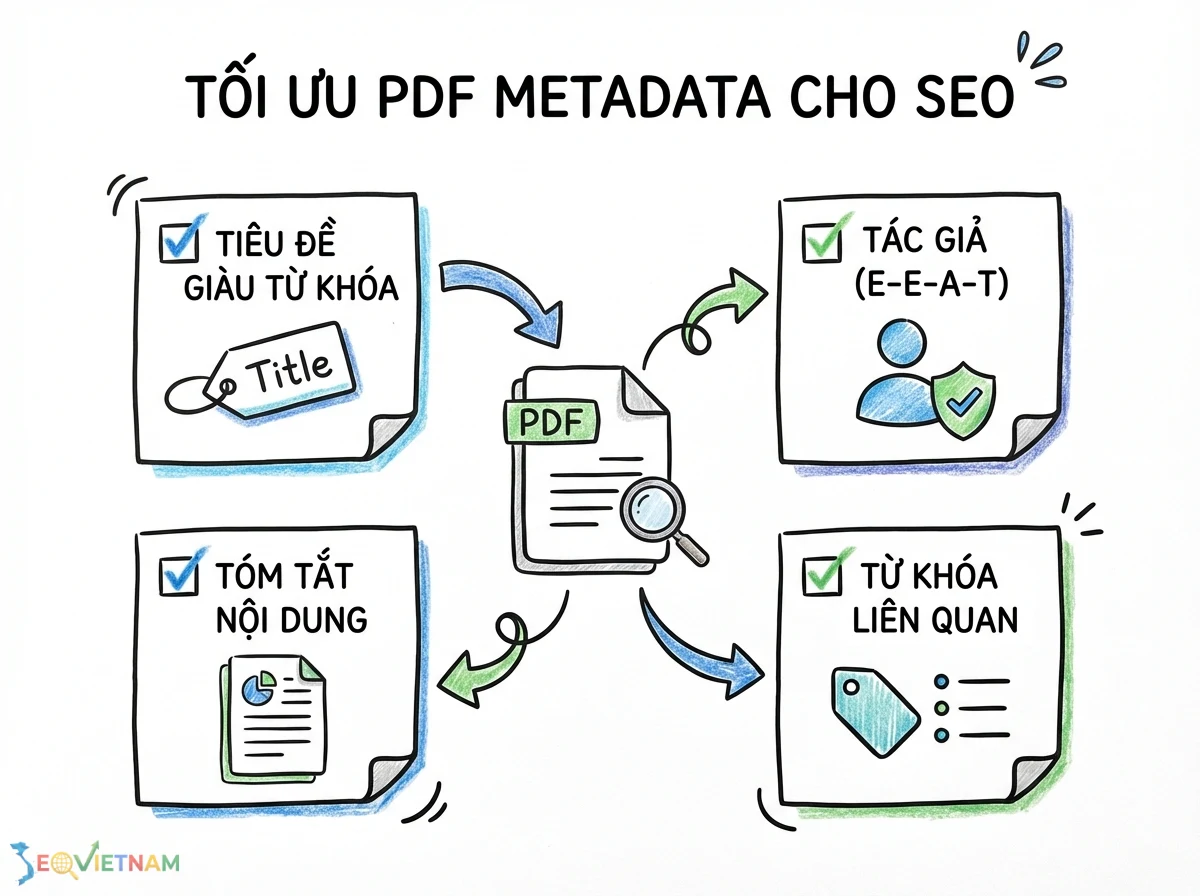
Title: Đây là yếu tố quan trọng nhất, tương đương với thẻ <title>. Hãy đặt một tiêu đề giàu từ khóa, mô tả chính xác nội dung tài liệu. Author: Ghi rõ tác giả hoặc tên thương hiệu để tăng cường tín hiệu về E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness). Subject: Tương đương với thẻ Meta Description, cung cấp một bản tóm tắt ngắn gọn về nội dung. Keywords: Mặc dù Google không còn phụ thuộc nhiều vào thẻ meta keywords, việc điền các từ khóa chính và phụ liên quan vẫn là một thực hành tốt.
Tối ưu nội dung và cấu trúc bên trong file PDF
Chất lượng và cấu trúc nội dung là yếu tố quyết định khả năng xếp hạng.
Nội dung dựa trên văn bản: Đảm bảo toàn bộ văn bản trong PDF có thể chọn và sao chép được. Nếu PDF được tạo từ việc quét tài liệu giấy, hãy sử dụng công nghệ Nhận dạng ký tự quang học (OCR) để chuyển đổi hình ảnh thành văn bản. Cấu trúc Heading: Sử dụng các thẻ heading (H1, H2, H3) một cách có cấu trúc trong chương trình soạn thảo (Word, Google Docs) trước khi xuất ra PDF. Điều này giúp Google hiểu được hệ thống phân cấp thông tin. Tối ưu hình ảnh: Đặt Alt Text cho tất cả hình ảnh trong file PDF. Hầu hết các trình soạn thảo hiện đại đều cho phép thêm văn bản thay thế trước khi xuất file. Đồng thời, nén hình ảnh để giảm dung lượng tổng thể của file. Quá trình Tối ưu tệp tin bao gồm cả việc đặt tên file ảnh và thuộc tính của nó. Liên kết nội bộ và bên ngoài: Chèn các liên kết có liên quan vào nội dung PDF, bao gồm cả liên kết nội bộ đến các trang khác trên website của bạn và liên kết ngoài đến các nguồn uy tín. Đảm bảo anchor text mang tính mô tả.
Kiểm soát crawling và indexing PDF chuyên sâu
Không phải lúc nào bạn cũng muốn Google index mọi file PDF. Việc kiểm soát chủ động giúp tránh các vấn đề về nội dung trùng lặp hoặc lộ thông tin không mong muốn.
Sử dụng tệp robots.txt để quản lý bot truy cập
Nếu bạn muốn chặn Googlebot truy cập vào một thư mục chứa nhiều file PDF hoặc tất cả các file PDF trên trang, hãy sử dụng tệp robots.txt.
Để chặn tất cả file PDF:
User-agent: Googlebot
Disallow: /*.pdf$
Lệnh này sử dụng biểu thức chính quy ($) để chỉ định các URL kết thúc bằng .pdf.
Sử dụng X-Robots-Tag HTTP header để kiểm soát index
X-Robots-Tag là phương pháp linh hoạt và hiệu quả nhất để kiểm soát việc index từng file PDF riêng lẻ. Vì PDF không có phần <head> như HTML, bạn không thể dùng thẻ meta robots. Thay vào đó, bạn cấu hình thẻ này trong phản hồi HTTP của máy chủ.
Ví dụ trong tệp .htaccess cho máy chủ Apache để noindex một file cụ thể:
<Files "ten-file-can-noindex.pdf">
Header set X-Robots-Tag "noindex, follow"
</Files>
Lệnh này yêu cầu Google không index file PDF nhưng vẫn "follow" các liên kết bên trong nó.
Theo dõi hiệu suất PDF bằng GA4 và GTM
Một trong những thách thức lớn nhất với PDF là theo dõi tương tác của người dùng. Google Analytics 4 (GA4) kết hợp với Google Tag Manager (GTM) cung cấp một giải pháp mạnh mẽ.
Bước 1: Cấu hình Trigger trong GTM: Tạo một trigger loại "Click – Just Links". Thiết lập trigger này để kích hoạt khi "Click URL" chứa đuôi .pdf. Bước 2: Tạo Tag GA4 Event: Tạo một tag mới loại "Google Analytics: GA4 Event". Liên kết nó với trigger vừa tạo. Đặt tên sự kiện là pdf_download. Bước 3: Thêm các tham số sự kiện: Để báo cáo chi tiết hơn, hãy thêm các tham số như file_name (sử dụng biến Click URL hoặc Click Text) và link_text để biết người dùng đã nhấp vào anchor text nào. Bước 4: Xuất bản và kiểm tra: Sau khi xuất bản container GTM, bạn có thể sử dụng chế độ Debug View trong GA4 để xác nhận rằng sự kiện pdf_download được ghi nhận mỗi khi ai đó nhấp vào một liên kết PDF.
Xử lý sự cố khi PDF không được index: bảng chẩn đoán và giải pháp
Khi một file PDF không xuất hiện trên Google, hãy sử dụng bảng dưới đây để chẩn đoán và khắc phục một cách có hệ thống.
|
Lỗi |
Dấu hiệu |
Nguyên nhân |
Cách khắc phục |
Mức độ ưu tiên |
|
Bị chặn bởi robots.txt |
URL bị đánh dấu "Bị chặn bởi robots.txt" trong GSC. |
Lệnh Disallow trong tệp robots.txt đang chặn URL hoặc thư mục chứa PDF. |
Xóa hoặc chỉnh sửa lệnh Disallow trong robots.txt để cho phép Googlebot truy cập. |
Cao |
|
Có thẻ X-Robots-Tag noindex |
URL được thu thập dữ liệu nhưng không được index, GSC báo "Bị loại trừ bởi thẻ ‘noindex’". |
Phản hồi HTTP header của file PDF chứa X-Robots-Tag: noindex. |
Kiểm tra cấu hình máy chủ (ví dụ: file .htaccess) và gỡ bỏ hoặc thay đổi header X-Robots-Tag. |
Cao |
|
Nội dung là hình ảnh |
File PDF được index nhưng không xếp hạng cho các từ khóa văn bản. |
PDF được tạo từ việc quét tài liệu mà không qua xử lý OCR. Google không đọc được văn bản. |
Sử dụng công cụ có OCR để chuyển đổi PDF dạng ảnh thành dạng văn bản có thể tìm kiếm. |
Cao |
|
Không có liên kết nội bộ |
PDF không được GSC phát hiện hoặc có rất ít traffic. |
Không có trang nào trên website của bạn liên kết đến file PDF này. |
Thêm các liên kết nội bộ từ các bài viết, trang sản phẩm có liên quan trỏ đến file PDF với anchor text mô tả. |
Trung bình |
|
Kích thước file quá lớn |
Googlebot có thể bỏ qua hoặc xử lý không đầy đủ. Thời gian tải chậm cho người dùng. |
File chứa hình ảnh độ phân giải cao không được nén, hoặc nội dung quá dài. |
Nén hình ảnh, tối ưu hóa file PDF bằng các công cụ chuyên dụng để giảm dung lượng mà không ảnh hưởng chất lượng. |
Trung bình |
So sánh tối ưu PDF và tối ưu trang HTML
Việc lựa chọn giữa việc xuất bản nội dung dưới dạng PDF hay trang HTML phụ thuộc vào mục tiêu và đối tượng của bạn.
|
Tiêu chí |
Tối ưu trang HTML |
Tối ưu file PDF |
Gợi ý chọn |
|
Khả năng responsive |
Cao, tự động thích ứng với mọi kích thước màn hình. |
Thấp, bố cục cố định, khó đọc trên thiết bị di động. |
HTML cho nội dung blog, trang sản phẩm, trang dịch vụ. |
|
Khả năng theo dõi hành vi |
Rất cao, có thể theo dõi cuộn trang, thời gian trên trang, nhấp chuột chi tiết. |
Hạn chế, chủ yếu chỉ theo dõi được lượt tải xuống hoặc lượt xem. |
HTML khi cần phân tích sâu về hành vi người dùng. |
|
Khả năng chia sẻ và in ấn |
Dễ chia sẻ qua URL nhưng định dạng khi in có thể bị vỡ. |
Dễ dàng tải xuống, chia sẻ và in ấn với định dạng được bảo toàn. |
PDF cho Sách trắng (Whitepaper), Báo cáo, Biểu mẫu, Ebook. |
|
Mức độ phức tạp khi cập nhật |
Dễ dàng, có thể cập nhật nhanh chóng thông qua CMS. |
Khó khăn, cần chỉnh sửa file gốc và tải lên lại phiên bản mới. |
HTML cho nội dung cần cập nhật thường xuyên. |
|
Tối ưu cho Featured Snippet |
Rất tốt, cấu trúc HTML (bảng, danh sách) dễ dàng được Google trích xuất. |
Khó hơn, Google vẫn có thể trích xuất nhưng ít phổ biến hơn. |
HTML khi mục tiêu là chiếm lĩnh vị trí Featured Snippet. |
Checklist tối ưu SEO kỹ thuật cho file PDF toàn diện 2026
Sử dụng checklist này để đảm bảo không bỏ sót bất kỳ yếu tố quan trọng nào trong quá trình tối ưu.
|
Hạng mục |
Chi tiết thực hiện |
Mức độ ưu tiên |
|
Tên file |
Sử dụng từ khóa chính, viết liền không dấu, ngăn cách bằng dấu gạch ngang (ví dụ: huong-dan-seo-pdf-2026.pdf). |
Cao |
|
Metadata |
Điền đầy đủ các trường Title, Author, Subject, Keywords trong Document Properties. |
Cao |
|
Nội dung |
Đảm bảo nội dung là văn bản (text-based), có cấu trúc heading rõ ràng. |
Cao |
|
Hình ảnh |
Đặt Alt Text cho tất cả hình ảnh và nén để tối ưu dung lượng. |
Trung bình |
|
Liên kết nội bộ |
Đặt ít nhất một liên kết nội bộ từ các trang có liên quan trỏ đến file PDF. |
Cao |
|
Dung lượng file |
Giữ dung lượng file ở mức thấp nhất có thể (lý tưởng là dưới 10MB) để tăng tốc độ tải. |
Trung bình |
|
Sitemap |
Thêm URL của file PDF vào tệp sitemap.xml để thông báo cho Google. |
Trung bình |
|
Kiểm tra GSC |
Gửi URL để kiểm tra và yêu cầu index thông qua công cụ URL Inspection. |
Cao |
|
Cấu hình Index |
Sử dụng X-Robots-Tag để kiểm soát việc index thay vì chặn bằng robots.txt (nếu cần). |
Cao |
|
Theo dõi hiệu suất |
Cài đặt theo dõi sự kiện tải PDF qua GTM và GA4 để đo lường hiệu quả. |
Trung bình |
Lời khuyên chuyên gia: Khi nào nên noindex PDF?
Mặc dù việc index PDF mang lại nhiều lợi ích, có những trường hợp chiến lược tốt nhất là chủ động không cho index chúng.
Nội dung trùng lặp: Nếu file PDF là phiên bản tải về của một bài viết đã tồn tại trên blog dưới dạng HTML, hãy noindex file PDF và đặt thẻ canonical trên trang HTML để hợp nhất tín hiệu. Nội dung độc quyền (gated content): Đối với các tài liệu như whitepaper hay ebook yêu cầu người dùng điền form để nhận, bạn nên noindex chúng. Mục đích là để người dùng truy cập trang landing page thay vì file PDF trực tiếp từ kết quả tìm kiếm. Tài liệu nội bộ: Các tài liệu như báo giá, hợp đồng mẫu, hướng dẫn nội bộ tuyệt đối không nên được index. Hãy chặn chúng bằng cả robots.txt và X-Robots-Tag để đảm bảo an toàn.
Kết luận
Tóm lại, Google không chỉ có khả năng index PDF mà còn có thể xếp hạng chúng cho các truy vấn có giá trị. Thay vì xem PDF là một định dạng lỗi thời, các chuyên gia SEO hiện đại cần coi chúng là một phần không thể thiếu của một chiến lược nội dung toàn diện. Bằng cách áp dụng các kỹ thuật tối ưu on-page, kiểm soát index chặt chẽ qua X-Robots-Tag, và theo dõi hiệu suất bằng GA4, bạn có thể khai thác tối đa tiềm năng của loại tài sản này. Một chiến lược SEO PDF hiệu quả, cập nhật 2026, là sự kết hợp giữa tối ưu kỹ thuật và phân tích dữ liệu để mang lại kết quả rõ ràng.
Bài viết liên quan
https://seovietnam.vn/google-index-trang-nhu-the-nao/