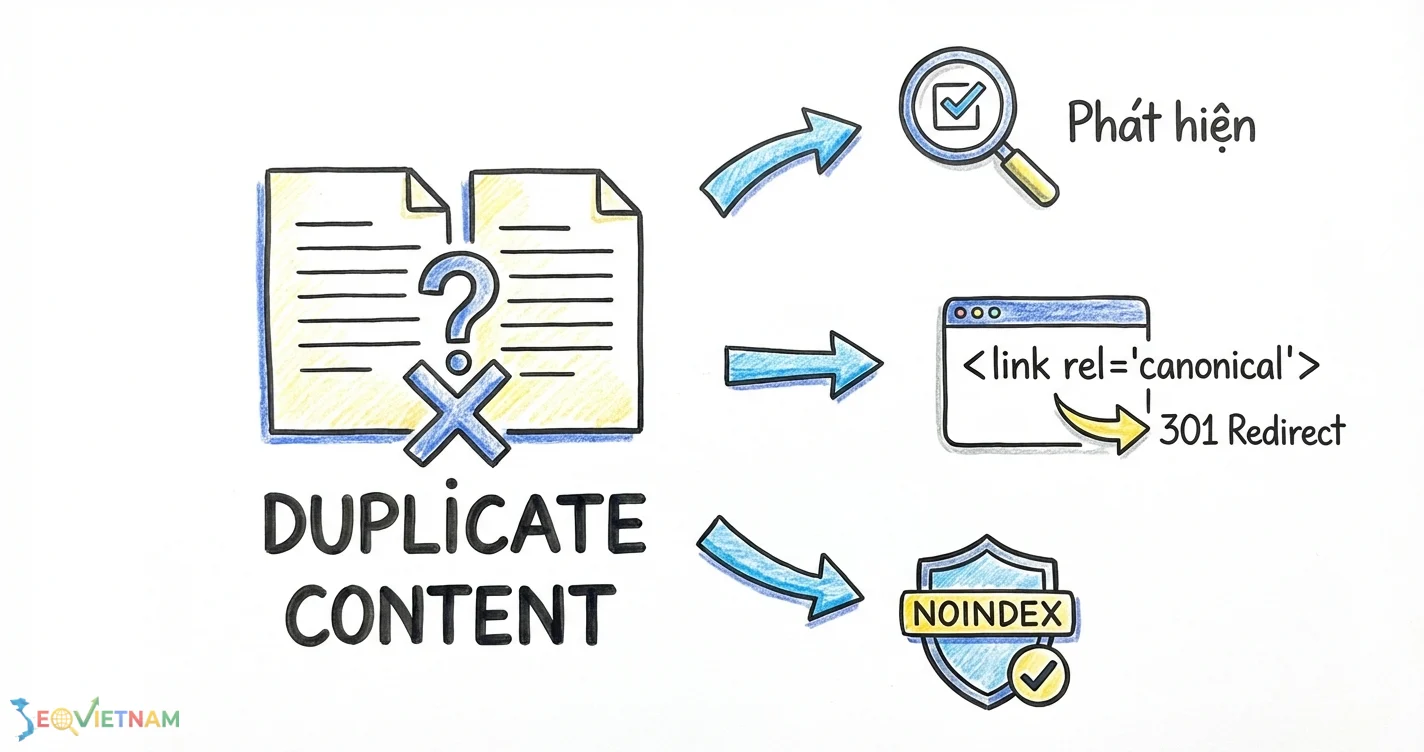
Việc phát hiện website sụt giảm traffic không rõ nguyên nhân là một trong những thách thức lớn nhất của người làm SEO. Thủ phạm thường ẩn sâu trong các vấn đề kỹ thuật, và một trong những lỗi phổ biến nhưng nguy hiểm nhất chính là trùng lặp nội dung. Hiểu rõ duplicate content là gì không chỉ là kiến thức nền tảng mà còn là chìa khóa để bảo vệ và tối ưu hóa hiệu suất website một cách bền vững. Vấn đề này không phải là một hình phạt trực tiếp từ Google, mà là một bài toán về hiệu quả thu thập dữ liệu và hợp nhất tín hiệu xếp hạng. Tại SEO Việt Nam, chúng tôi nhận thấy rằng việc xử lý triệt để duplicate content có thể mang lại những cải thiện rõ rệt về thứ hạng và traffic.
Duplicate content là gì? Hiểu rõ bản chất và các dạng phổ biến
Duplicate content (nội dung trùng lặp) là tình trạng một hoặc nhiều khối nội dung đáng kể hoàn toàn giống nhau hoặc tương tự nhau xuất hiện trên nhiều URL khác nhau, có thể trong cùng một website hoặc trên nhiều website khác nhau. Google định nghĩa "đáng kể" là các khối nội dung không có sự thay đổi mang tính giá trị hoặc khác biệt cho người dùng. Việc này tạo ra sự mơ hồ cho công cụ tìm kiếm khi phải quyết định phiên bản nào là gốc để lập chỉ mục và xếp hạng.
Các dạng duplicate content thường gặp
Duplicate content được phân thành hai nhóm chính dựa trên nguồn gốc của nó: nội bộ và bên ngoài.
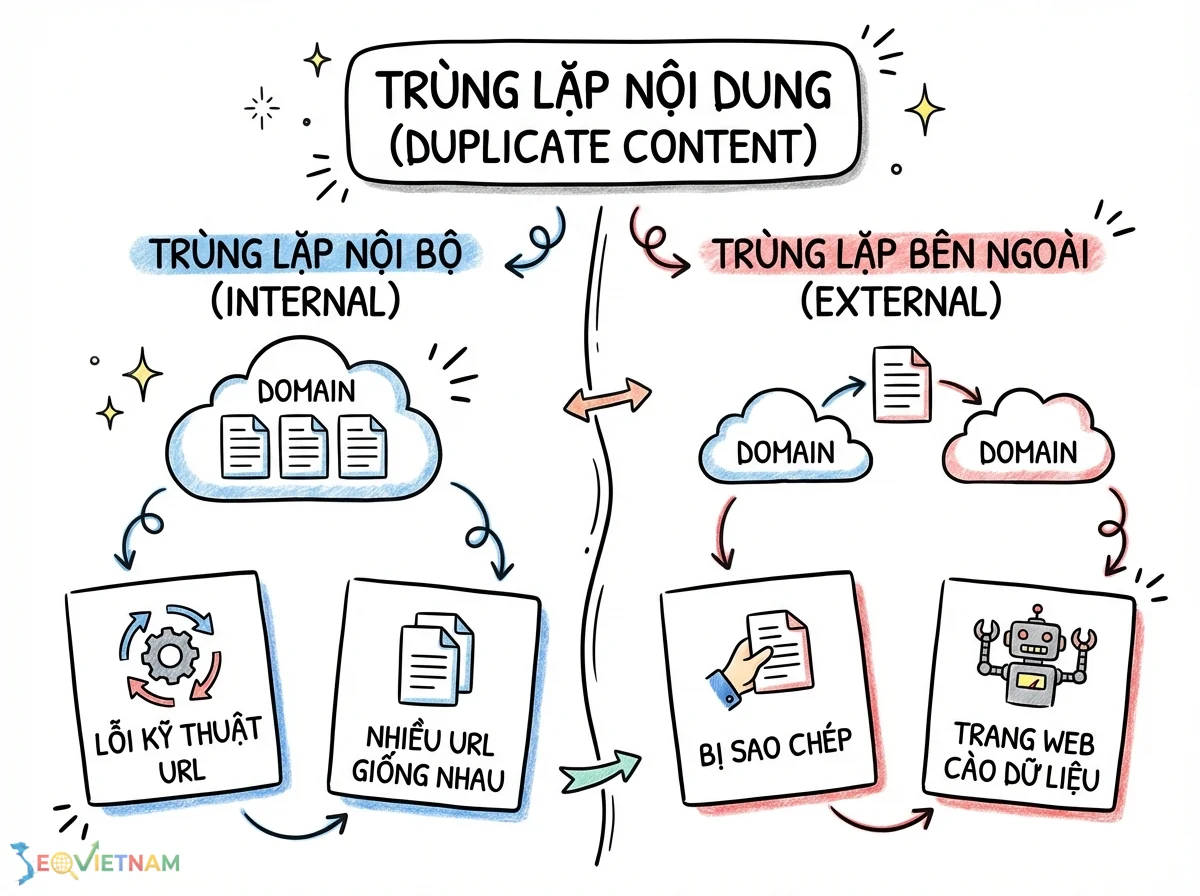
Trùng lặp nội bộ (Internal Duplicate): Đây là dạng phổ biến nhất, xảy ra khi nội dung giống hệt nhau tồn tại trên nhiều URL trong cùng một tên miền. Các nguyên nhân kỹ thuật thường là thủ phạm chính, tạo ra các phiên bản URL khác nhau cho cùng một nội dung mà quản trị viên web không hề hay biết.
Trùng lặp bên ngoài (External Duplicate): Dạng này xảy ra khi nội dung của bạn bị sao chép và xuất bản trên một tên miền khác. Điều này có thể do đối tác phân phối lại nội dung (content syndication), các trang web cào dữ liệu (scrapers), hoặc thậm chí là do sao chép không ghi nguồn.
Nguyên nhân kỹ thuật gây ra duplicate content
Hầu hết các trường hợp trùng lặp nội dung không phải do cố ý mà xuất phát từ các cấu hình kỹ thuật chưa chuẩn.
Tham số URL (URL Parameters): Các tham số dùng để theo dõi (UTM), sắp xếp (?sort=price), hoặc lọc sản phẩm (?color=blue) có thể tạo ra vô số URL khác nhau cho cùng một trang.
Session IDs: Một số hệ thống cũ vẫn nhúng ID phiên của người dùng trực tiếp vào URL, tạo ra một URL mới cho mỗi lần truy cập.
Các biến thể tên miền: Các phiên bản http://, https://, www. và non-www của cùng một trang nếu không được hợp nhất đúng cách sẽ bị coi là các URL riêng biệt.
Nội dung cho các phiên bản khác nhau: Các trang dành cho phiên bản in (/print/), phiên bản di động (m-dot), hoặc trang AMP có thể tạo ra nội dung trùng lặp nếu không được cấu hình thẻ canonical chính xác.
Phân trang (Pagination): Các trang danh mục sản phẩm hoặc bài viết được chia thành nhiều trang (page 1, page 2,…) có thể chứa các đoạn mô tả danh mục, tiêu đề giống hệt nhau, gây ra trùng lặp một phần.
Tác hại của duplicate content đến hiệu suất SEO
Mặc dù Google tuyên bố không có "hình phạt" trực tiếp cho duplicate content, những tác động tiêu cực của nó đến SEO là rất rõ ràng và có thể gây thiệt hại nghiêm trọng.
Suy giảm crawl budget và hiệu quả thu thập dữ liệu
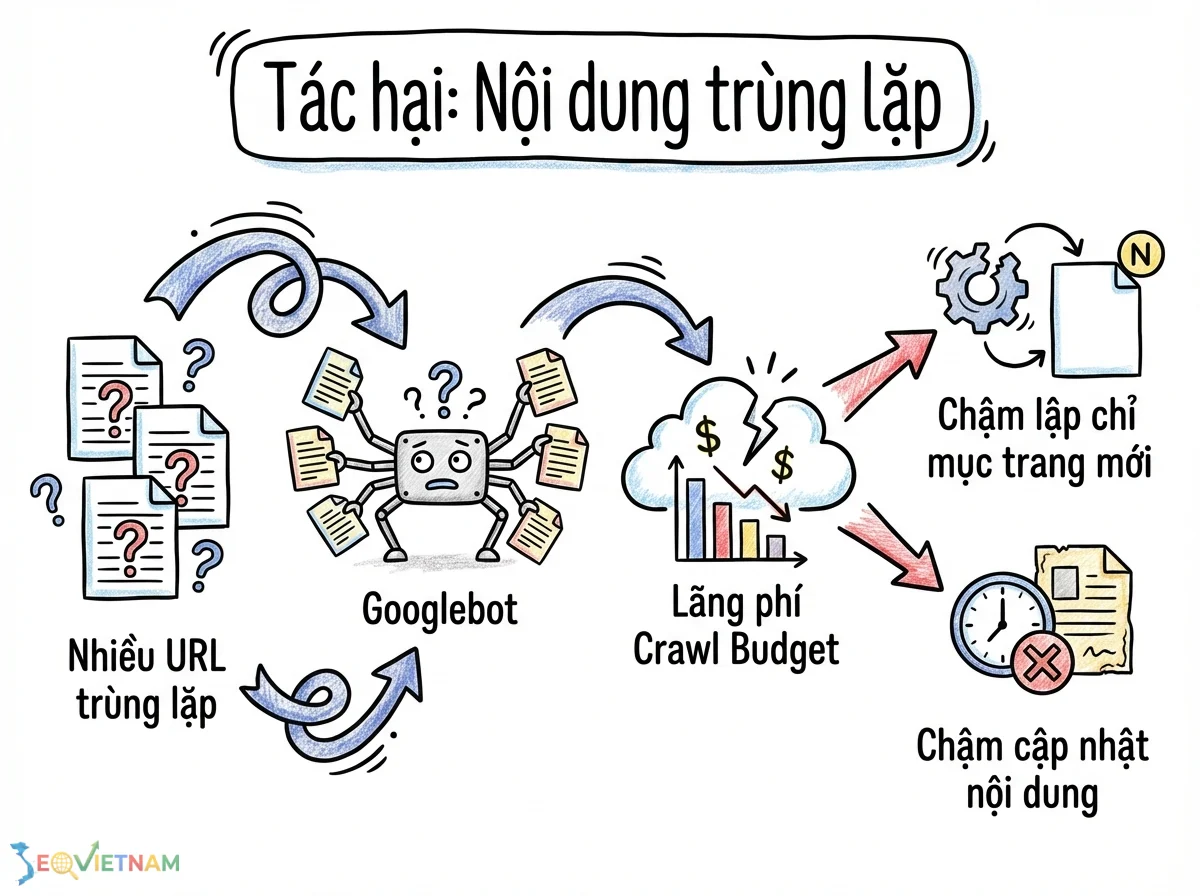
Crawl budget là số lượng URL mà Googlebot có thể và muốn thu thập trên website của bạn trong một khoảng thời gian nhất định. Khi có quá nhiều URL trùng lặp, Googlebot sẽ lãng phí tài nguyên để thu thập và xử lý các trang giống hệt nhau, thay vì dành thời gian đó để khám phá và lập chỉ mục các nội dung mới, quan trọng. Điều này làm chậm quá trình index các trang mới và cập nhật nội dung cũ.
Phân tán tín hiệu xếp hạng và gây nhầm lẫn
Khi nhiều URL cùng chứa một nội dung, các tín hiệu xếp hạng quan trọng như backlink, internal link, và tương tác người dùng sẽ bị phân tán trên tất cả các phiên bản đó. Thay vì tập trung toàn bộ "link equity" vào một URL duy nhất để nó có thứ hạng cao, sức mạnh lại bị chia nhỏ, khiến không phiên bản nào đủ mạnh để cạnh tranh trên SERP. Google cũng sẽ bối rối trong việc chọn ra URL "chính chủ" để hiển thị, dẫn đến việc xếp hạng sai URL hoặc thứ hạng không ổn định.
Hướng dẫn phát hiện duplicate content chính xác
Phát hiện sớm và chính xác các vấn đề trùng lặp là bước đầu tiên để khắc phục hiệu quả.
Sử dụng toán tử tìm kiếm Google và công cụ miễn phí
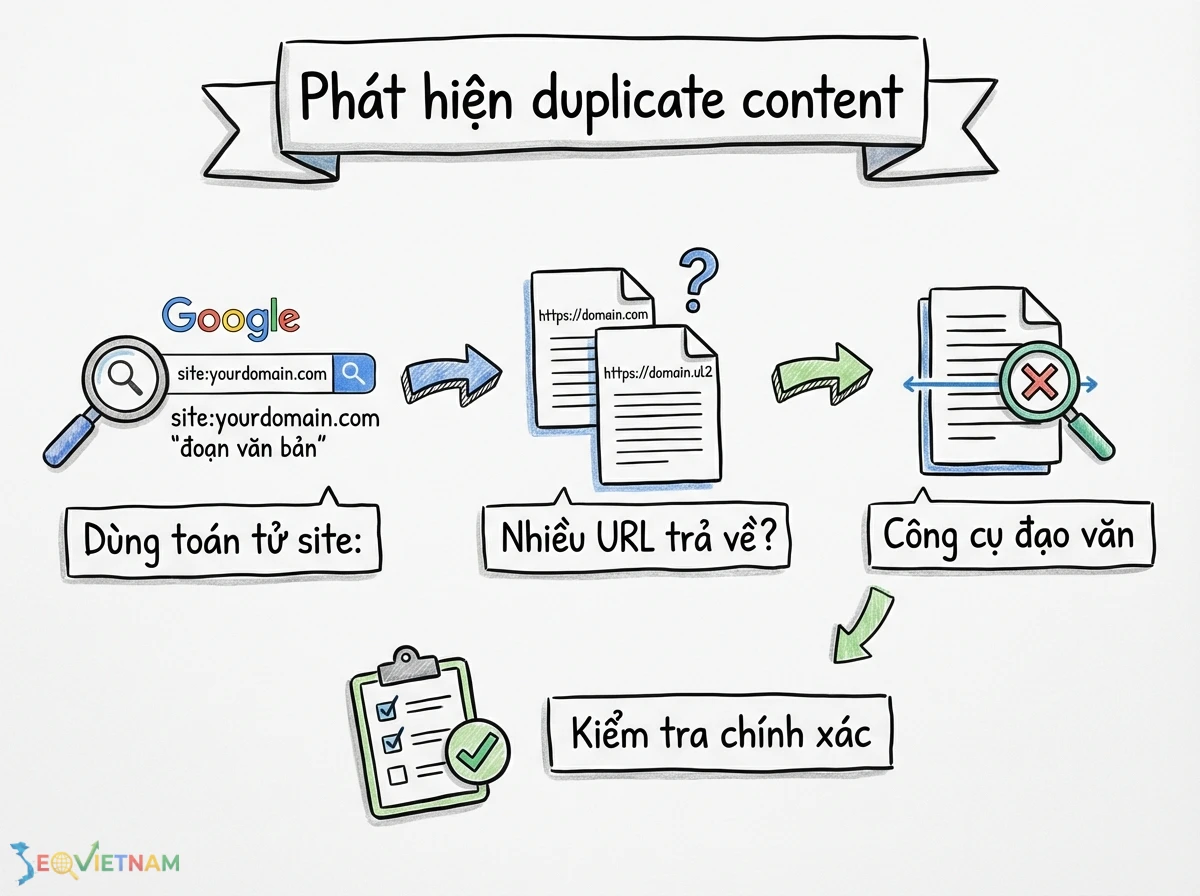
Một cách nhanh chóng để kiểm tra là sử dụng toán tử site:. Gõ site:yourdomain.com "một đoạn văn bản đặc trưng" vào ô tìm kiếm Google. Nếu kết quả trả về nhiều hơn một URL, bạn đã có vấn đề về trùng lặp nội dung. Các công cụ kiểm tra đạo văn miễn phí cũng có thể giúp phát hiện nội dung của bạn có bị sao chép trên các website khác hay không.
Tận dụng Google Search Console và các công cụ chuyên nghiệp
Google Search Console (GSC) là công cụ không thể thiếu. Trong báo cáo "Trang" (Pages), hãy lọc các URL không được lập chỉ mục với lý do "Trang thay thế có thẻ chuẩn chính tắc" (Alternate page with proper canonical tag) hoặc "Bản sao, Google đã chọn một trang chuẩn khác với trang người dùng đã chọn" (Duplicate, Google chose different canonical than user). Đối với các phân tích sâu hơn, các công cụ như Screaming Frog SEO Spider, Ahrefs' Site Audit, hoặc Semrush's Site Audit cung cấp các báo cáo chi tiết về các URL trùng lặp và bán trùng lặp.
Giải pháp kỹ thuật toàn diện để khắc phục duplicate content
Việc lựa chọn giải pháp phụ thuộc vào nguyên nhân và bối cảnh cụ thể của từng trường hợp. Không có một giải pháp nào phù hợp cho tất cả.
Canonical tag (): Giải pháp ưu tiên hàng đầu
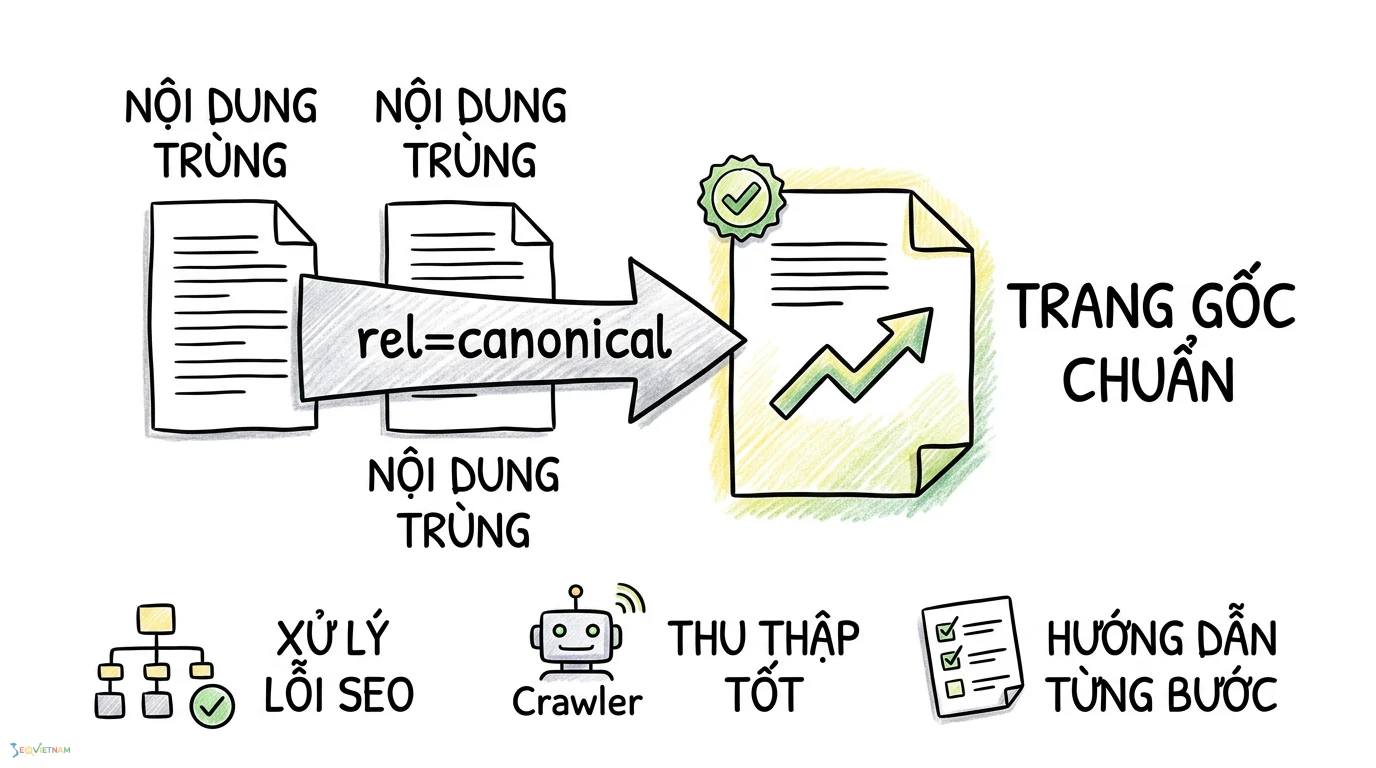
Thẻ canonical là một đoạn mã HTML chỉ định cho công cụ tìm kiếm biết đâu là phiên bản "chính" hoặc "ưu tiên" của một trang. Đây là phương pháp phổ biến và hiệu quả nhất để xử lý hầu hết các trường hợp trùng lặp nội dung nội bộ. Việc thực hiện đúng kỹ thuật Canonical hóa giúp hợp nhất các tín hiệu xếp hạng vào một URL duy nhất.
Triển khai trong HTML: Đặt đoạn mã sau vào trong thẻ <head> của các phiên bản trùng lặp: <link rel="canonical" href="https://example.com/url-chinh-chu/" />
Triển khai trong HTTP Header: Đối với các tệp không phải HTML như PDF, bạn có thể chỉ định canonical trong phản hồi HTTP header của máy chủ: Link: <https://example.com/download.pdf/>; rel="canonical"
Chuyển hướng 301 (301 redirect): Hợp nhất vĩnh viễn
Khi bạn có nhiều URL cũ không còn sử dụng nhưng vẫn có backlink trỏ về, chuyển hướng 301 là lựa chọn tốt nhất. Nó sẽ chuyển hướng cả người dùng và công cụ tìm kiếm đến URL chính một cách vĩnh viễn, đồng thời chuyển giao phần lớn giá trị xếp hạng. Đây là giải pháp triệt để cho việc Hợp nhất URL, đặc biệt khi xử lý các phiên bản WWW/non-WWW hoặc HTTP/HTTPS.
Triển khai trên Apache (.htaccess): RewriteEngine On RewriteCond %{HTTP_HOST} ^example.com [NC] RewriteRule ^(.*)$ https://www.example.com/$1 [L,R=301,NC]
Triển khai trên Nginx (nginx.conf): server { server_name example.com; return 301 https://www.example.com$request_uri; }
Meta robots (noindex): Ngăn chặn index các trang không cần thiết
Đối với các trang không mang lại giá trị SEO và bạn không muốn chúng xuất hiện trên kết quả tìm kiếm (ví dụ: trang kết quả tìm kiếm nội bộ, trang giỏ hàng tạm thời), sử dụng thẻ meta robots noindex là phù hợp. Thẻ này yêu cầu Google không lập chỉ mục trang, nhưng vẫn có thể cho phép Google theo dõi các liên kết trên trang đó (nếu dùng follow).
Triển khai: <meta name="robots" content="noindex, follow">
Tệp robots.txt: Kiểm soát truy cập của crawler
Sử dụng robots.txt để chặn Googlebot thu thập dữ liệu của các URL hoặc thư mục gây ra trùng lặp hàng loạt (ví dụ: các URL chứa tham số lọc vô tận). Tuy nhiên, cần lưu ý rằng robots.txt chỉ ngăn chặn việc thu thập dữ liệu, không ngăn chặn việc lập chỉ mục nếu URL đó nhận được liên kết từ nơi khác. Đây là một công cụ mạnh nhưng cần sử dụng cẩn thận.
Ví dụ chặn tất cả URL chứa tham số sort: User-agent: * Disallow: /*?sort=
Bảng tổng hợp quyết định: nên dùng giải pháp nào?
Việc lựa chọn phương án chính xác là cực kỳ quan trọng. Bảng dưới đây cung cấp một khung tham chiếu nhanh để đưa ra quyết định phù hợp cho từng kịch bản.
|
Tình huống |
Giải pháp đề xuất |
Lý do |
Lưu ý quan trọng |
|
Các URL tham số (lọc, sắp xếp) hiển thị cùng nội dung |
Canonical Tag |
Giữ lại các URL chức năng cho người dùng nhưng hợp nhất tín hiệu SEO về trang chính. |
Đảm bảo URL canonical là phiên bản sạch, không chứa tham số. |
|
Chuyển từ HTTP sang HTTPS hoặc WWW sang non-WWW |
301 Redirect |
Hợp nhất vĩnh viễn tất cả các phiên bản về một URL chuẩn duy nhất, chuyển giao sức mạnh. |
Triển khai trên toàn trang (site-wide) và kiểm tra kỹ lưỡng. |
|
Các trang không có giá trị SEO (kết quả tìm kiếm nội bộ, trang admin) |
Meta Robots noindex |
Ngăn các trang này xuất hiện trên SERP và làm loãng chất lượng tổng thể của website. |
Không chặn các trang này trong robots.txt để Googlebot có thể thấy chỉ thị noindex. |
|
Nội dung được phân phối lại trên website đối tác |
Canonical Tag |
Cho phép đối tác sử dụng nội dung nhưng đảm bảo Google biết bạn là nguồn gốc, tín hiệu xếp hạng trỏ về bạn. |
Yêu cầu đối tác thêm thẻ canonical trỏ về bài viết gốc của bạn. |
|
Di chuyển hoặc xóa vĩnh viễn một trang có backlink giá trị |
301 Redirect |
Chuyển hướng người dùng và tín hiệu SEO đến một trang liên quan nhất còn tồn tại. |
Tránh chuyển hướng đến trang chủ nếu không có trang thay thế phù hợp. |
Các sai lầm phổ biến cần tránh khi xử lý duplicate content
Khắc phục Trùng lặp nội dung không đúng cách có thể gây ra những vấn đề còn nghiêm trọng hơn. Dưới đây là bảng tổng hợp các lỗi thường gặp và cách phòng tránh.
|
Lỗi thường gặp |
Hậu quả |
Nguyên nhân |
Cách khắc phục |
Mức độ ưu tiên |
|
Chặn URL đã được canonical trong robots.txt |
Google không thể thấy thẻ canonical, dẫn đến việc bỏ qua chỉ thị và vẫn có thể index trang trùng lặp. |
Hiểu lầm rằng cần chặn cả việc thu thập dữ liệu. |
Luôn cho phép Googlebot thu thập dữ liệu các URL có chứa thẻ canonical để nó có thể đọc và xử lý chỉ thị. |
Cao |
|
Sử dụng chuyển hướng 302 thay vì 301 |
Tín hiệu xếp hạng không được chuyển giao đầy đủ vì 302 là chuyển hướng tạm thời. |
Cấu hình sai trên máy chủ hoặc sử dụng plugin không đúng cách. |
Luôn sử dụng 301 cho các thay đổi URL vĩnh viễn. Kiểm tra HTTP status code của các chuyển hướng. |
Cao |
|
Canonical đến một URL bị noindex hoặc 404 |
Gửi tín hiệu mâu thuẫn cho Google, khiến chỉ thị canonical bị bỏ qua. |
Lỗi logic khi thiết lập quy tắc canonical tự động hoặc do lỗi con người. |
Đảm bảo URL trong thẻ canonical là một trang 200 OK, có thể được lập chỉ mục và là phiên bản bạn muốn xếp hạng. |
Cao |
|
Sử dụng thẻ canonical tương đối (relative path) |
Có thể bị diễn giải sai bởi crawler, dẫn đến việc canonical đến một URL không tồn tại. |
Dùng /page.html thay vì https://domain.com/page.html/. |
Luôn sử dụng URL tuyệt đối (bao gồm cả https:// và tên miền) trong thẻ link rel="canonical". |
Trung bình |
Checklist toàn diện kiểm tra và khắc phục duplicate content (cập nhật 2026)
Sử dụng bảng kiểm tra dưới đây để thực hiện một cuộc kiểm tra toàn diện và có hệ thống cho website của bạn.
|
Hạng mục |
Chi tiết thực hiện |
Mức độ ưu tiên |
|
Hợp nhất phiên bản Domain |
Kiểm tra và thiết lập chuyển hướng 301 vĩnh viễn từ các phiên bản (http, www, non-www) về một phiên bản duy nhất (thường là https://www). |
Rất cao |
|
Kiểm tra URL tham số |
Sử dụng công cụ crawl (Screaming Frog) để xác định các URL chứa tham số gây trùng lặp. Áp dụng thẻ canonical cho chúng. |
Cao |
|
Rà soát thẻ Canonical |
Kiểm tra toàn bộ website để đảm bảo mỗi trang có thể index đều có một thẻ canonical tự tham chiếu (self-referencing canonical). |
Cao |
|
Kiểm tra Google Search Console |
Xem lại báo cáo "Trang" để tìm các nhóm URL bị loại trừ do trùng lặp và xác minh Google đang chọn đúng URL chuẩn. |
Cao |
|
Kiểm tra nội dung bên ngoài |
Sử dụng Copyscape hoặc tìm kiếm Google để phát hiện các trang web khác đang sao chép nội dung của bạn mà không có sự cho phép hoặc ghi nhận. |
Trung bình |
|
Xử lý phân trang |
Đảm bảo các trang trong chuỗi phân trang có thẻ canonical tự tham chiếu và các liên kết rel="next/prev" được thiết lập (dù Google không còn dùng chính thức, nó vẫn tốt cho khả năng truy cập). |
Trung bình |
|
Kiểm tra nội dung Boilerplate |
Giảm thiểu các khối văn bản lớn lặp lại trên nhiều trang (ví dụ: footer, sidebar) nếu chúng chiếm tỷ lệ quá lớn so với nội dung chính. |
Thấp |
Tóm lại, duplicate content là một vấn đề kỹ thuật cần được quản lý một cách chủ động và chính xác. Bằng cách hiểu rõ nguyên nhân, tác hại và áp dụng đúng các giải pháp kỹ thuật, bạn không chỉ giải quyết được vấn đề hiện tại mà còn xây dựng một nền tảng vững chắc cho sự phát triển của website trong tương lai. Đây là một phần không thể thiếu trong chiến lược technical SEO toàn diện.
Bài viết liên quan
https://seovietnam.vn/content-mong-la-gi/