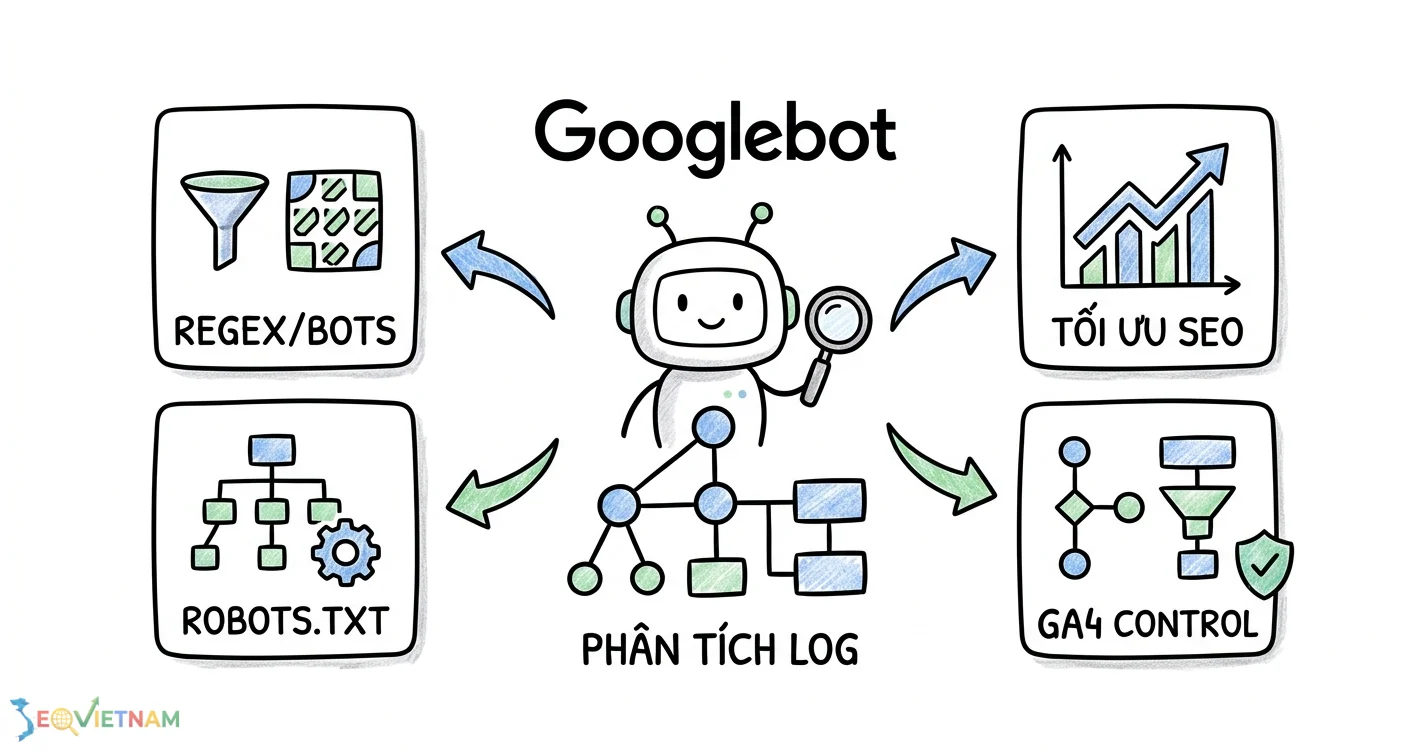
Hiểu sai hoặc bỏ qua hoạt động của các trình thu thập dữ liệu từ Google là một trong những rủi ro kỹ thuật lớn nhất có thể âm thầm phá hoại hiệu quả SEO. Việc phân tích log server không chỉ là để thỏa mãn sự tò mò, mà là một yêu cầu bắt buộc để chẩn đoán sức khỏe website, tối ưu crawl budget và đảm bảo nội dung quan trọng nhất được lập chỉ mục. Để làm chủ kỹ thuật này, bạn cần một danh sách trình thu thập dữ liệu google đầy đủ và các phương pháp kiểm soát đi kèm. Tại SEO Việt Nam, chúng tôi coi việc phân tích và điều hướng bot là một trong những nền tảng của Technical SEO hiện đại, giúp chuyển từ trạng thái bị động sang chủ động quản lý tài nguyên website.
Tổng quan về trình thu thập dữ liệu của google: Tại sao nó quan trọng với seo?
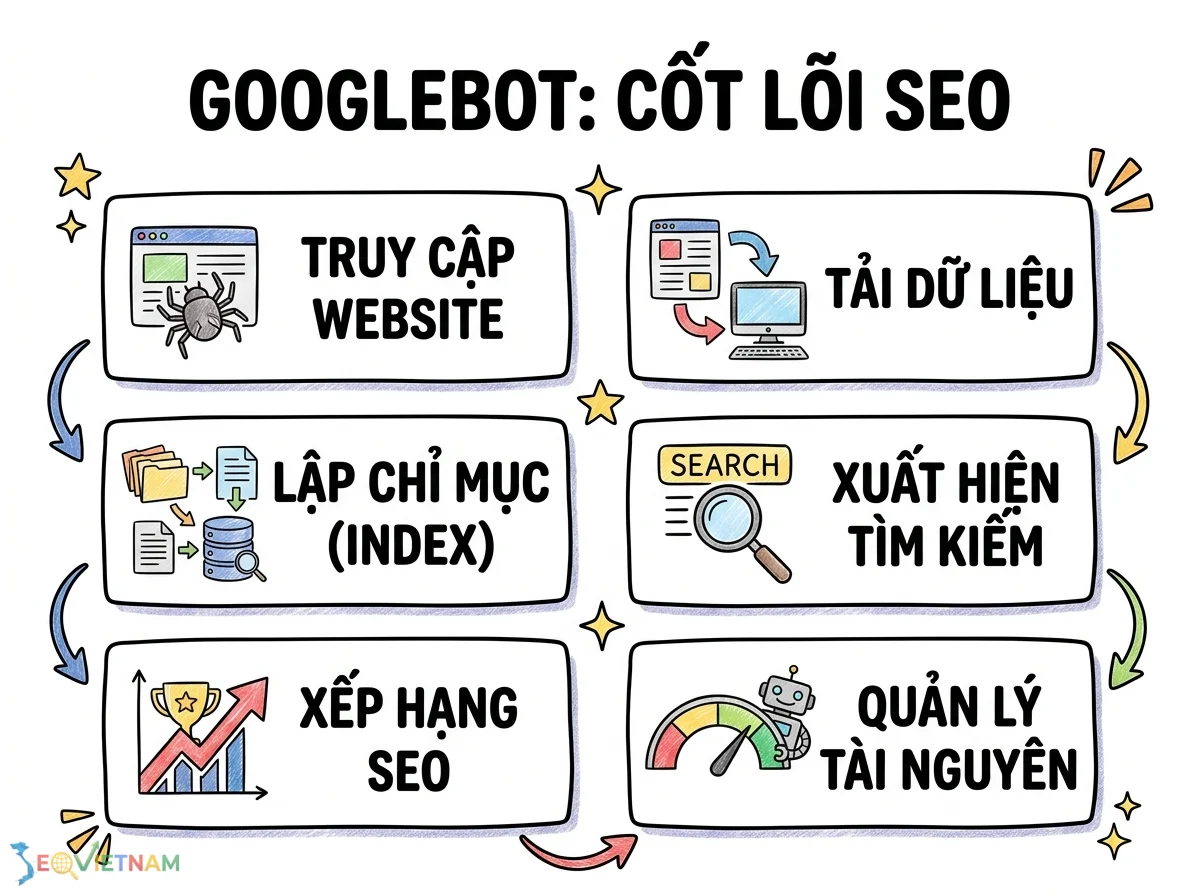
Trình thu thập dữ liệu của Google, thường được biết đến với tên gọi chung là Googlebot, là một chương trình tự động (bot, spider) có nhiệm vụ truy cập và tải xuống nội dung từ các trang web trên internet. Quá trình này là bước đầu tiên và cốt lõi để Google có thể hiểu, phân tích và cuối cùng là lập chỉ mục (index) nội dung của bạn, giúp nó xuất hiện trên trang kết quả tìm kiếm. Nếu không có hoạt động thu thập dữ liệu, website của bạn sẽ gần như vô hình với Google. Việc quản lý hiệu quả các bot này ảnh hưởng trực tiếp đến tốc độ index, khả năng xếp hạng và việc sử dụng tài nguyên máy chủ một cách hợp lý.
Danh sách chi tiết các trình thu thập dữ liệu của google (googlebot và others)
Google không chỉ sử dụng một loại bot duy nhất mà triển khai nhiều trình thu thập dữ liệu khác nhau, mỗi loại phục vụ một mục đích riêng biệt từ tìm kiếm web, hình ảnh, video đến quảng cáo. Hiểu rõ từng loại bot giúp bạn diễn giải chính xác hơn dữ liệu trong log server và đưa ra các quy tắc kiểm soát phù hợp trong file robots.txt. Mỗi bot được định danh bằng một chuỗi User Agent riêng biệt.
Bảng tổng hợp user-agent của từng loại bot và mục đích
Để tiện tham khảo, dưới đây là bảng tổng hợp các trình thu thập dữ liệu phổ biến nhất của Google, bao gồm User-Agent và chức năng chính của chúng, cập nhật theo bối cảnh 2026.
|
Tên trình thu thập |
User-Agent Token |
Mục đích chính |
Ghi chú quan trọng |
|
Googlebot |
Googlebot |
Thu thập dữ liệu cho kết quả tìm kiếm web. Đây là bot quan trọng nhất. |
Bao gồm cả phiên bản desktop và mobile. Mobile-first indexing có nghĩa là phiên bản Googlebot Smartphone là yếu tố chính để xếp hạng. |
|
Googlebot Image |
Googlebot-Image |
Thu thập dữ liệu cho Google Images. |
Tách biệt với Googlebot chính. Chặn bot này sẽ khiến hình ảnh không xuất hiện trên Google Images. |
|
Googlebot Video |
Googlebot-Video |
Thu thập dữ liệu cho Google Videos. |
Quan trọng cho các website có nhiều nội dung video, giúp video được index và hiển thị trên kết quả tìm kiếm video. |
|
Google-Extended |
Google-Extended |
Dữ liệu được sử dụng bởi các dịch vụ của Google như Google Bard và Vertex AI. |
Chặn bot này sẽ ngăn nội dung của bạn được sử dụng để huấn luyện các mô hình AI của Google trong tương lai. |
|
Google AdsBot |
AdsBot-Google |
Thu thập dữ liệu để kiểm tra chất lượng trang đích của quảng cáo Google Ads. |
Đảm bảo trang đích liên quan và hoạt động tốt. Chặn bot này có thể ảnh hưởng tiêu cực đến điểm chất lượng quảng cáo. |
|
Google StoreBot |
Storebot-Google |
Thu thập dữ liệu sản phẩm cho Google Shopping và các bề mặt thương mại khác. |
Cực kỳ quan trọng cho các trang e-commerce muốn sản phẩm xuất hiện trên Google Shopping. |
|
GoogleOther |
GoogleOther |
Được sử dụng bởi các nhóm sản phẩm nội bộ của Google để thu thập dữ liệu công khai. |
Một loại bot chung, thường có tần suất thu thập thấp hơn và ít ảnh hưởng trực tiếp đến SEO tìm kiếm chính. |
Cách xác định và phân tích hoạt động của googlebot trên website của bạn
Việc chỉ biết đến Danh sách Googlebot là chưa đủ; bạn cần phải biết cách chúng đang tương tác với website của mình. Có hai phương pháp chính để làm điều này: phân tích log server và sử dụng Google Search Console.
Phân tích log server: Phát hiện googlebot bằng regex (ví dụ apache, nginx)
Log server ghi lại mọi yêu cầu truy cập đến máy chủ của bạn, bao gồm cả từ người dùng thật và các loại bot. Phân tích file log là cách chính xác nhất để biết Googlebot đang truy cập trang nào, tần suất ra sao và gặp phải lỗi gì. Bạn có thể sử dụng biểu thức chính quy (Regex) để lọc ra các truy cập từ Googlebot.
Ví dụ Regex để lọc Googlebot từ log Nginx/Apache:
(googlebot|adsbot-google|googlebot-image|googlebot-video|storebot-google)
Bạn có thể sử dụng các công cụ như Screaming Frog SEO Log File Analyser, hoặc các lệnh command-line như grep trên Linux để áp dụng Regex này và trích xuất dữ liệu liên quan, từ đó phân tích các trang được crawl nhiều nhất, các mã trạng thái HTTP (200, 404, 503) mà bot nhận được.
Sử dụng google search console để theo dõi hiệu suất thu thập dữ liệu
Google Search Console (GSC) cung cấp báo cáo "Thống kê thu thập dữ liệu" (Crawl Stats) một cách trực quan và dễ hiểu hơn. Báo cáo này cho phép bạn xem:
Tổng số yêu cầu thu thập dữ liệu: Xem xu hướng hoạt động của Googlebot theo thời gian. Trạng thái thu thập dữ liệu: Phân loại các yêu cầu theo mã phản hồi HTTP (OK, Not found, Server error). Loại tệp được thu thập: Xem Googlebot tập trung vào HTML, CSS, JavaScript hay hình ảnh. Mục đích thu thập: Phân biệt giữa crawl làm mới (refresh) và crawl khám phá (discovery). Loại Googlebot: Xem tỷ lệ giữa Googlebot desktop và smartphone.
Báo cáo này là điểm khởi đầu tuyệt vời để phát hiện các vấn đề như website bị sập (tăng lỗi server) hoặc các trang không quan trọng đang bị crawl quá nhiều.
Kiểm soát hoạt động của googlebot: từ cơ bản đến nâng cao
Bạn có toàn quyền kiểm soát cách các trình thu thập dữ liệu tương tác với website của mình thông qua một số chỉ thị kỹ thuật.
Tối ưu robots.txt cho từng loại googlebot cụ thể
File robots.txt là công cụ mạnh mẽ nhất để chỉ dẫn các bot. Bạn có thể tạo các quy tắc riêng cho từng User-Agent cụ thể.
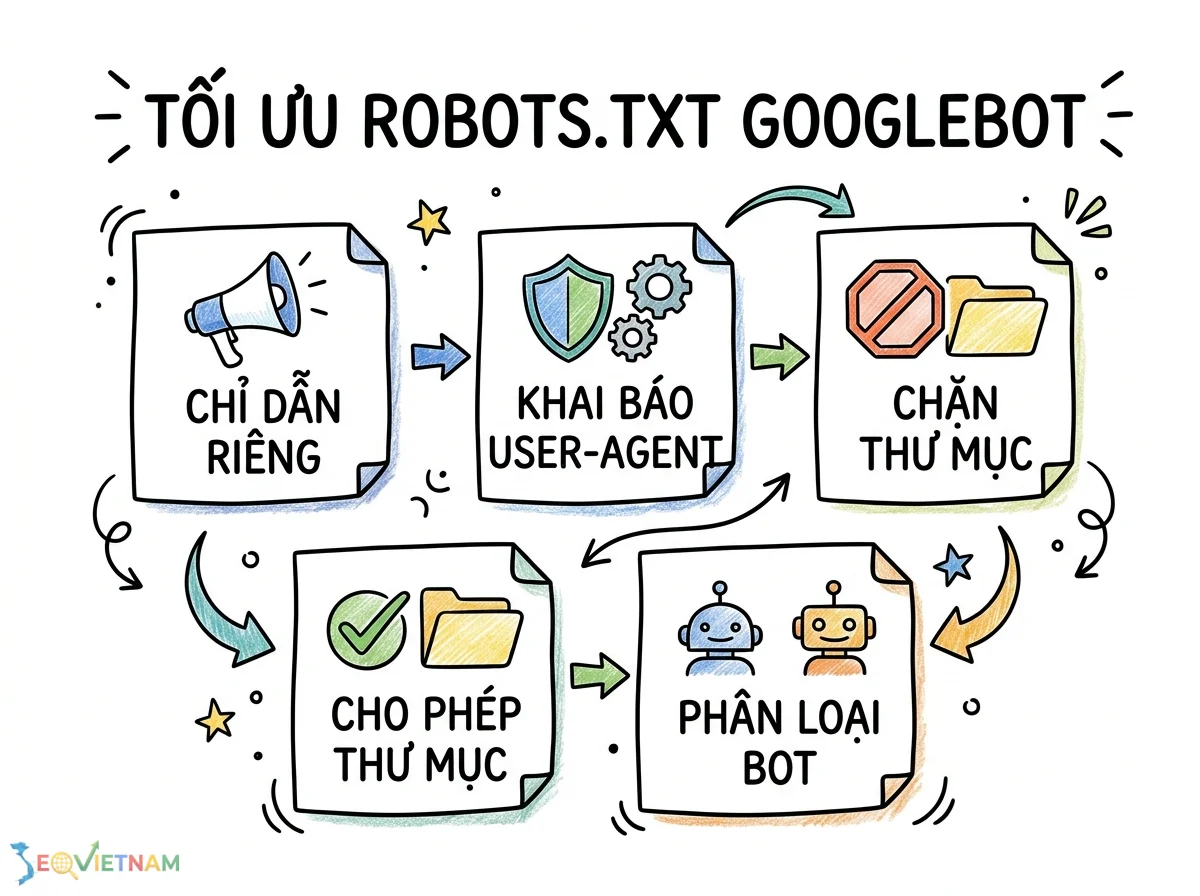
Ví dụ 1: Chặn Google AdsBot khỏi các thư mục staging:
User-agent: AdsBot-Google
Disallow: /staging/
Disallow: /dev/
User-agent: *
Disallow: /staging/
Disallow: /dev/
Ví dụ 2: Chỉ cho phép Googlebot-Image thu thập dữ liệu một thư mục hình ảnh cụ thể:
User-agent: Googlebot
Disallow: /private-images/
User-agent: Googlebot-Image
Allow: /private-images/product-shots/
Disallow: /private-images/
Sử dụng meta robots và http x-robots-tag
Trong khi robots.txt dùng để quản lý việc truy cập (crawl), meta robots và X-Robots-Tag dùng để quản lý việc lập chỉ mục (index) và các hành vi khác trên từng trang.
|
Tiêu chí |
robots.txt |
Meta Robots Tag |
X-Robots-Tag (HTTP Header) |
Gợi ý chọn |
|
Phạm vi |
Toàn bộ website, thư mục, hoặc file path. |
Chỉ áp dụng cho từng trang HTML cụ thể. |
Áp dụng cho bất kỳ loại file nào (PDF, hình ảnh, HTML…). |
Dùng X-Robots-Tag để kiểm soát file không phải HTML. Dùng meta robots cho trang HTML. |
|
Chức năng |
Kiểm soát việc thu thập dữ liệu (Crawling). |
Kiểm soát việc lập chỉ mục (Indexing) và các hành vi khác (nofollow, noarchive…). |
Tương tự Meta Robots nhưng ở cấp độ HTTP header. |
Dùng robots.txt để quản lý crawl budget, dùng meta/X-Robots-Tag để quản lý index. |
|
Mức độ ưu tiên |
Chỉ thị Disallow sẽ ngăn bot đọc các chỉ thị meta robots trên trang đó. |
Bị robots.txt ghi đè nếu trang bị Disallow. |
Bị robots.txt ghi đè nếu trang bị Disallow. |
Luôn đảm bảo trang bạn muốn noindex phải được phép crawl trong robots.txt. |
Tác động của googlebot đến dữ liệu ga4 và cách làm sạch
Lưu lượng truy cập từ bot có thể làm sai lệch dữ liệu phân tích của bạn trong Google Analytics 4 (GA4), gây khó khăn cho việc đánh giá hiệu quả chiến dịch.
Xác định và loại bỏ lưu lượng truy cập bot khỏi báo cáo ga4
GA4 có một tùy chọn tích hợp sẵn để tự động loại trừ các bot và spider đã biết.
Bước 1: Kích hoạt bộ lọc: Đi tới Admin > Data Settings > Data Filters. Bước 2: Bộ lọc Bot Traffic: GA4 có một bộ lọc mặc định tên là "Internal Traffic" nhưng bạn cần đảm bảo tùy chọn loại trừ bot được kích hoạt trong phần cài đặt Data Stream (Admin > Data Streams > [Chọn stream] > Configure tag settings > Show all > List unwanted referrals). Tùy chọn mặc định của GA4 "Exclude known bots and spiders" thường đã được bật. Bước 3: Tạo bộ lọc riêng (nếu cần): Nếu bạn phát hiện các bot tùy chỉnh hoặc bot giả mạo không nằm trong danh sách của Google, bạn có thể tạo bộ lọc loại trừ dựa trên các thông số như địa chỉ IP hoặc các thuộc tính khác.
Sử dụng bigquery để phân tích log server chuyên sâu và dữ liệu ga4
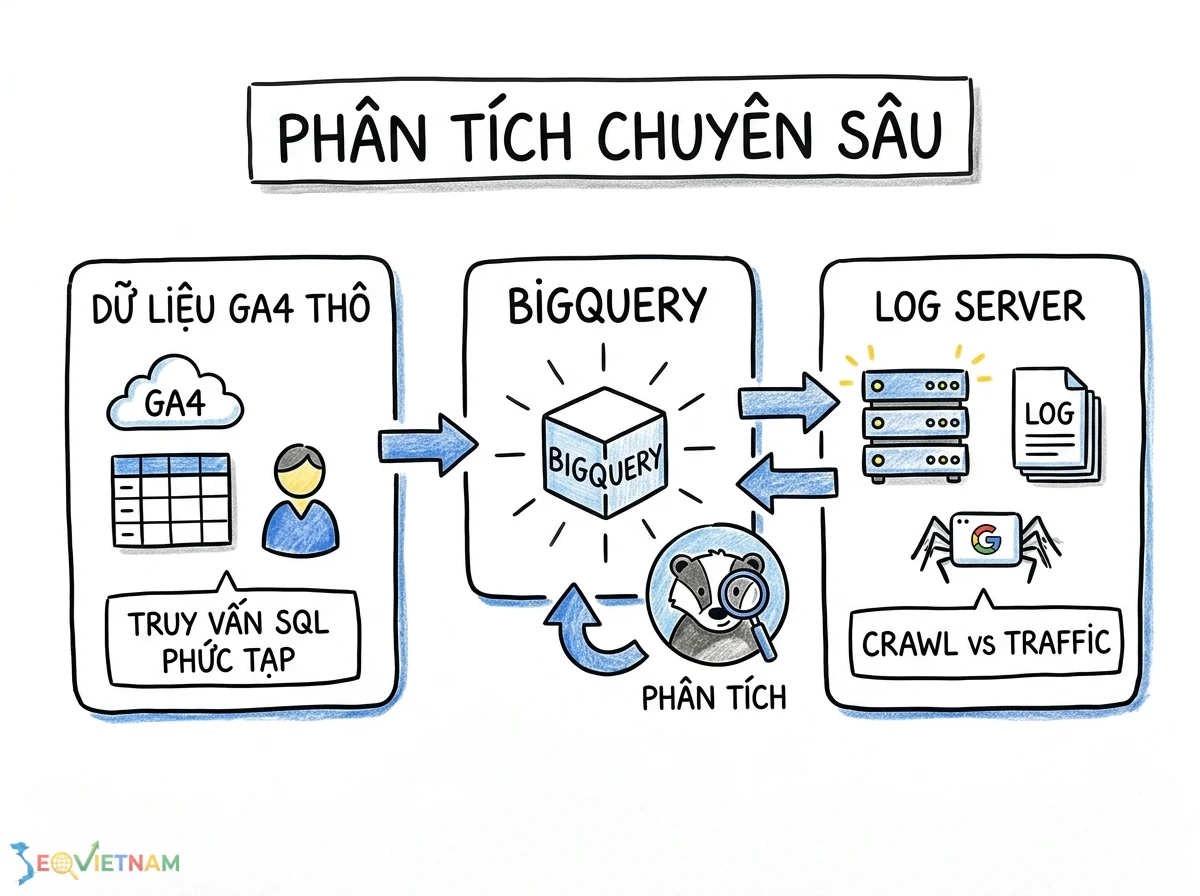
Bằng cách liên kết GA4 với BigQuery, bạn có thể truy cập dữ liệu thô và thực hiện các truy vấn SQL phức tạp. Bạn cũng có thể import log server của mình vào BigQuery để kết hợp hai nguồn dữ liệu. Điều này cho phép bạn đối chiếu hoạt động của Googlebot (từ log) với hành vi người dùng (từ GA4) trên cùng một nền tảng, mở ra khả năng phân tích sâu sắc về mối tương quan giữa crawl và traffic thực tế.
Khắc phục sự cố thường gặp với googlebot
Dưới đây là bảng xử lý các vấn đề phổ biến nhất liên quan đến hoạt động của Googlebot.
|
Lỗi |
Dấu hiệu |
Nguyên nhân |
Cách khắc phục |
Mức độ ưu tiên |
|
Googlebot không thu thập dữ liệu |
URL không được index, báo cáo "Discovered – currently not indexed" trong GSC. |
Bị chặn bởi robots.txt, thẻ noindex, lỗi server (5xx), chất lượng nội dung thấp, hoặc internal link yếu. |
Kiểm tra robots.txt bằng Tester của GSC. Dùng URL Inspection Tool để xem trang có được phép crawl/index không. Cải thiện internal linking. |
Cao |
|
Googlebot thu thập dữ liệu quá mức |
Tăng đột biến tải server, báo cáo Crawl Stats trong GSC tăng vọt. |
Website có quá nhiều URL (tham số, facet navigation), sitemap lớn, hoặc Google đang cố gắng crawl lại sau một thời gian website bị sập. |
Sử dụng robots.txt để chặn các URL tham số không cần thiết. Thiết lập crawl-delay (cẩn thận). Giảm tần suất crawl trong GSC (tùy chọn cũ, ít hiệu quả). |
Trung bình |
|
Bị bot giả mạo (Fake Googlebot) truy cập |
Hoạt động crawl đáng ngờ từ các dải IP không thuộc Google, gây tốn tài nguyên server. |
Kẻ xấu giả mạo User-Agent của Googlebot để scrape nội dung hoặc tìm lỗ hổng bảo mật. |
Chạy lệnh host hoặc nslookup trên địa chỉ IP của bot. IP chính hãng của Google sẽ phân giải ra tên miền .googlebot.com hoặc .google.com. Chặn các IP giả mạo ở cấp độ server (firewall, .htaccess). |
Cao |
|
Trang quan trọng ít được crawl |
Các trang sản phẩm/dịch vụ mới hoặc cập nhật không được Google ghé thăm thường xuyên. |
Cấu trúc website sâu, thiếu internal link trỏ đến, sitemap không được cập nhật. |
Làm phẳng cấu trúc website. Thêm internal link từ các trang có traffic cao (trang chủ, bài blog phổ biến) đến trang quan trọng. Gửi lại sitemap trong GSC. |
Cao |
Checklist quản lý trình thu thập dữ liệu của google hiệu quả
Để đảm bảo bạn luôn kiểm soát tốt hoạt động của bot, hãy thường xuyên thực hiện các hạng mục sau.
|
Hạng mục |
Chi tiết thực hiện |
Mức độ ưu tiên |
|
Kiểm tra robots.txt |
Rà soát file robots.txt hàng tháng, đảm bảo không vô tình chặn các tài nguyên quan trọng (CSS, JS) hoặc các trang cần index. |
Cao |
|
Phân tích Crawl Stats (GSC) |
Theo dõi báo cáo "Thống kê thu thập dữ liệu" trong GSC hàng tuần để phát hiện các xu hướng bất thường về số lượng crawl hoặc lỗi server. |
Cao |
|
Kiểm tra Index Coverage (GSC) |
Xem xét báo cáo "Phạm vi lập chỉ mục" để xác định các vấn đề khiến trang không được index sau khi đã được crawl. |
Cao |
|
Phân tích Log Server |
Thực hiện phân tích log server chuyên sâu hàng quý hoặc khi có sự cố để hiểu rõ hành vi của bot ở cấp độ chi tiết nhất. |
Trung bình |
|
Cập nhật Sitemap |
Đảm bảo file sitemap.xml luôn được cập nhật tự động khi có nội dung mới hoặc thay đổi, và đã được khai báo trong GSC. |
Cao |
|
Xác minh Googlebot |
Khi phát hiện hoạt động crawl đáng ngờ, hãy thực hiện xác minh IP để loại trừ bot giả mạo. |
Trung bình |
Kết luận
Việc hiểu và quản lý các trình thu thập dữ liệu của Google không còn là một lựa chọn, mà là một yêu cầu cốt lõi trong Technical SEO hiện đại. Thay vì để Googlebot tự do khám phá website một cách không định hướng, việc chủ động sử dụng robots.txt, meta tags, và phân tích log server cho phép bạn dẫn dắt bot đến những nội dung giá trị nhất, tối ưu hóa crawl budget và tăng tốc quá trình index. Hãy áp dụng các kỹ thuật phân tích và kiểm soát cập nhật 2026 này để đảm bảo nền tảng kỹ thuật của website luôn vững chắc, sẵn sàng cho việc chinh phục các thứ hạng cao trên Google.
Bài viết liên quan
https://seovietnam.vn/trinh-thu-thap-du-lieu-cua-google-la-gi/