Nhiều quản trị website và SEOer thường gặp phải tình trạng nội dung chất lượng cao nhưng không được Google lập chỉ mục (index) hoặc xếp hạng. Gốc rễ của vấn đề này thường bắt nguồn từ một giai đoạn cơ bản nhưng bị bỏ qua: quá trình thu thập dữ liệu (crawl). Việc không hiểu rõ và tối ưu hóa cho giai đoạn này giống như xây một ngôi nhà tuyệt đẹp nhưng lại không có đường cho khách vào. Tại SEO Việt Nam, chúng tôi nhận thấy rằng việc làm chủ cơ chế crawl là nền tảng cốt lõi để đảm bảo mọi nỗ lực SEO đều được Google ghi nhận. Hiểu rõ crawl là gì trong seo không chỉ là kiến thức lý thuyết mà là chìa khóa để chẩn đoán và khắc phục các vấn đề kỹ thuật sâu nhất, đảm bảo website của bạn luôn "mở cửa" chào đón các công cụ tìm kiếm.
Crawl là gì trong SEO? Định nghĩa và tầm quan trọng
Crawl (thu thập dữ liệu) là quá trình các bot của công cụ tìm kiếm (như Googlebot) tự động khám phá các trang web mới hoặc được cập nhật trên internet. Các bot này di chuyển từ trang này sang trang khác bằng cách đi theo các liên kết (hyperlinks), thu thập thông tin về nội dung của mỗi trang và gửi dữ liệu đó về máy chủ của Google để xử lý cho giai đoạn tiếp theo là lập chỉ mục (indexing). Tầm quan trọng của crawl nằm ở chỗ nó là bước đầu tiên và bắt buộc; nếu một trang không được crawl, nó không thể được index và do đó không thể xuất hiện trên kết quả tìm kiếm.
Cách thức Googlebot hoạt động: thu thập dữ liệu và khám phá
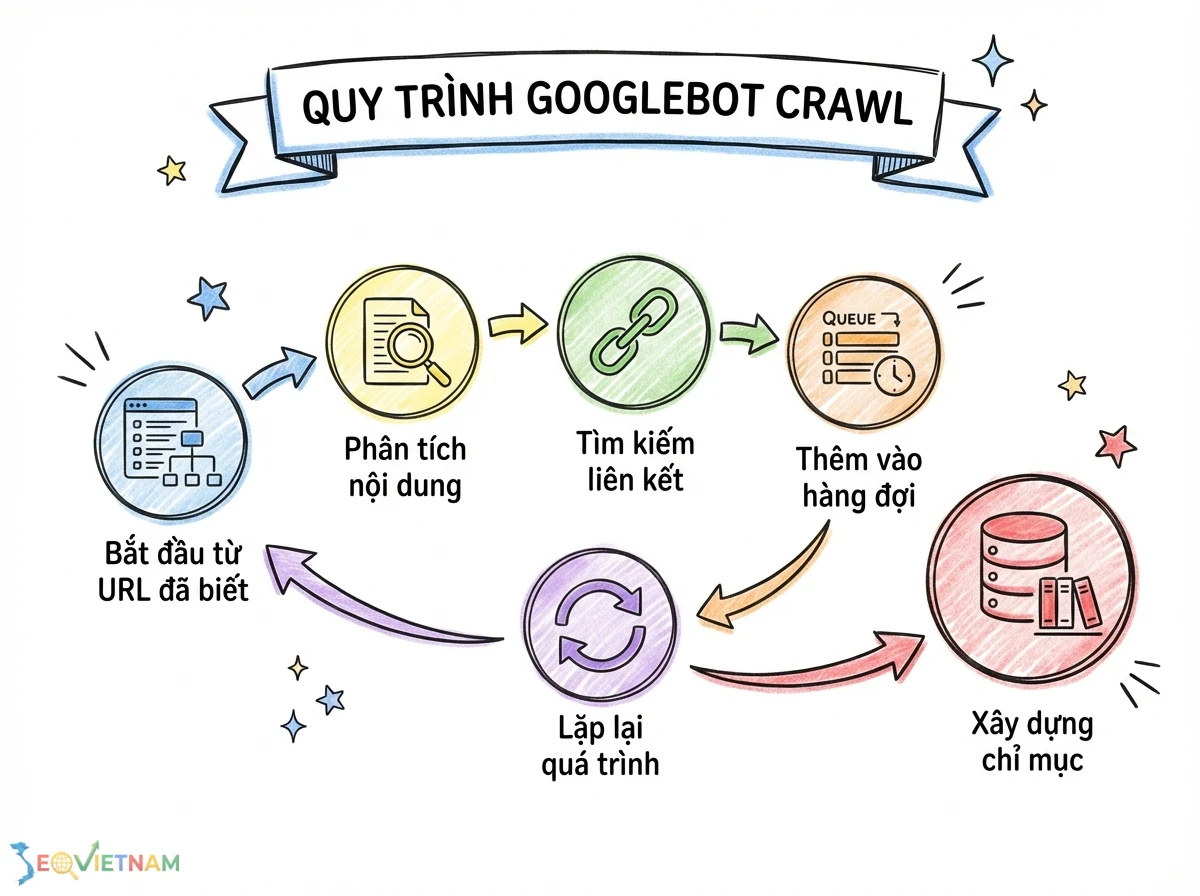
Googlebot hoạt động như một trình duyệt web tự động, bắt đầu hành trình từ một danh sách các URL đã biết (từ các lần crawl trước và sitemaps do quản trị viên web cung cấp). Khi truy cập một URL, nó sẽ phân tích nội dung và tìm kiếm tất cả các liên kết (thẻ <a> với thuộc tính href) trên trang đó. Các liên kết mới được phát hiện sẽ được thêm vào hàng đợi để Googlebot truy cập sau. Quá trình này lặp đi lặp lại, cho phép Google xây dựng một bản đồ khổng lồ về các trang web được kết nối với nhau trên toàn bộ internet, hay còn gọi là chỉ mục tìm kiếm. Để hiểu sâu hơn về bức tranh toàn cảnh, bạn cần nắm rõ Google hoạt động ra sao, từ crawl, index đến serving.
Phân biệt Crawl, Index và Rank
Việc phân biệt rõ ràng ba khái niệm này là cực kỳ quan trọng để chẩn đoán chính xác các vấn đề SEO. Chúng đại diện cho ba giai đoạn tuần tự và riêng biệt trong quá trình xử lý của Google.
|
Tiêu chí |
Crawl (Thu thập dữ liệu) |
Index (Lập chỉ mục) |
Rank (Xếp hạng) |
Gợi ý chọn |
|
Hành động |
Googlebot khám phá và tải xuống nội dung của một URL. |
Google phân tích, hiểu và lưu trữ nội dung đã crawl vào cơ sở dữ liệu khổng lồ của mình. |
Google sắp xếp các trang đã index theo thứ tự liên quan nhất cho một truy vấn tìm kiếm cụ thể. |
Tập trung vào Crawl nếu GSC báo lỗi thu thập hoặc trang mới không được Google biết đến. |
|
Mục tiêu |
Phát hiện sự tồn tại và nội dung của các trang web. |
Xây dựng một thư viện web (chỉ mục) có thể truy vấn được. |
Cung cấp câu trả lời tốt nhất và phù-hợp nhất cho người dùng. |
Tập trung vào Index nếu trang được crawl nhưng không xuất hiện với toán tử site:. |
|
Công cụ kiểm tra |
Báo cáo Thống kê thu thập dữ liệu (Crawl Stats) trong Google Search Console, Log file server. |
Báo cáo Phạm vi lập chỉ mục (Coverage) trong GSC, toán tử site:yourdomain.com. |
Báo cáo Hiệu suất (Performance) trong GSC, kiểm tra SERP thủ công. |
Tập trung vào Rank nếu trang đã index nhưng vị trí thấp hoặc không có traffic. |
|
Vấn đề thường gặp |
Bị chặn bởi robots.txt, lỗi máy chủ (5xx), liên kết hỏng (404), crawl budget thấp. |
Thẻ noindex, canonicalization không chính xác, nội dung chất lượng thấp, trùng lặp. |
Nội dung không đáp ứng ý định tìm kiếm, tín hiệu E-E-A-T yếu, hồ sơ backlink kém. |
Phân tích từng giai đoạn để tìm ra nút thắt cổ chai trong quy trình SEO của bạn. |
Cơ chế Crawl của Google: Từ Discovery đến Render
Cơ chế crawl của Google đã phát triển vượt xa việc chỉ đơn giản là tải xuống mã HTML. Ngày nay, nó bao gồm một quy trình hai pha phức tạp để xử lý các trang web hiện đại sử dụng nhiều JavaScript, đảm bảo Google có thể "nhìn thấy" trang web giống như người dùng.
Luồng hoạt động chi tiết của Googlebot
Quy trình crawl không phải là một hành động đơn lẻ mà là một chuỗi các bước được điều phối bởi hệ thống Caffeine của Google.
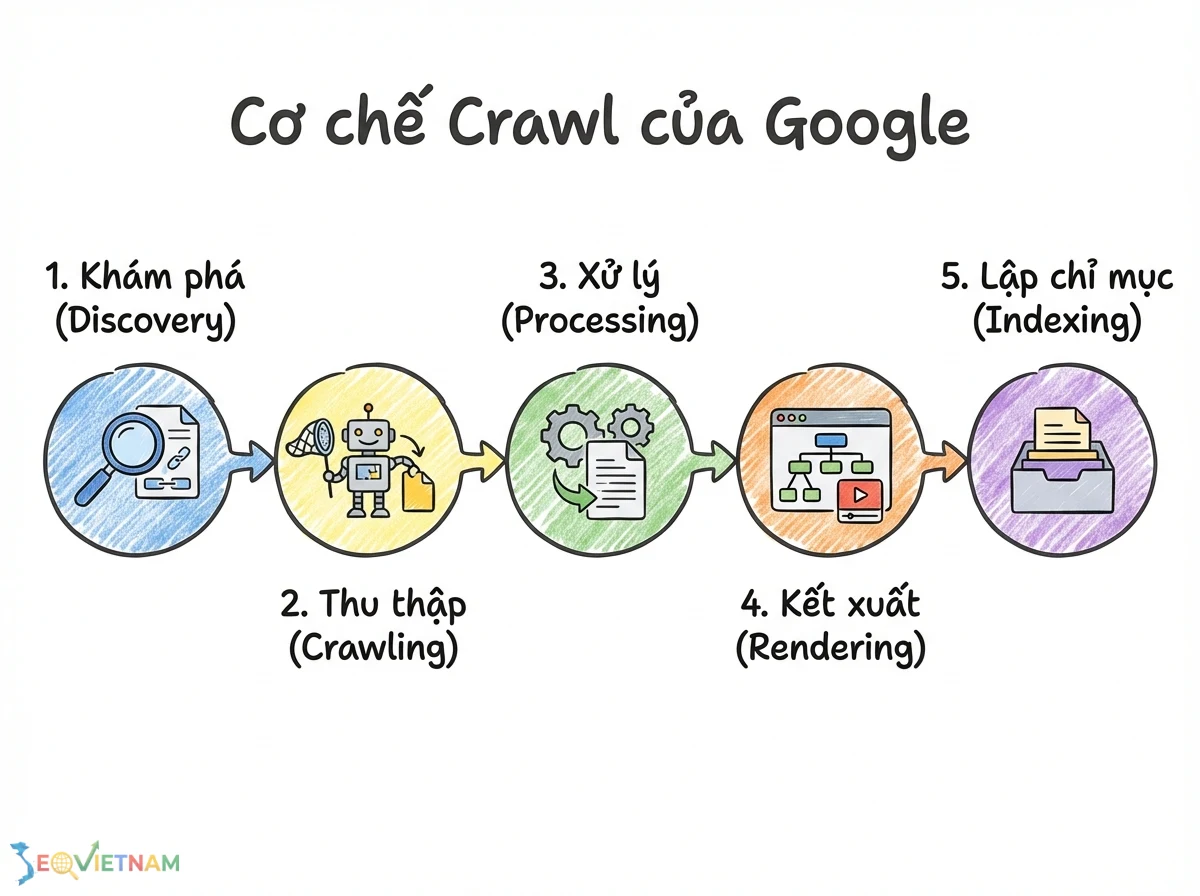
Bước 1: Discovery (Khám phá): Googlebot tìm thấy các URL mới thông qua sitemaps, các liên kết từ các trang đã biết, hoặc các nguồn khác. Các URL này được thêm vào một hàng đợi ưu tiên gọi là "crawling queue".
Bước 2: Crawling (Thu thập dữ liệu): Googlebot gửi yêu cầu HTTP GET đến máy chủ của bạn để tải xuống mã nguồn ban đầu (HTML, CSS, JS). Việc này chịu ảnh hưởng lớn bởi các chỉ thị trong file robots.txt.
Bước 3: Processing (Xử lý ban đầu): Google xử lý HTML ban đầu để tìm thêm các liên kết và tài nguyên cần thiết (như file CSS, JavaScript). Các tài nguyên này cũng được thêm vào hàng đợi crawl.
Bước 4: Rendering (Kết xuất): Đối với các trang web phụ thuộc vào JavaScript, Google sử dụng Dịch vụ kết xuất web (Web Rendering Service – WRS) để thực thi JS và xây dựng mô hình đối tượng tài liệu (DOM) hoàn chỉnh. Đây là bước quan trọng để Google thấy được nội dung được tạo ra bởi JavaScript.
Bước 5: Indexing (Lập chỉ mục): Nội dung từ DOM đã kết xuất được gửi đến bộ phận lập chỉ mục (Indexer) để phân tích, hiểu và lưu trữ, sẵn sàng cho việc xếp hạng.
Các loại Googlebot và chức năng của chúng
Google sử dụng nhiều loại bot khác nhau, mỗi loại có một user-agent và mục đích riêng biệt. Hiểu rõ các loại Googlebot giúp bạn phân tích log file chính xác hơn.
Googlebot Smartphone: Đây là bot chính, mô phỏng một người dùng truy cập từ thiết bị di động. Nó là yếu tố cốt lõi của mobile-first indexing. User-agent thường chứa chuỗi "Googlebot" và "Mobile".
Googlebot Desktop: Bot này thu thập dữ liệu trang web dưới dạng người dùng máy tính để bàn. Mặc dù ít quan trọng hơn trong kỷ nguyên mobile-first, nó vẫn hoạt động để thu thập thông tin so sánh.
Googlebot Image: Chuyên thu thập dữ liệu hình ảnh để đưa vào Google Images.
Googlebot Video: Chuyên thu thập dữ liệu các tệp video trên trang của bạn.
Google-Extended: Một user-agent mới được giới thiệu để kiểm soát việc dữ liệu có được sử dụng cho các mô hình AI của Google như Bard và Vertex AI hay không.
Crawl Budget là gì? Tối ưu ngân sách thu thập dữ liệu
Crawl Budget (Ngân sách thu thập dữ liệu) là số lượng URL mà Googlebot có thể và muốn thu thập trên một trang web trong một khoảng thời gian nhất định. Đây không phải là một con số cố định mà là một khái niệm linh hoạt, phụ thuộc vào hai yếu tố chính: khả năng thu thập của máy chủ (crawl capacity limit) và nhu cầu thu thập dữ liệu (crawl demand). Tối ưu hóa crawl budget là cực kỳ quan trọng đối với các trang web lớn (hơn 100.000 trang) hoặc các trang có nội dung thay đổi thường xuyên.
Cách Google xác định Crawl Budget cho website
Google xác định crawl budget dựa trên một tập hợp các tín hiệu phức tạp để đảm bảo quá trình thu thập dữ liệu không làm quá tải máy chủ của bạn và tập trung vào các trang quan trọng nhất.
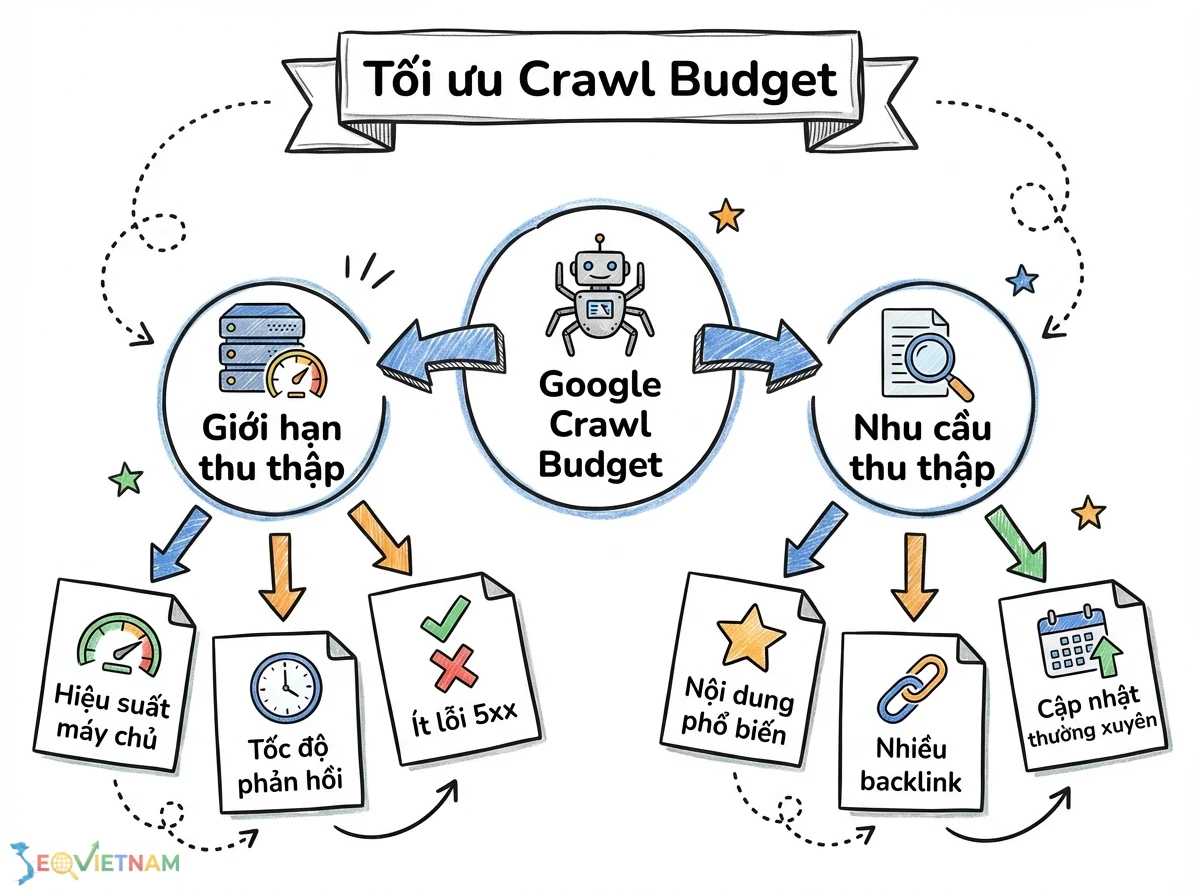
Crawl Capacity Limit (Giới hạn khả năng thu thập): Googlebot tự động điều chỉnh tốc độ thu thập để không gây ảnh hưởng tiêu cực đến hiệu suất máy chủ. Nếu máy chủ phản hồi chậm hoặc trả về nhiều lỗi 5xx, Google sẽ giảm tốc độ crawl. Ngược lại, nếu máy chủ nhanh và ổn định, Google sẽ tăng tốc độ.
Crawl Demand (Nhu cầu thu thập): Điều này được quyết định bởi mức độ phổ biến và độ mới của nội dung. Các URL phổ biến hơn trên internet (có nhiều backlink chất lượng) và các URL được cập nhật thường xuyên sẽ có nhuá cầu thu thập cao hơn. Google không muốn lãng phí tài nguyên để crawl các trang lỗi thời hoặc ít giá trị.
Kỹ thuật tối ưu Crawl Budget hiệu quả
Tối ưu Ngân sách thu thập là việc hướng dẫn Googlebot tập trung vào các URL quan trọng nhất và tránh lãng phí tài nguyên vào các trang không cần thiết. Dưới đây là checklist các hạng mục cần triển khai.
|
Hạng mục |
Chi tiết thực hiện |
Mức độ ưu tiên |
|
Cải thiện tốc độ tải trang |
Tối ưu Core Web Vitals, giảm thời gian phản hồi của máy chủ (TTFB), sử dụng CDN. Máy chủ nhanh hơn cho phép Googlebot crawl nhiều trang hơn trong cùng một khoảng thời gian. |
Rất cao |
|
Quản lý file robots.txt |
Sử dụng chỉ thị Disallow để chặn Googlebot truy cập vào các khu vực không quan trọng (admin, giỏ hàng, URL có tham số lọc, sắp xếp…). |
Rất cao |
|
Sử dụng Sitemap.xml |
Cung cấp một sitemap XML rõ ràng, sạch sẽ, chỉ chứa các URL quan trọng (trạng thái 200) và cập nhật thường xuyên. Đảm bảo sitemap được khai báo trong GSC. |
Cao |
|
Xử lý URL trùng lặp |
Sử dụng thẻ rel="canonical" để hợp nhất tín hiệu cho các trang trùng lặp, tránh việc Googlebot crawl nhiều phiên bản của cùng một nội dung. |
Cao |
|
Giảm chuỗi chuyển hướng |
Hạn chế tối đa các chuỗi chuyển hướng (A -> B -> C). Mỗi lần chuyển hướng đều tiêu tốn một phần crawl budget. Cập nhật các liên kết nội bộ để trỏ trực tiếp đến URL cuối cùng. |
Trung bình |
|
Xử lý lỗi 4xx và 5xx |
Thường xuyên kiểm tra báo cáo Coverage trong GSC để tìm và sửa các lỗi 404 (Not Found) và lỗi máy chủ 5xx. Quá nhiều lỗi này làm giảm crawl budget. |
Cao |
|
Tối ưu cấu trúc liên kết nội bộ |
Xây dựng cấu trúc internal link logic, đảm bảo các trang quan trọng nhất có nhiều liên kết nội bộ trỏ đến và nằm gần trang chủ nhất có thể (ít click hơn). |
Cao |
Công cụ kiểm soát và theo dõi hoạt động Crawl
Việc kiểm soát và theo dõi cách Googlebot tương tác với website của bạn là yếu tố then chốt trong technical SEO. Google cung cấp các công cụ mạnh mẽ, và các kỹ thuật nâng cao như phân tích log file cho phép bạn có cái nhìn sâu sắc nhất.
Google Search Console
Google Search Console (GSC) là công cụ không thể thiếu.
Báo cáo Thống kê thu thập dữ liệu (Crawl Stats): Cung cấp dữ liệu chi tiết về hoạt động của Googlebot trên trang web của bạn trong 90 ngày qua, bao gồm tổng số yêu cầu thu thập, tổng kích thước tải xuống và thời gian phản hồi trung bình. Đây là nơi để kiểm tra "sức khỏe" của máy chủ trong mắt Google.
Báo cáo Phạm vi lập chỉ mục (Coverage): Cho bạn biết trạng thái của tất cả các URL mà Google đã biết đến trên trang của bạn, bao gồm các URL hợp lệ, URL bị lỗi, URL bị loại trừ (ví dụ: bị chặn bởi robots.txt, noindex).
Công cụ kiểm tra URL (URL Inspection Tool): Cho phép bạn xem trạng thái crawl và index của một URL cụ thể, bao gồm lần crawl cuối cùng, Googlebot đã thấy gì, và liệu trang có thể được lập chỉ mục hay không.
Tệp Robots.txt và các chỉ thị nâng cao
File robots.txt là công cụ đầu tiên để giao tiếp với các bot. Ngoài các chỉ thị Disallow và Allow cơ bản, bạn có thể sử dụng các ký tự đại diện và biểu thức chính quy (Regex) để kiểm soát linh hoạt hơn.
Ví dụ về robots.txt nâng cao:
User-agent: Googlebot
# Chặn tất cả các URL có tham số 'filter='
Disallow: /*filter=
# Cho phép crawl các URL có tham số 'sort=price'
Allow: /*sort=price
User-agent: *
# Chặn tất cả các bot khác truy cập vào thư mục /private/
Disallow: /private/
So sánh các chỉ thị kiểm soát Crawl và Index
Việc lựa chọn phương pháp phù hợp để kiểm soát bot là rất quan trọng vì chúng có các tác động khác nhau.
|
Tiêu chí |
Disallow trong robots.txt |
Thẻ meta name="robots" content="noindex" |
HTTP Header X-Robots-Tag: noindex |
Gợi ý chọn |
|
Mục đích |
Ngăn chặn việc crawl (thu thập dữ liệu). |
Cho phép crawl nhưng ngăn chặn việc index (lập chỉ mục). |
Tương tự meta noindex nhưng áp dụng cho các tệp không phải HTML. |
Sử dụng Disallow để tiết kiệm crawl budget, noindex để xóa URL khỏi kết quả tìm kiếm. |
|
Phạm vi áp dụng |
Các file, thư mục, hoặc toàn bộ website. |
Chỉ áp dụng cho từng trang HTML cụ thể. |
Áp dụng cho bất kỳ loại tệp nào (PDF, DOCX, hình ảnh…). |
X-Robots-Tag là lựa chọn duy nhất để noindex các tệp không phải HTML. |
|
Hành vi của Google |
Google sẽ không truy cập URL, nhưng nếu URL có backlink, nó vẫn có thể được index (không có tiêu đề/mô tả). |
Google sẽ crawl URL, thấy chỉ thị noindex và sẽ xóa nó khỏi chỉ mục. |
Google sẽ crawl tệp, thấy header noindex và sẽ xóa nó khỏi chỉ mục. |
Luôn ưu tiên noindex nếu mục tiêu là loại bỏ URL khỏi SERP. |
Các vấn đề Crawl phổ biến và cách khắc phục
Chẩn đoán và khắc phục lỗi crawl là một kỹ năng quan trọng. Dưới đây là ma trận xử lý một số vấn đề thường gặp nhất.
|
Lỗi |
Dấu hiệu |
Nguyên nhân |
Cách khắc phục |
Mức độ ưu tiên |
|
Blocked by robots.txt |
Trong GSC, URL được báo cáo là "Bị chặn bởi robots.txt" nhưng vẫn có thể được index. |
File robots.txt đang chứa chỉ thị Disallow cho URL này. URL được index do có nhiều liên kết ngoài trỏ đến. |
Nếu URL quan trọng, hãy xóa hoặc sửa đổi quy tắc Disallow trong robots.txt. Gửi lại sitemap và yêu cầu lập chỉ mục lại. |
Rất cao |
|
Crawl anomaly |
Báo cáo Crawl Stats trong GSC hiển thị các đỉnh bất thường về lỗi hoặc thời gian phản hồi. |
Lỗi cấu hình máy chủ, máy chủ bị quá tải, vấn đề về DNS, hoặc sự cố mạng. |
Kiểm tra log file server để xác định nguyên nhân. Liên hệ với nhà cung cấp hosting để kiểm tra tình trạng máy chủ. Sử dụng các công cụ giám sát uptime. |
Rất cao |
|
Server error (5xx) |
GSC báo cáo số lượng lớn lỗi 5xx. Googlebot không thể truy cập trang web. |
Máy chủ web bị sập, quá tải, hoặc có lỗi trong mã nguồn backend (PHP, Node.js). |
Khởi động lại máy chủ. Tối ưu hóa mã nguồn và truy vấn cơ sở dữ liệu. Nâng cấp gói hosting nếu cần thiết. |
Rất cao |
|
Ảnh hưởng của JavaScript Rendering |
Nội dung chính của trang không hiển thị khi xem mã nguồn (View Source) nhưng hiển thị khi kiểm tra phần tử (Inspect). GSC báo "Trang trống" hoặc không index nội dung. |
Nội dung được tạo ra bởi JavaScript phía máy khách (client-side rendering) và Googlebot gặp khó khăn khi kết xuất. |
Triển khai Dynamic Rendering hoặc Server-Side Rendering (SSR). Đảm bảo các file JS/CSS không bị chặn bởi robots.txt. Tối ưu hóa hiệu suất JS. |
Cao |
|
Liên kết hỏng (404) và chuyển hướng (301/302) |
GSC báo cáo nhiều lỗi 404. Phân tích crawl cho thấy nhiều chuỗi chuyển hướng. |
Trang đã bị xóa, URL thay đổi không có chuyển hướng, hoặc liên kết nội bộ bị sai. Sử dụng chuyển hướng tạm thời (302) thay vì vĩnh viễn (301). |
Sửa các liên kết nội bộ bị hỏng. Thiết lập chuyển hướng 301 từ các URL cũ sang URL mới có liên quan. Kiểm tra và thay thế các chuyển hướng 302 bằng 301 nếu sự thay đổi là vĩnh viễn. |
Cao |
Kết luận
Việc hiểu và làm chủ quá trình crawl không còn là một lựa chọn mà là yêu cầu bắt buộc đối với bất kỳ chiến dịch SEO chuyên nghiệp nào. Từ việc cấu hình robots.txt chính xác, tối ưu hóa crawl budget cho các website quy mô lớn, đến việc chẩn đoán các lỗi máy chủ và vấn đề rendering JavaScript, tất cả đều quy về một mục tiêu: đảm bảo Googlebot có thể truy cập, hiểu và đánh giá nội dung của bạn một cách hiệu quả nhất. Bằng cách áp dụng các kỹ thuật và công cụ được trình bày trong bài viết này, bạn có thể chủ động loại bỏ các rào cản kỹ thuật, mở đường cho nội dung của mình được lập chỉ mục và đạt được thứ hạng xứng đáng trên công cụ tìm kiếm.
Bài viết liên quan
https://seovietnam.vn/tong-quan-crawling-va-indexing/
https://seovietnam.vn/loi-thu-thap-thong-tin-la-gi/
https://seovietnam.vn/giam-sat-toc-do-thu-thap-thong-tin-google/