Việc website không xuất hiện trên Google cũng giống như một cửa hàng không có trên bản đồ — dù sản phẩm tốt đến đâu, khách hàng cũng không thể tìm thấy. Nền tảng của sự hiện diện này nằm ở hai quy trình kỹ thuật cốt lõi mà mọi chuyên gia SEO phải nắm vững. Hiểu rõ về tổng quan crawling và indexing không chỉ là kiến thức cơ bản, mà là chìa khóa để chẩn đoán và khắc phục các vấn đề ngăn cản website của bạn tiếp cận người dùng. Tại SEO Việt Nam, chúng tôi nhấn mạnh rằng việc làm chủ hai khái niệm này là bước đầu tiên để xây dựng một chiến lược SEO bền vững và hiệu quả. Toàn bộ Quy trình tìm kiếm của Google đều bắt đầu từ đây.
Mục tiêu của bài viết này là cung cấp một hướng dẫn kỹ thuật chuyên sâu, không chỉ định nghĩa mà còn đi sâu vào cách tối ưu, chẩn đoán lỗi bằng các ví dụ thực tế và công cụ chuyên dụng. Chúng tôi sẽ phân tích chi tiết từng giai đoạn, từ cách Googlebot khám phá nội dung đến khi trang của bạn được lưu trữ và sẵn sàng để xếp hạng.
Crawling là gì? Toàn bộ quá trình Googlebot thu thập dữ liệu website
Crawling (thu thập dữ liệu) là quá trình các công cụ tìm kiếm, cụ thể là các chương trình tự động gọi là bot hoặc spider (như Googlebot), khám phá các trang web mới và được cập nhật trên internet. Quá trình này hoạt động không ngừng nghỉ, đi theo các liên kết từ các trang đã biết để tìm các URL mới, giống như việc bạn lướt web bằng cách nhấp vào các đường link. Để hiểu rõ hơn về cơ chế này, bạn có thể tham khảo bài viết chi tiết về Crawling là gì.
Googlebot hoạt động như thế nào?
Googlebot không phải là một chương trình đơn lẻ. Nó là một tập hợp các bot khác nhau được thiết kế cho các mục đích cụ thể, giúp Google xử lý hiệu quả kho dữ liệu khổng lồ của web.
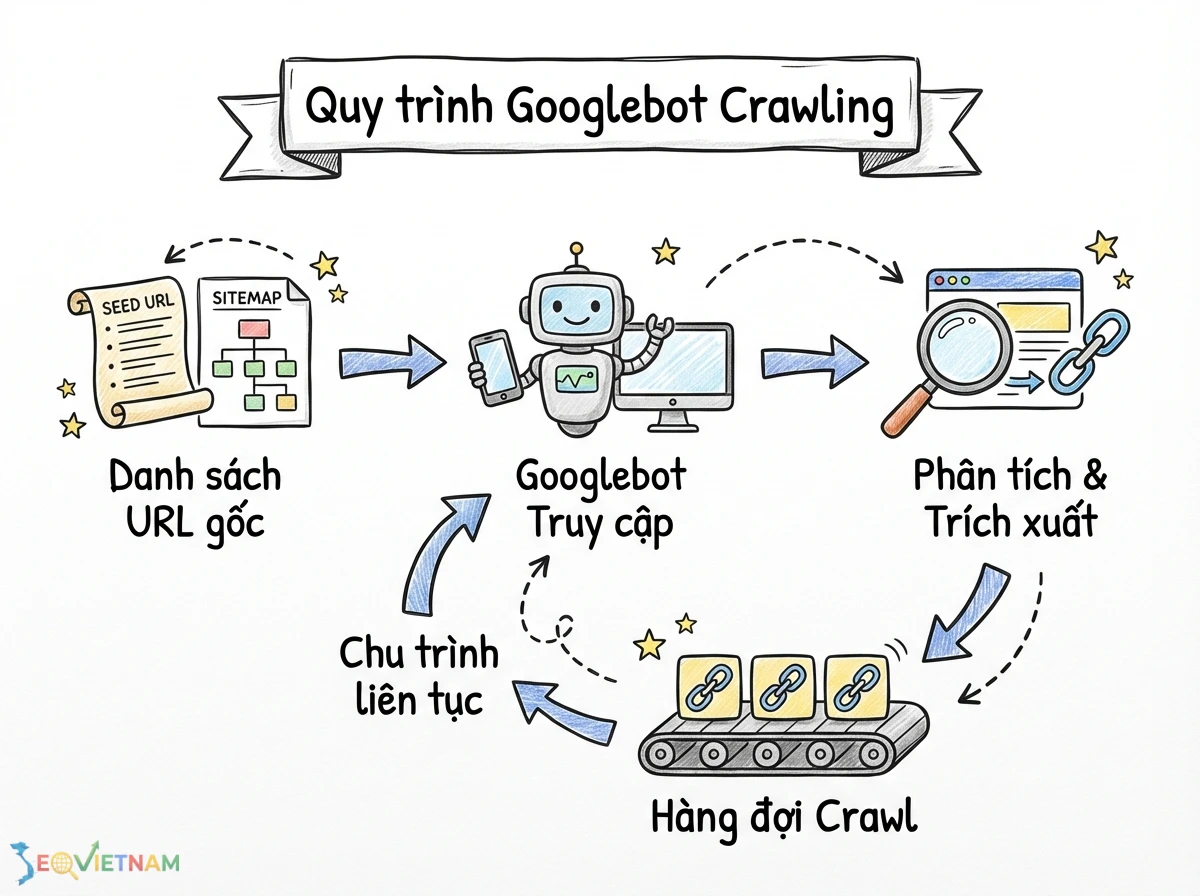
Các loại Googlebot chính: Google sử dụng các user-agent khác nhau, phổ biến nhất là Googlebot Desktop và Googlebot Smartphone. Với chính sách Mobile-First Indexing, Googlebot Smartphone đóng vai trò chủ đạo trong việc thu thập và đánh giá hầu hết các website. Ngoài ra còn có các bot chuyên biệt khác như Googlebot Image, Googlebot Video, và Googlebot News.
Cơ chế hoạt động: Quá trình bắt đầu từ một danh sách các URL đã biết (seed list) được tạo ra từ các lần crawl trước và các sitemap do chủ sở hữu trang web cung cấp. Khi Googlebot truy cập một URL, nó sẽ phân tích nội dung và trích xuất tất cả các liên kết (href) có trên trang đó. Những liên kết này sau đó được thêm vào hàng đợi để được thu thập trong tương lai, tạo thành một chu trình khám phá liên tục.
Các yếu tố ảnh hưởng đến crawling
Khả năng Googlebot thu thập dữ liệu website của bạn hiệu quả phụ thuộc vào nhiều yếu tố kỹ thuật. Việc tối ưu các yếu tố này là nền tảng để đảm bảo nội dung của bạn có cơ hội được index.
Robots.txt: Đây là tệp tin văn bản đơn giản đặt ở thư mục gốc của website, hoạt động như một bộ quy tắc chỉ dẫn cho các bot. Nó cho phép bạn chặn hoặc cho phép các bot truy cập vào các phần cụ thể của trang web. Một cấu hình sai trong file này có thể vô tình chặn Googlebot hoàn toàn.
Sitemap.xml: Sơ đồ trang web XML là một tệp liệt kê tất cả các URL quan trọng trên website mà bạn muốn công cụ tìm kiếm thu thập. Nó giúp Googlebot khám phá các trang mới hoặc các trang nằm sâu trong cấu trúc website một cách nhanh chóng và hiệu quả hơn.
Internal Linking: Cấu trúc liên kết nội bộ mạnh mẽ giúp Googlebot di chuyển dễ dàng giữa các trang, hiểu được mối quan hệ ngữ nghĩa giữa chúng và phân phối PageRank hiệu quả. Các trang quan trọng nên nhận được nhiều liên kết nội bộ từ các trang có liên quan khác.
Tốc độ tải trang: Một trang web tải chậm không chỉ ảnh hưởng đến trải nghiệm người dùng mà còn làm tiêu tốn tài nguyên của Googlebot. Nếu máy chủ phản hồi chậm, Googlebot có thể giảm tần suất thu thập dữ liệu để tránh làm quá tải máy chủ của bạn.
Crawl Budget (Ngân sách thu thập dữ liệu): Đây là số lượng URL mà Googlebot có thể và muốn thu thập trên website của bạn trong một khoảng thời gian nhất định. Các website lớn với hàng triệu URL cần quản lý crawl budget một cách cẩn thận để đảm bảo các trang quan trọng nhất được thu thập thường xuyên.
Indexing là gì? Cách Google lập chỉ mục và hiển thị nội dung của bạn
Indexing (lập chỉ mục) là quá trình Google phân tích, hiểu và lưu trữ thông tin từ các trang đã được crawl vào một cơ sở dữ liệu khổng lồ gọi là chỉ mục tìm kiếm (Search Index). Chỉ khi một trang được đưa vào chỉ mục này, nó mới có cơ hội xuất hiện trong kết quả tìm kiếm của Google cho các truy vấn có liên quan. Đây là bước quan trọng sau khi crawling, quyết định liệu nội dung của bạn có "tồn tại" trong thế giới của Google hay không. Một phân tích chi tiết hơn về Indexing là gì sẽ giúp bạn nắm vững các yếu tố kỹ thuật liên quan.
Quy trình lập chỉ mục của google
Sau khi thu thập dữ liệu, Google sẽ tiến hành xử lý nội dung để chuẩn bị cho việc lập chỉ mục. Quy trình này bao gồm nhiều bước phức tạp.
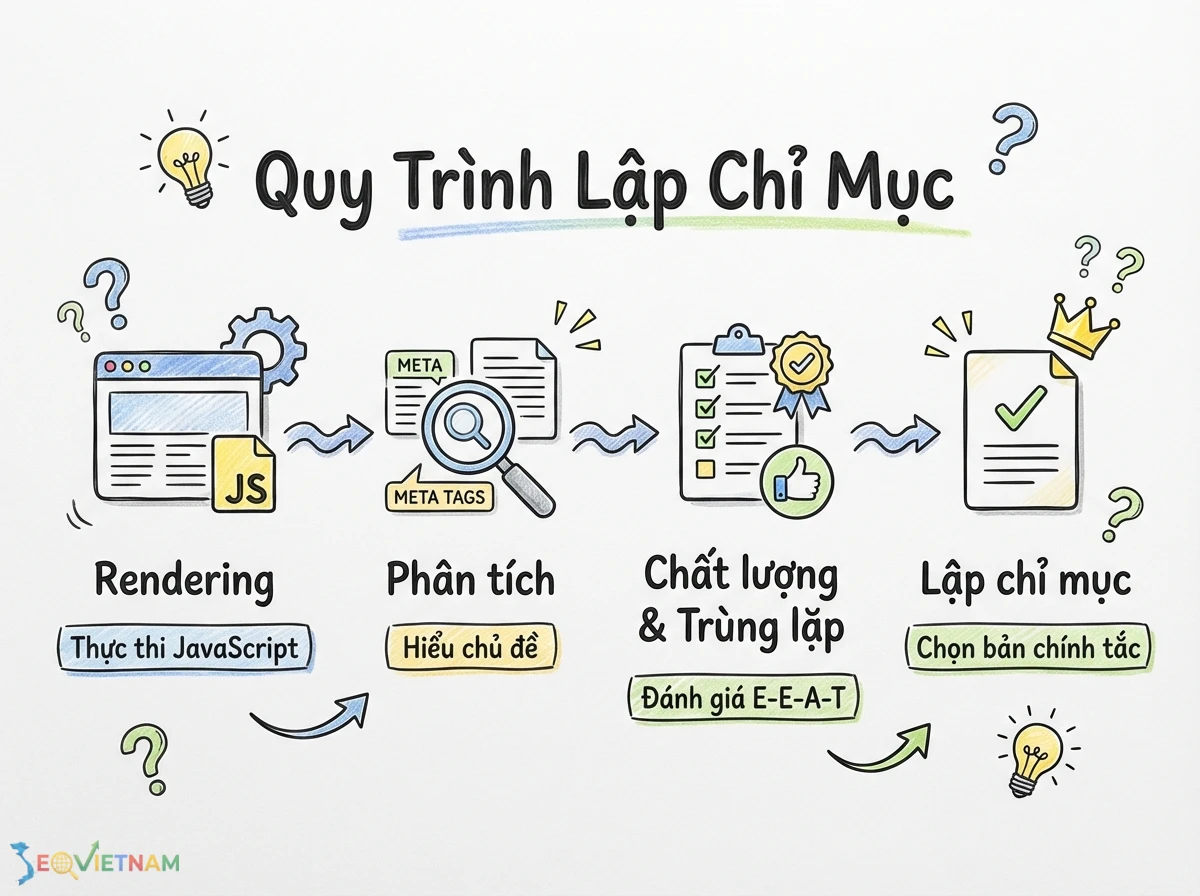
Rendering: Đối với các trang sử dụng nhiều JavaScript, Google cần phải thực thi (render) mã JavaScript để "nhìn thấy" nội dung cuối cùng giống như người dùng trên trình duyệt. Quá trình này tốn nhiều tài nguyên hơn so với việc xử lý HTML thuần túy.
Phân tích và trích xuất: Google phân tích nội dung văn bản, các thẻ meta, thuộc tính alt của hình ảnh, cấu trúc schema markup và các tín hiệu khác để hiểu chủ đề chính của trang. Nó cũng xác định các thực thể (entities), mối quan hệ giữa chúng và chất lượng tổng thể của nội dung.
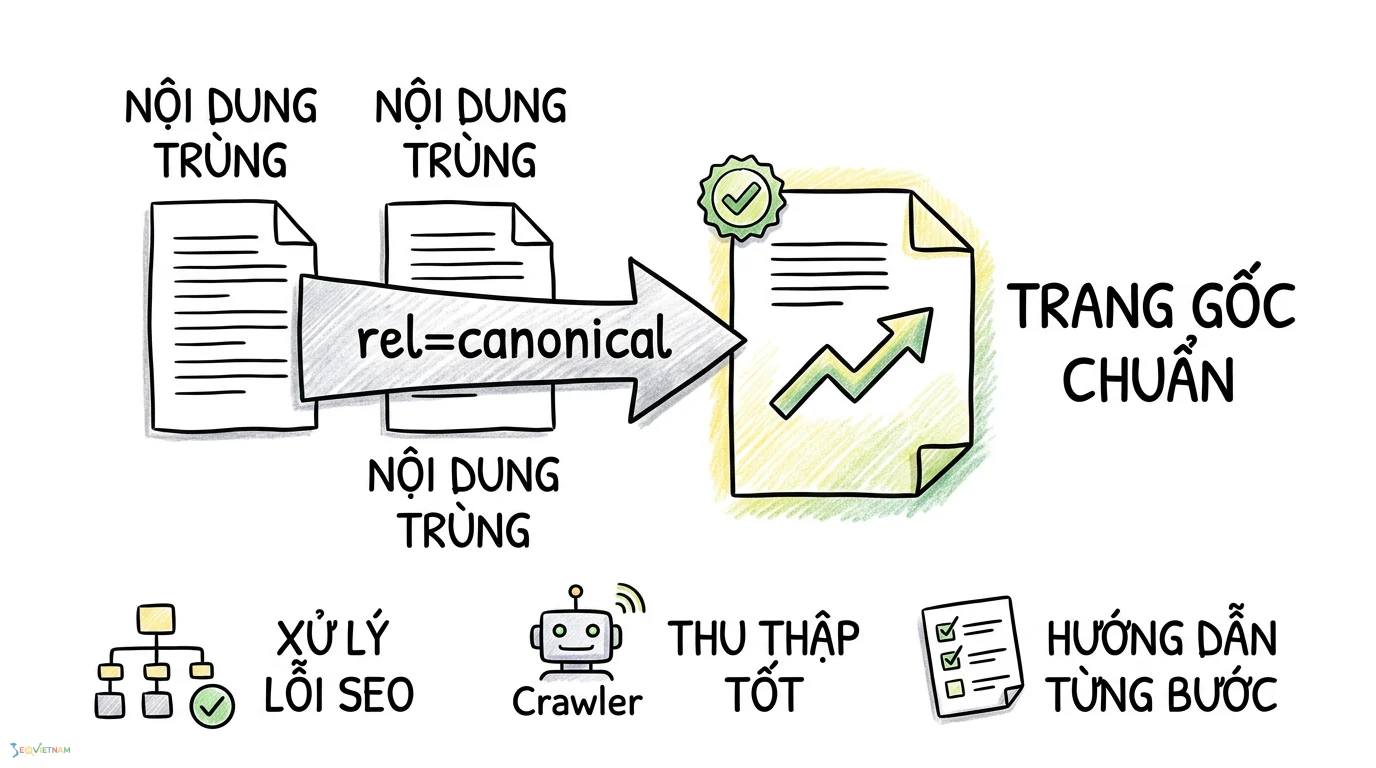
Đánh giá chất lượng và trùng lặp: Google đánh giá chất lượng trang dựa trên các tiêu chí như E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness). Nó cũng xác định các trang trùng lặp hoặc gần trùng lặp và chọn ra một phiên bản chính tắc (canonical) để lập chỉ mục.
Tối ưu hóa indexing: Đảm bảo google hiểu rõ nội dung của bạn
Để một trang được lập chỉ mục thành công và chính xác, bạn cần cung cấp cho Google những tín hiệu rõ ràng về nội dung và cấu trúc của nó.
Schema Markup (JSON-LD): Dữ liệu có cấu trúc giúp Google hiểu rõ hơn về các thực thể trên trang của bạn, chẳng hạn như sản phẩm, bài viết, công thức nấu ăn, hoặc câu hỏi thường gặp (FAQ). Điều này không chỉ hỗ trợ indexing mà còn có thể giúp trang của bạn có được các kết quả nhiều định dạng (rich results) trên SERP.
Thẻ Canonical: Thẻ rel="canonical" chỉ định URL chính tắc cho một trang khi có nhiều phiên bản nội dung tương tự hoặc trùng lặp. Điều này giúp hợp nhất các tín hiệu xếp hạng vào một URL duy nhất và tránh các vấn đề về nội dung trùng lặp.
JavaScript Rendering: Đảm bảo rằng nội dung và liên kết quan trọng được hiển thị trong HTML ban đầu hoặc có thể được render dễ dàng bởi Googlebot. Tránh việc ẩn nội dung quan trọng phía sau các tương tác phức tạp của người dùng mà bot không thể thực hiện.
So sánh chi tiết crawling và indexing: Điểm giống và khác biệt cốt lõi
Mặc dù crawling và indexing là hai quá trình liên tiếp trong hoạt động của công cụ tìm kiếm, chúng có mục tiêu và cơ chế hoàn toàn khác nhau. Việc phân biệt rõ ràng hai khái niệm này là rất quan trọng để chẩn đoán chính xác các vấn đề SEO kỹ thuật.
|
Tiêu chí |
Crawling (Thu thập dữ liệu) |
Indexing (Lập chỉ mục) |
Ghi chú |
|
Mục tiêu chính |
Khám phá các URL mới và cập nhật trên web. |
Phân tích, hiểu và lưu trữ nội dung vào cơ sở dữ liệu. |
Crawling là bước đầu vào, Indexing là bước xử lý và lưu trữ. |
|
Đối tượng |
Các URL (địa chỉ trang web). |
Nội dung và ngữ cảnh của các URL đã được crawl. |
Bot chỉ "biết" URL tồn tại, chưa hiểu nội dung bên trong. |
|
Công cụ/Tệp điều khiển |
robots.txt, sitemap.xml, rel="nofollow". |
Thẻ meta noindex, thẻ rel="canonical", X-Robots-Tag. |
Sử dụng sai công cụ sẽ dẫn đến kết quả không mong muốn. |
|
Kết quả |
Một danh sách các URL được đưa vào hàng đợi xử lý. |
Một trang được lưu trong chỉ mục tìm kiếm, sẵn sàng để xếp hạng. |
Được crawl không đảm bảo sẽ được index. |
|
Vấn đề thường gặp |
Bị chặn bởi robots.txt, lỗi server, crawl budget thấp. |
Nội dung mỏng, trùng lặp, bị noindex, lỗi JavaScript. |
Vấn đề crawling ngăn chặn quá trình indexing bắt đầu. |
Khắc phục sự cố kỹ thuật phổ biến về crawling và indexing
Chẩn đoán và khắc phục các vấn đề liên quan đến crawling và indexing là một trong những nhiệm vụ quan trọng nhất của SEO kỹ thuật. Bảng ma trận dưới đây tổng hợp các lỗi thường gặp trong Google Search Console và cách xử lý.
|
Lỗi |
Dấu hiệu trong GSC |
Nguyên nhân phổ biến |
Cách khắc phục |
Mức độ ưu tiên |
|
Trang bị chặn bởi robots.txt |
Trạng thái "Bị chặn bởi tệp robots.txt" trong báo cáo Index Coverage. |
Quy tắc Disallow trong robots.txt đang chặn Googlebot truy cập URL. |
Kiểm tra tệp robots.txt. Xóa hoặc chỉnh sửa quy tắc Disallow đang gây ra vấn đề. Sử dụng công cụ Robots.txt Tester để xác thực. |
Rất cao |
|
Lỗi máy chủ (5xx) |
Trạng thái "Lỗi máy chủ (5xx)" trong báo cáo Index Coverage hoặc Crawl Stats. |
Máy chủ quá tải, lỗi cấu hình, sự cố cơ sở dữ liệu hoặc mã nguồn ứng dụng. |
Liên hệ với nhà cung cấp hosting hoặc đội ngũ phát triển để kiểm tra log máy chủ và khắc phục sự cố. |
Rất cao |
|
Trang có thẻ 'noindex' |
Trạng thái "Đã loại trừ bằng thẻ 'noindex'" trong báo cáo Index Coverage. |
Thẻ meta <meta name="robots" content="noindex"> hoặc X-Robots-Tag: noindex trong HTTP header. |
Xóa thẻ noindex khỏi mã nguồn HTML hoặc cấu hình HTTP header nếu trang cần được lập chỉ mục. |
Cao |
|
Trang trùng lặp, Google đã chọn trang chính tắc khác với trang người dùng đã chọn |
Trạng thái "Trang trùng lặp…" trong báo cáo Index Coverage. |
Nội dung quá giống nhau trên nhiều URL. Thẻ canonical chưa được thiết lập hoặc thiết lập sai. |
Hợp nhất nội dung, sử dụng thẻ rel="canonical" để chỉ định URL chính tắc, hoặc dùng chuyển hướng 301. |
Trung bình |
|
Không tìm thấy (404) |
Trạng thái "Không tìm thấy (404)" trong báo cáo Index Coverage. |
URL đã bị xóa hoặc thay đổi nhưng vẫn còn liên kết trỏ đến nó (internal hoặc external). |
Nếu trang đã bị xóa vĩnh viễn, để lỗi 404 là đúng. Nếu trang đã chuyển sang URL mới, hãy thực hiện chuyển hướng 301. |
Trung bình |
|
Phát hiện thấy – hiện chưa được lập chỉ mục |
Trạng thái "Phát hiện thấy…" trong báo cáo Index Coverage. |
Google đã biết về URL nhưng chưa thu thập dữ liệu do crawl budget thấp hoặc đánh giá trang không đủ chất lượng. |
Cải thiện chất lượng nội dung, tăng cường liên kết nội bộ đến trang này, và đảm bảo sitemap được cập nhật. |
Thấp |
Crawling và indexing trong bối cảnh SEO hiện đại cập nhật 2026
Các khái niệm cốt lõi về crawling và indexing vẫn giữ nguyên, nhưng bối cảnh công nghệ và thuật toán đã thay đổi cách chúng ta tiếp cận việc tối ưu hóa.
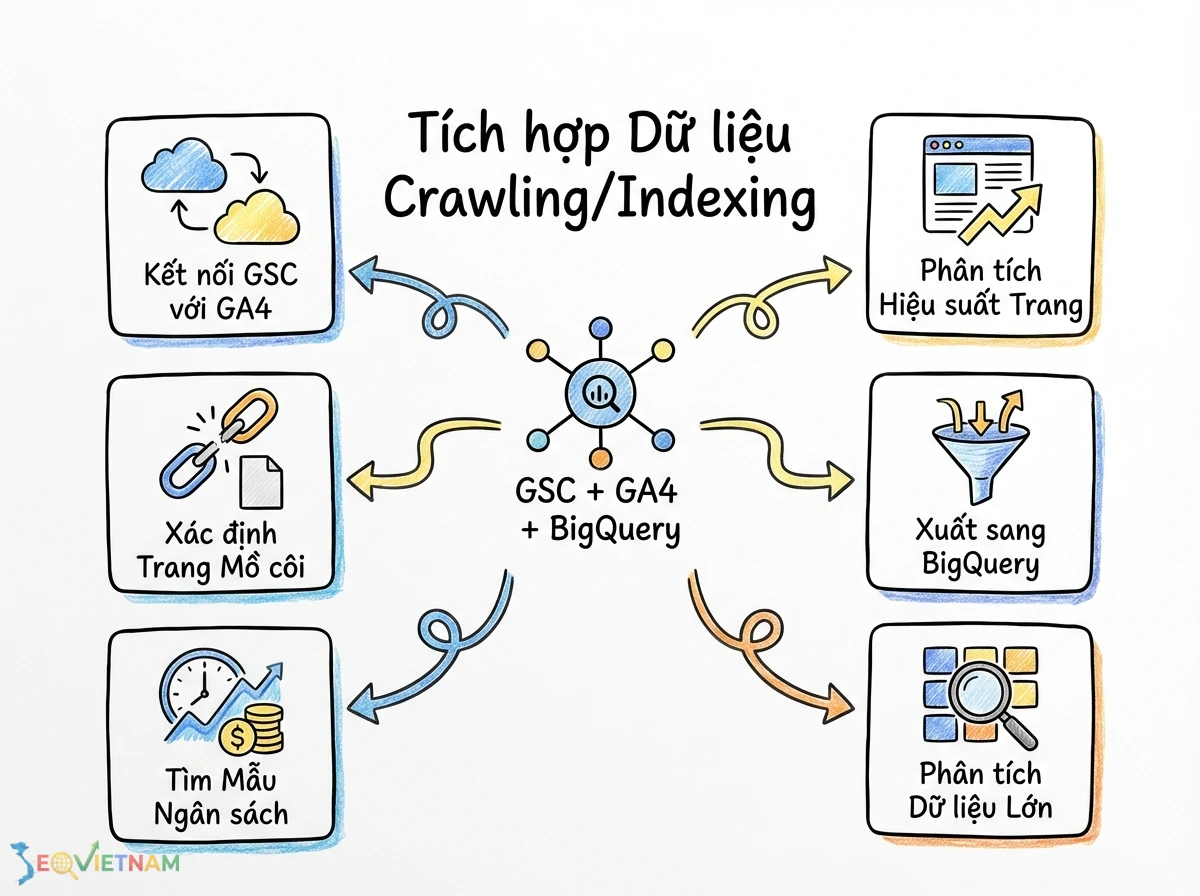
Tích hợp dữ liệu crawling/indexing với GA4 và BigQuery
Google Search Console cung cấp dữ liệu quý giá, nhưng sức mạnh thực sự được khai phá khi bạn kết hợp nó với các nền tảng khác. Bằng cách kết nối GSC với Google Analytics 4 (GA4), bạn có thể phân tích hiệu suất của các trang cụ thể sau khi chúng được index. Đi xa hơn, việc xuất dữ liệu GSC sang BigQuery cho phép các chuyên gia phân tích dữ liệu lớn, tìm ra các mẫu về crawl budget, xác định các trang mồ côi (orphan pages) và thực hiện các phân tích sâu mà giao diện GSC không hỗ trợ.
Tác động của AI (LLMs) đến cách google crawl và index
Sự phát triển của các mô hình ngôn ngữ lớn (LLMs) và các hệ thống AI như RankBrain và MUM đang thay đổi cách Google hiểu nội dung. Google không chỉ index các từ khóa mà còn index các khái niệm, thực thể và mối quan hệ giữa chúng. Điều này có nghĩa là việc tối ưu hóa cho indexing trong kỷ nguyên AI đòi hỏi nội dung phải có chiều sâu, cấu trúc rõ ràng (thông qua schema) và trả lời các câu hỏi một cách toàn diện, thay vì chỉ nhồi nhét từ khóa. Crawling cũng có thể trở nên thông minh hơn, ưu tiên thu thập các nội dung được dự đoán là hữu ích và chất lượng cao.
Checklist tối ưu crawling và indexing toàn diện
Để đảm bảo website của bạn được thu thập và lập chỉ mục hiệu quả, hãy tuân thủ theo checklist tối ưu hóa toàn diện sau đây. Đây là quy trình được đội ngũ SEO Việt Nam áp dụng cho các dự án quan trọng.
|
Hạng mục |
Chi tiết thực hiện |
Mức độ ưu tiên |
|
Robots.txt |
Kiểm tra không có quy tắc Disallow nào chặn các tài nguyên quan trọng (CSS, JS) hoặc các phần nội dung cần index. Khai báo đường dẫn sitemap. |
Rất cao |
|
Sitemap.xml |
Đảm bảo sitemap được cập nhật tự động, chỉ chứa các URL trả về mã trạng thái 200, không chứa các URL đã canonicalized hoặc noindex. Gửi sitemap trong GSC. |
Rất cao |
|
Google Search Console |
Xác minh quyền sở hữu website. Thường xuyên theo dõi báo cáo Index Coverage và Crawl Stats để phát hiện sớm các vấn đề. |
Rất cao |
|
Cấu trúc URL |
Sử dụng cấu trúc URL đơn giản, logic, và chứa từ khóa chính. Tránh các URL có quá nhiều tham số động. |
Cao |
|
Liên kết nội bộ |
Xây dựng một mạng lưới liên kết nội bộ chặt chẽ, giúp bot khám phá các trang sâu hơn và người dùng điều hướng dễ dàng. |
Cao |
|
Tốc độ trang và Core Web Vitals |
Tối ưu hóa tốc độ tải trang trên cả máy tính và di động. Đảm bảo các chỉ số Core Web Vitals đạt ngưỡng "Tốt". |
Cao |
|
Thẻ Canonical |
Sử dụng thẻ rel="canonical" trên tất cả các trang để chỉ định phiên bản chính tắc, tránh các vấn đề về nội dung trùng lặp. |
Cao |
|
Schema Markup (JSON-LD) |
Triển khai dữ liệu có cấu trúc phù hợp với loại nội dung (Article, Product, FAQ, etc.) để giúp Google hiểu rõ hơn về trang của bạn. |
Trung bình |
|
JavaScript SEO |
Kiểm tra website bằng công cụ URL Inspection của GSC để đảm bảo Googlebot có thể render và "nhìn thấy" toàn bộ nội dung quan trọng. |
Trung bình |
|
Phân tích Log Server |
Đối với website lớn, định kỳ phân tích log file của máy chủ để hiểu hành vi của Googlebot và tối ưu hóa crawl budget. |
Nâng cao |
Kết luận
Crawling và indexing là hai trụ cột không thể thiếu của SEO kỹ thuật. Một website không thể xếp hạng nếu không được Google thu thập và lập chỉ mục một cách hiệu quả. Bằng cách hiểu rõ cơ chế hoạt động, các yếu tố ảnh hưởng và cách sử dụng các công cụ như Google Search Console để chẩn đoán và khắc phục sự cố, bạn có thể đảm bảo nền tảng kỹ thuật của website luôn vững chắc. Việc tối ưu hóa liên tục cho crawling và indexing theo các hướng dẫn cập nhật 2026 sẽ giúp nội dung của bạn luôn có cơ hội tốt nhất để tiếp cận người dùng mục tiêu trên Google.
Bài viết liên quan
https://seovietnam.vn/thu-thap-du-lieu-va-lap-chi-muc-la-gi/
https://seovietnam.vn/cac-loai-tep-google-co-the-lap-chi-muc/