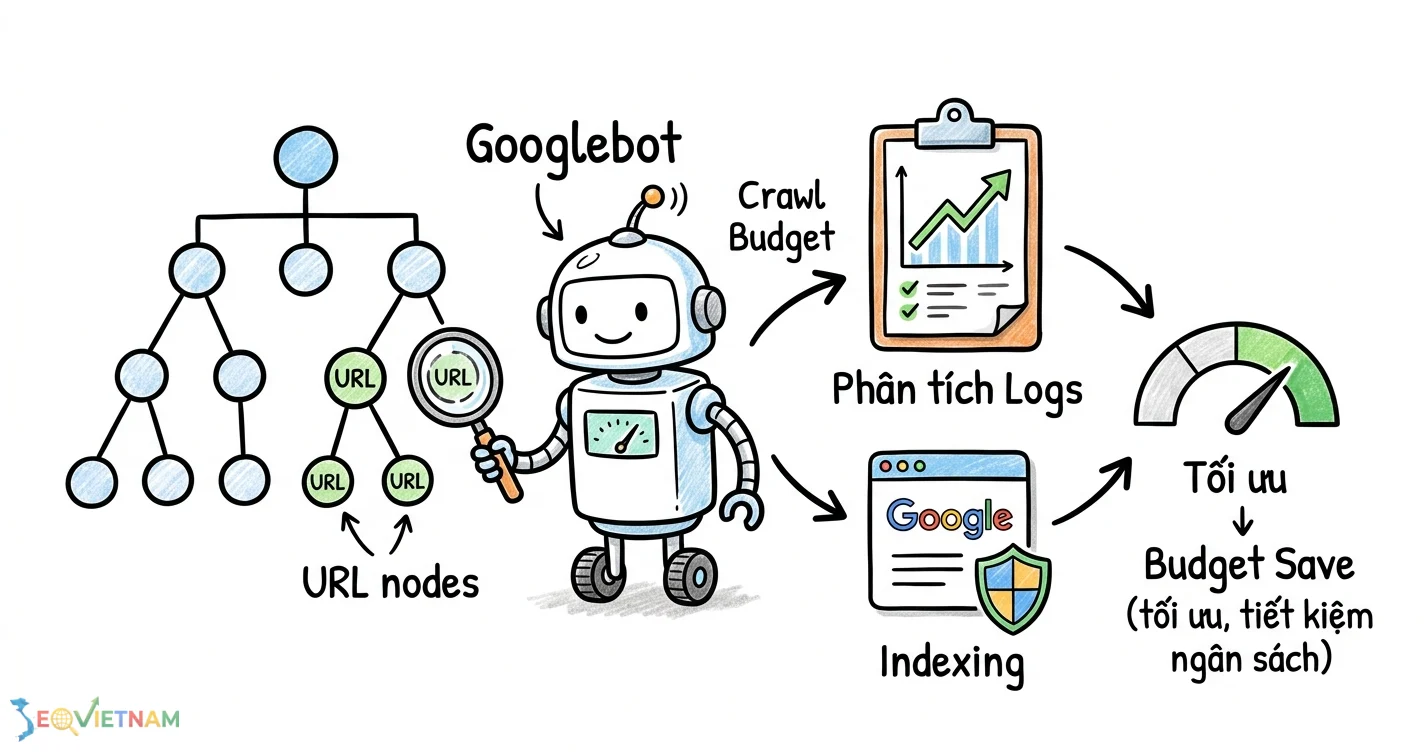
Tại sao nội dung mới đăng tải mất hàng tuần để được Google index, trong khi website đối thủ chỉ cần vài giờ? Câu trả lời thường không nằm ở content hay backlink, mà ở một khái niệm kỹ thuật sâu hơn: Ngân sách thu thập dữ liệu. Hiểu rõ crawl budget là gì không chỉ là kiến thức nền tảng, mà là chìa khóa để escalade hiệu quả SEO cho các website quy mô lớn và phức tạp. Nó quyết định tần suất và độ sâu Googlebot khám phá trang web của bạn, ảnh hưởng trực tiếp đến tốc độ index và xếp hạng. Tại SEO Việt Nam, chúng tôi nhận thấy rằng việc kiểm soát và tối ưu hóa tài nguyên này là một trong những đòn bẩy kỹ thuật mang lại ROI cao nhất, đặc biệt là trong bối cảnh cạnh tranh hiện nay.
Bài viết này sẽ đi thẳng vào các kỹ thuật phân tích và tối ưu hóa chuyên sâu, từ việc đọc hiểu log server đến việc áp dụng các chiến lược nâng cao, giúp bạn làm chủ hoàn toàn cách Google tương tác với website của mình.
Crawl budget là gì? Hiểu sâu về cơ chế thu thập dữ liệu của googlebot
Crawl budget (ngân sách thu thập dữ liệu) là tổng số lượng URL mà Googlebot có thể và muốn thu thập trên một website trong một khoảng thời gian nhất định. Đây không phải là một chỉ số cố định mà Google công bố, mà là một khái niệm tổng hợp từ hai yếu tố chính: giới hạn tốc độ thu thập (crawl rate limit) và nhu cầu thu thập (crawl demand). Việc quản lý tốt ngân sách này đảm bảo các trang quan trọng nhất của bạn được phát hiện và index nhanh chóng.
Phân biệt crawl rate limit, crawl demand và crawl budget
Hiểu sai ba khái niệm này là nguyên nhân dẫn đến các chiến lược tối ưu sai lầm. Chúng có mối quan hệ nhân quả nhưng hoàn toàn khác biệt về bản chất. Sự khác biệt được thể hiện rõ nhất qua khả năng và ý định của Googlebot khi tiếp cận website của bạn.
|
Tiêu chí |
Crawl rate limit (Giới hạn tốc độ thu thập) |
Crawl demand (Nhu cầu thu thập) |
Gợi ý xử lý |
|
Bản chất |
Khả năng kỹ thuật. Googlebot sẽ thu thập nhanh đến mức nào mà không làm ảnh hưởng tiêu cực đến server của bạn. |
Mức độ ưu tiên. Googlebot "muốn" thu thập lại nội dung của bạn thường xuyên như thế nào. |
Tập trung cải thiện sức khỏe server để tăng Rate Limit và nâng cao chất lượng nội dung/tín hiệu để tăng Demand. |
|
Yếu tố ảnh hưởng |
Tốc độ phản hồi của server (TTFB), lỗi server (5xx), cấu hình trong Google Search Console. |
Mức độ phổ biến (popularity) của URL, tần suất cập nhật nội dung (freshness), tín hiệu từ sitemap.xml. |
Giảm thiểu lỗi server và tối ưu tốc độ là ưu tiên hàng đầu để tăng giới hạn kỹ thuật. |
|
Hành động của SEO |
Tối ưu kỹ thuật: nâng cấp hosting, tối ưu code, sử dụng CDN. |
Tối ưu on-page và off-page: cải thiện nội dung, xây dựng liên kết nội bộ và backlink chất lượng. |
Không thể trực tiếp tăng Crawl Budget, nhưng có thể ảnh hưởng gián tiếp bằng cách cải thiện cả hai yếu tố này. |
Các yếu tố thực sự ảnh hưởng đến crawl budget
Dựa trên tài liệu chính thức từ Google, ngân sách thu thập dữ liệu của một website chịu ảnh hưởng bởi một tập hợp các yếu tố kỹ thuật và chất lượng. Việc tối ưu các yếu tố này giúp Googlebot sử dụng thời gian trên trang của bạn một cách hiệu quả nhất.
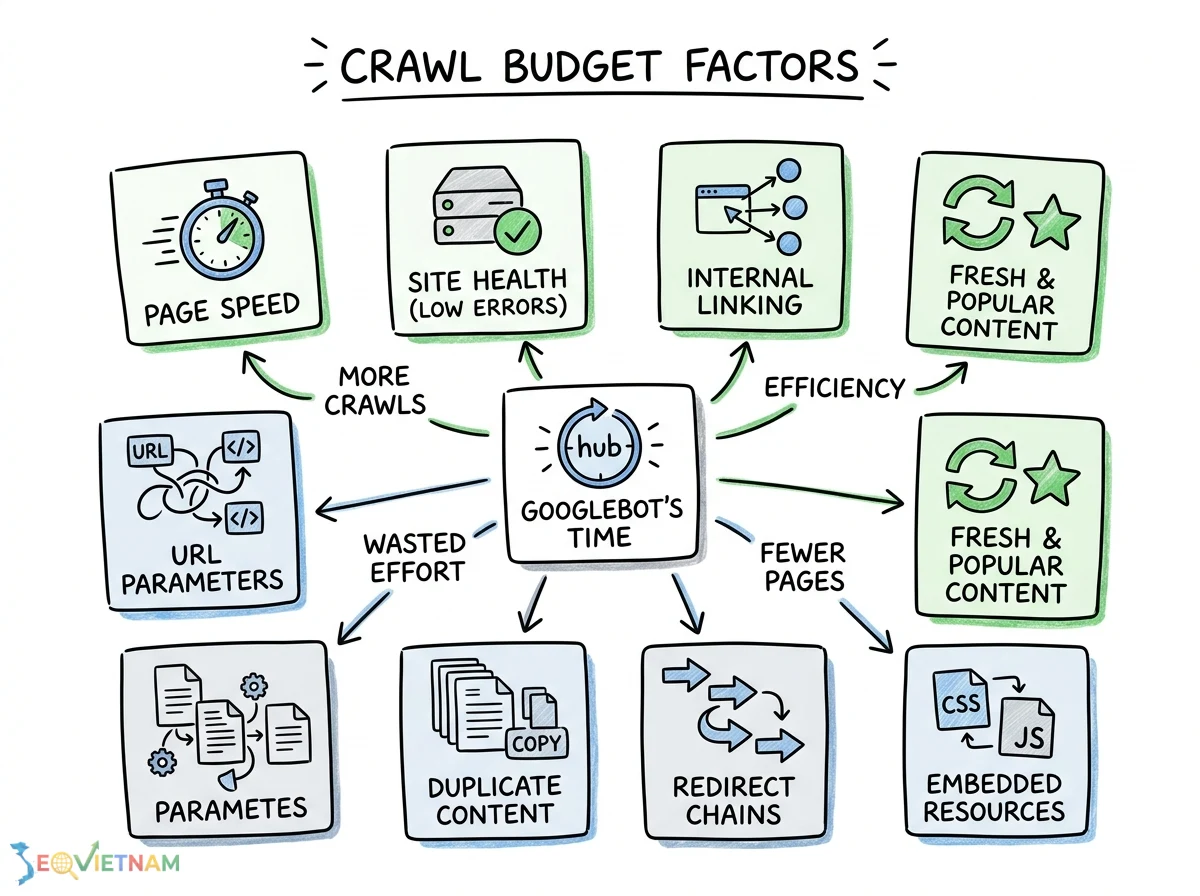
Các yếu tố tích cực (Tăng hiệu quả sử dụng budget):
Tốc độ trang (Page Speed): Server phản hồi nhanh cho phép Googlebot thu thập nhiều URL hơn trong cùng một khoảng thời gian. Tối ưu Core Web Vitals và Time to First Byte (TTFB) là cực kỳ quan trọng.
Sức khỏe của website (Site Health): Tỷ lệ lỗi server (5xx) hoặc lỗi client (4xx) thấp cho thấy website ổn định, khuyến khích Googlebot quay lại thường xuyên hơn.
Cấu trúc liên kết nội bộ mạnh mẽ: Các trang quan trọng nhận được nhiều liên kết nội bộ từ các trang uy tín khác sẽ được ưu tiên thu thập.
Tín hiệu phổ biến và mới mẻ (Popularity & Freshness): Các URL được nhiều người dùng truy cập hoặc có nội dung được cập nhật thường xuyên sẽ có nhu cầu thu thập cao hơn.
Các yếutoos tiêu cực (Lãng phí budget):
URL tham số (Faceted Navigation & URL Parameters): Các bộ lọc sản phẩm hoặc tracking parameters có thể tạo ra vô số URL với nội dung trùng lặp, làm lãng phí ngân sách.
Nội dung chất lượng thấp (Thin & Duplicate Content): Googlebot sẽ giảm tần suất thu thập nếu phát hiện một lượng lớn các trang có nội dung mỏng, trùng lặp hoặc không mang lại giá trị.
Chuỗi chuyển hướng dài (Redirect Chains): Mỗi bước chuyển hướng là một yêu cầu riêng, làm tiêu hao ngân sách trước khi Googlebot đến được URL cuối cùng.
Nội dung nhúng (Embedded Content): Các file CSS, JS không quan trọng được gọi trong mã HTML có thể tiêu tốn các yêu cầu thu thập không cần thiết.
Phân tích crawl budget: Kỹ thuật đọc hiểu dữ liệu từ a-z
Để tối ưu, trước tiên phải đo lường. Dữ liệu từ Google Search Console và log server là hai nguồn thông tin chính xác nhất để chẩn đoán các vấn đề liên quan đến việc thu thập dữ liệu.
Sử dụng google search console để phân tích
Google Search Console (GSC) cung cấp các báo cáo trực quan về cách Googlebot tương tác với website của bạn. Đây là điểm khởi đầu cho mọi phân tích về Crawl Budget.
Phân tích báo cáo thống kê thu thập dữ liệu (Crawl Stats Report) mới nhất: Báo cáo này (Settings > Crawl Stats) là trung tâm thông tin. Hãy chú ý đến các biểu đồ "Tổng số yêu cầu thu thập dữ liệu" và "Tổng kích thước tải xuống". Bất kỳ sự sụt giảm đột ngột nào cũng có thể là dấu hiệu của sự cố server. Phân tích "Yêu cầu thu thập dữ liệu theo phản hồi" để xác định tỷ lệ lỗi 4xx/5xx và "Theo loại tệp" để xem Googlebot đang lãng phí tài nguyên vào các file không cần thiết (ví dụ: file CSS, JS) hay không.
Xác định các vấn đề với báo cáo 'Trang' và 'Sitemap': Trong mục "Lập chỉ mục", báo cáo "Trang" cho bạn biết các URL đã được phát hiện nhưng chưa được lập chỉ mục (Discovered – currently not indexed) hoặc đã thu thập nhưng chưa lập chỉ mục (Crawled – currently not indexed). Đây là những dấu hiệu rõ ràng cho thấy ngân sách đang bị lãng phí vào các trang mà Google cho là không đủ chất lượng. Báo cáo "Sơ đồ trang web" giúp xác nhận các URL quan trọng trong sitemap có đang được thu thập hay không.
Phân tích log server: Kỹ thuật khai thác dữ liệu từ nhật ký máy chủ
Phân tích log server là kỹ thuật nâng cao nhưng cung cấp cái nhìn chi tiết và không bị lọc về mọi yêu cầu từ Googlebot. Đây là nguồn dữ liệu thực tế nhất để hiểu hành vi của bot. Việc Quản lý Googlebot trở nên hiệu quả hơn khi bạn có dữ liệu chính xác từ log.
Các công cụ hỗ trợ phân tích log: Các công cụ như Screaming Frog SEO Log File Analyser, ELK Stack (Elasticsearch, Logstash, Kibana) hoặc GoAccess giúp trực quan hóa và phân tích các tệp log lớn một cách hiệu quả, thay vì phải đọc thủ công từng dòng.
Khai thác thông tin về Googlebot: Trong log, bạn có thể xác định chính xác Googlebot nào đang truy cập (Desktop, Mobile, Image), tần suất truy cập từng loại trang, và các mã trạng thái HTTP mà chúng nhận được. Điều này giúp phát hiện nếu Googlebot đang tập trung vào các trang kém quan trọng hoặc gặp lỗi trên các trang chiến lược.
Sử dụng Regex để lọc và phân tích log hiệu quả: Biểu thức chính quy (Regex) là công cụ mạnh mẽ để trích xuất thông tin cụ thể từ hàng triệu dòng log. Ví dụ, để tìm tất cả các yêu cầu từ Googlebot Mobile, bạn có thể sử dụng pattern sau trong trình soạn thảo văn bản hoặc công cụ phân tích log: .*(Googlebot/2.1;.*http://www.google.com/bot.html).*. Điều này cho phép bạn cô lập và phân tích riêng hành vi của từng user-agent.
Chiến lược tối ưu crawl budget nâng cao cập nhật 2026
Dựa trên dữ liệu đã phân tích, bước tiếp theo là triển khai các chiến lược tối ưu hóa. Mục tiêu không phải là "tăng" budget, mà là hướng Googlebot sử dụng budget hiện có một cách hiệu quả nhất vào các URL thực sự quan trọng.
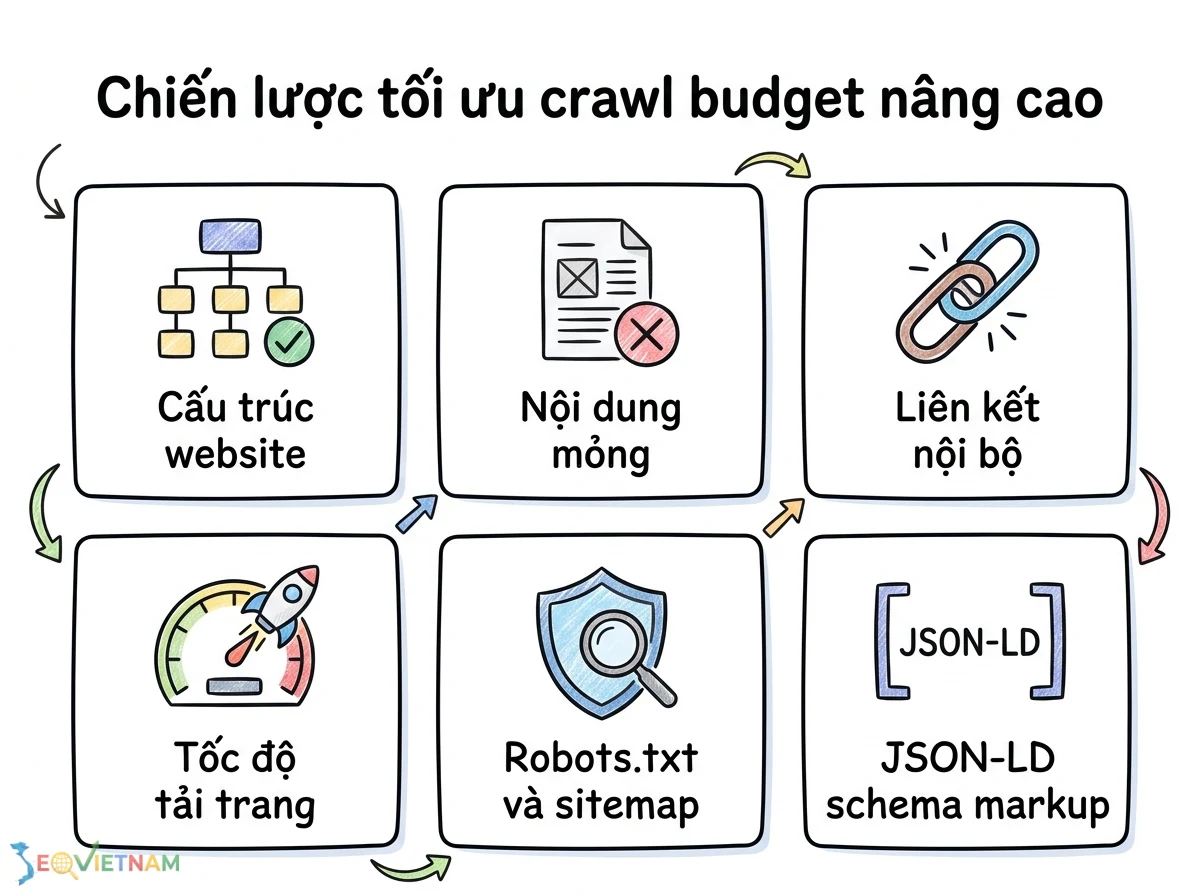
Cải thiện cấu trúc và liên kết nội bộ
Một cấu trúc website logic và hệ thống liên kết nội bộ chặt chẽ là nền tảng của việc Tối ưu ngân sách crawl.
Tối ưu hóa sitemap.xml và robots.txt: Đảm bảo sitemap.xml chỉ chứa các URL 200 OK, có giá trị và đã được chuẩn hóa (canonicalized). Sử dụng file robots.txt để chặn Googlebot truy cập vào các khu vực không cần thiết như trang quản trị, kết quả tìm kiếm nội bộ, hoặc các URL với tham số không quan trọng.
Loại bỏ nội dung trùng lặp và trang chất lượng thấp: Sử dụng các công cụ như Screaming Frog hoặc Sitebulb để quét và xác định các trang có nội dung mỏng (low word count) hoặc trùng lặp. Áp dụng thẻ noindex cho các trang không mang lại giá trị SEO (chính sách bảo mật, trang đăng nhập) và sử dụng thẻ canonical để hợp nhất các URL trùng lặp.
Tối ưu hóa tốc độ tải trang và core web vitals
Tốc độ là một yếu tố then chốt. Google đã xác nhận rằng các trang web nhanh hơn có thể có giới hạn tốc độ thu thập dữ liệu cao hơn.
Kỹ thuật tối ưu hình ảnh, CSS, và JavaScript: Nén hình ảnh sử dụng các định dạng hiện đại như WebP, loại bỏ CSS và JavaScript không sử dụng, và trì hoãn tải các tài nguyên không quan trọng (defer/async). Giảm thiểu thời gian phản hồi của máy chủ (TTFB) bằng cách sử dụng caching hiệu quả và một nhà cung cấp hosting chất lượng.
Sử dụng json-ld schema markup để hướng dẫn googlebot
Dữ liệu có cấu trúc giúp Googlebot hiểu ngữ cảnh của nội dung nhanh hơn, có thể gián tiếp giúp nó ưu tiên thu thập các thực thể quan trọng trên trang của bạn.
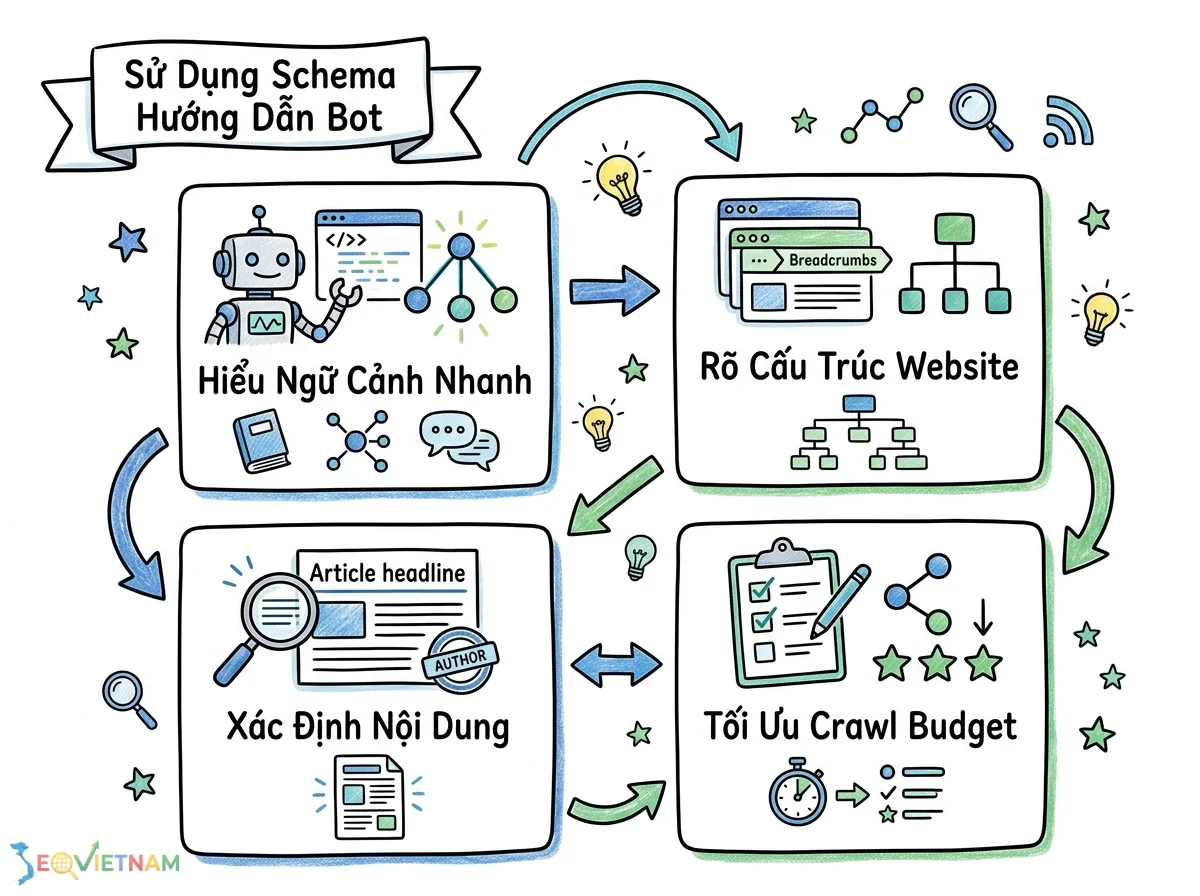
Các loại schema ảnh hưởng đến hiệu quả thu thập: Việc triển khai BreadcrumbList schema giúp Google hiểu cấu trúc phân cấp của website. Article schema giúp xác định rõ nội dung chính. Dưới đây là một ví dụ JSON-LD cơ bản cho một bài viết, giúp bot nhận diện các thành phần chính ngay lập tức:
{
"@context": "https://schema.org",
"@type": "Article",
"headline": "Crawl Budget là gì: Phân tích và Tối ưu Kỹ thuật",
"author": {
"@type": "Organization",
"name": "SEO Việt Nam"
},
"publisher": {
"@type": "Organization",
"name": "SEO Việt Nam",
"logo": {
"@type": "ImageObject",
"url": "https://seovietnam.vn/logo.png/"
}
},
"datePublished": "2026-01-15",
"dateModified": "2026-01-15"
}
Bảng kiểm tra sức khỏe crawl budget
Sử dụng bảng kiểm tra này để đánh giá và ưu tiên các hành động tối ưu hóa ngân sách thu thập dữ liệu cho website của bạn.
|
Hạng mục |
Chi tiết thực hiện |
Mức độ ưu tiên |
|
Phân tích Log Server |
Thiết lập quy trình phân tích log hàng tháng để theo dõi hành vi của Googlebot và xác định các URL lãng phí. |
Cao |
|
Kiểm tra Robots.txt |
Đảm bảo file robots.txt không chặn các tài nguyên quan trọng (CSS/JS) và đang chặn hiệu quả các URL tham số. |
Cao |
|
Tối ưu Sitemap.xml |
Loại bỏ các URL không phải 200 OK, URL đã noindex hoặc canonicalized ra khỏi sitemap. |
Cao |
|
Tốc độ trang |
Đảm bảo điểm Core Web Vitals ở mức "Tốt" và TTFB dưới 200ms cho các trang quan trọng. |
Rất cao |
|
Xử lý lỗi 4xx/5xx |
Sử dụng GSC và log server để tìm và khắc phục tất cả các lỗi server (5xx) và lỗi không tìm thấy trang (404) có lượng truy cập cao. |
Rất cao |
|
Nội dung trùng lặp |
Thực hiện audit nội dung định kỳ để tìm và xử lý các trang trùng lặp bằng thẻ canonical hoặc noindex/redirect. |
Trung bình |
Xử lý sự cố crawl budget: Ma trận chẩn đoán và khắc phục
Khi đối mặt với các vấn đề về thu thập dữ liệu, việc có một quy trình xử lý sự cố rõ ràng là rất quan trọng.
|
Lỗi |
Dấu hiệu |
Nguyên nhân |
Cách khắc phục |
Mức độ ưu tiên |
|
URL quan trọng không được index |
URL được gửi trong sitemap nhưng xuất hiện trong báo cáo "Crawled – currently not indexed" của GSC. |
Nội dung chất lượng thấp, tín hiệu internal link yếu, hoặc website có quá nhiều URL kém chất lượng khác làm lãng phí budget. |
Cải thiện chất lượng nội dung, tăng cường liên kết nội bộ đến URL đó, và dọn dẹp các trang "zombie". |
Cao |
|
Sụt giảm đột ngột số trang được thu thập |
Biểu đồ "Tổng số yêu cầu thu thập dữ liệu" trong GSC giảm mạnh. |
Lỗi cấu hình robots.txt (chặn toàn bộ site), sự cố server (tăng lỗi 5xx), hoặc thay đổi cấu trúc URL hàng loạt không có chuyển hướng. |
Kiểm tra lại file robots.txt, liên hệ với nhà cung cấp hosting để kiểm tra sức khỏe server, và đảm bảo mọi thay đổi URL đều có redirect 301. |
Rất cao |
|
Tăng vọt số lượng URL được phát hiện |
Số lượng URL trong báo cáo "Discovered – currently not indexed" tăng đột biến. |
Hệ thống tạo ra các URL tham số vô hạn (ví dụ: bộ lọc), lỗi trong cấu trúc website tạo ra các đường dẫn không tồn tại. |
Sử dụng file robots.txt để chặn các tham số không cần thiết, và sửa lỗi code gây ra việc tạo URL động không kiểm soát. |
Cao |
|
Googlebot thu thập các trang không quan trọng |
Log server cho thấy phần lớn lượt truy cập của Googlebot tập trung vào các trang tag, trang lưu trữ cũ, hoặc trang quản trị. |
Cấu trúc liên kết nội bộ không hợp lý, hoặc các trang này không được chặn đúng cách trong robots.txt. |
Sử dụng thẻ rel="nofollow" cho các liên kết không quan trọng, thêm noindex vào các trang đó, và chặn chúng trong robots.txt. |
Trung bình |
Kết luận
Làm chủ crawl budget không phải là một công việc làm một lần rồi thôi. Đó là một quy trình liên tục của việc đo lường, phân tích và tối ưu hóa, đòi hỏi sự kết hợp giữa kỹ năng kỹ thuật và tư duy chiến lược. Bằng cách chuyển trọng tâm từ việc "làm sao để Google thu thập dữ liệu nhiều hơn" sang "làm sao để hướng dẫn Google thu thập dữ liệu thông minh hơn", bạn sẽ tạo ra một lợi thế cạnh tranh bền vững. Hãy bắt đầu bằng việc phân tích dữ liệu từ Google Search Console và log server, áp dụng các chiến lược được nêu trong bài viết này, và biến crawl budget từ một mối lo ngại thành một vũ khí mạnh mẽ trong kho công cụ SEO của bạn.
Bài viết liên quan
https://seovietnam.vn/google-crawl-website-nhu-the-nao/