Việc phát hiện website sụt giảm traffic không rõ nguyên nhân là một trong những dấu hiệu đáng báo động nhất đối với bất kỳ chuyên gia SEO nào. Thường thì, thủ phạm ẩn sau vấn đề này chính là các lỗi thu thập dữ liệu (crawl errors) đang âm thầm ngăn cản Googlebot truy cập và hiểu nội dung của bạn. Việc khắc phục lỗi crawl error không chỉ là một nhiệm vụ kỹ thuật, mà là nền tảng cốt lõi để đảm bảo mọi nỗ lực SEO khác không trở nên vô nghĩa. Tại SEO Việt Nam, chúng tôi coi việc giám sát và xử lý các lỗi này là một quy trình ưu tiên hàng đầu trong mọi chiến dịch.
Hướng dẫn này, được cập nhật cho bối cảnh 2026, sẽ đi sâu vào việc chẩn đoán, phân loại và xử lý triệt để các loại lỗi thu thập dữ liệu, từ các sự cố cơ bản trong Google Search Console đến các kỹ thuật phân tích nhật ký máy chủ nâng cao.
Lỗi crawl error là gì và tại sao nó lại quan trọng?
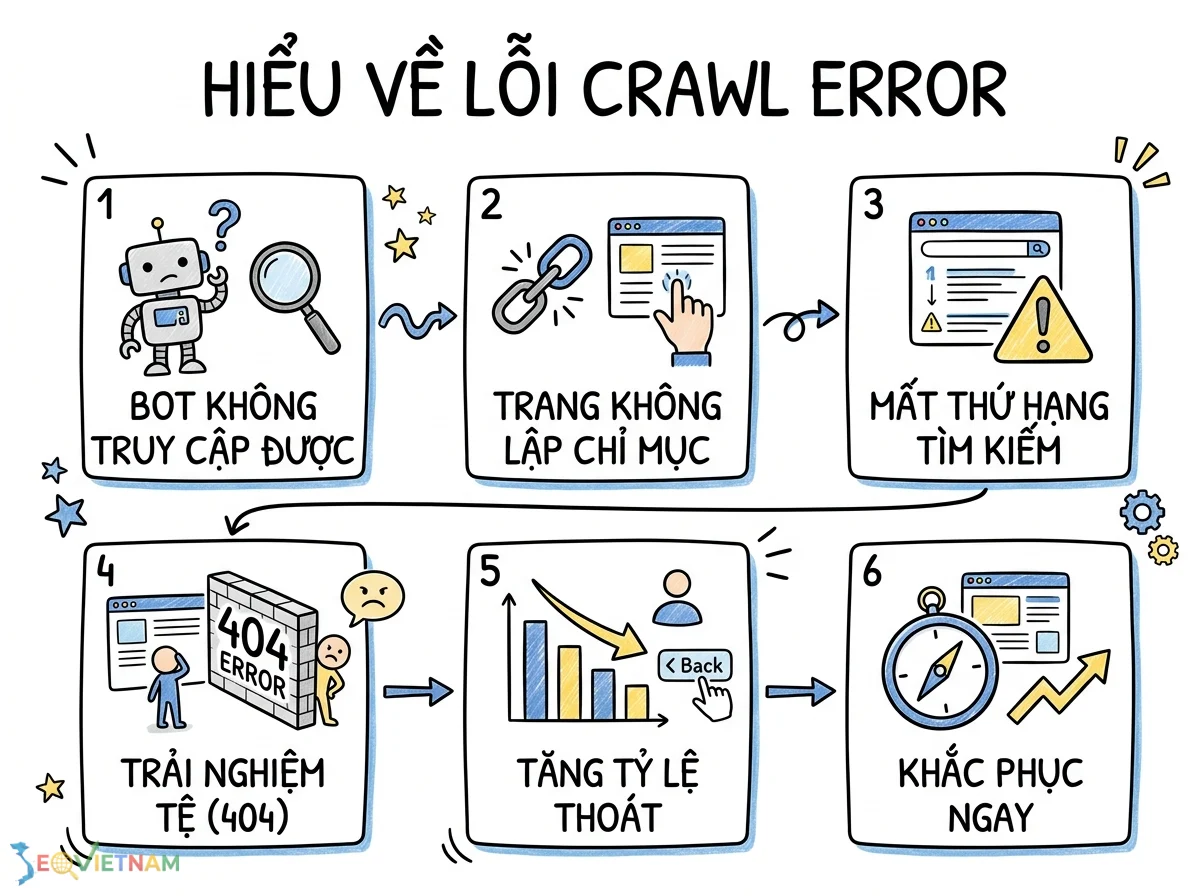
Lỗi crawl error (lỗi thu thập dữ liệu) là bất kỳ sự cố nào ngăn cản trình thu thập dữ liệu của công cụ tìm kiếm (như Googlebot) truy cập một URL cụ thể trên website của bạn. Khi Googlebot không thể "đọc" một trang, nó không thể lập chỉ mục (index) trang đó, đồng nghĩa với việc trang đó sẽ không có khả năng xuất hiện trên kết quả tìm kiếm cho các truy vấn liên quan.
Định nghĩa cơ bản về crawl error và Googlebot
Googlebot là một chương trình tự động của Google, liên tục duyệt qua các trang web trên internet để khám phá các trang mới và cập nhật. Nó di chuyển bằng cách đi theo các liên kết từ trang này sang trang khác. Crawl error xảy ra khi Googlebot cố gắng truy cập một URL nhưng gặp phải rào cản, chẳng hạn như trang không tồn tại, máy chủ không phản hồi, hoặc bị chặn bởi một quy tắc nào đó.
Tầm quan trọng của việc khắc phục crawl error đối với seo và trải nghiệm người dùng
Việc bỏ qua các lỗi thu thập dữ liệu có thể gây ra những hậu quả nghiêm trọng. Đối với SEO, nó trực tiếp làm lãng phí "ngân sách thu thập dữ liệu" (crawl budget) khi Googlebot dành thời gian cho các URL lỗi thay vì các trang quan trọng. Tệ hơn, nó có thể khiến các trang sản phẩm, bài viết blog, hoặc dịch vụ mới của bạn không bao giờ được lập chỉ mục. Về phía người dùng, việc nhấp vào một liên kết nội bộ và gặp phải trang lỗi (ví dụ 404) sẽ tạo ra trải nghiệm tiêu cực, làm tăng tỷ lệ thoát và giảm uy tín của thương hiệu.
Chuẩn bị công cụ: những gì bạn cần trước khi bắt đầu
Để chẩn đoán và khắc phục lỗi crawl error một cách hiệu quả, bạn cần trang bị một bộ công cụ tiêu chuẩn.
Google Search Console (GSC): Đây là công cụ quan trọng nhất. Báo cáo "Trang" (Pages) trong GSC cung cấp danh sách chi tiết các URL không được lập chỉ mục và lý do cụ thể, bao gồm nhiều loại crawl error khác nhau.
Công cụ kiểm tra HTTP Status Code: Các tiện ích mở rộng trình duyệt như "Redirect Path" hoặc các công cụ trực tuyến cho phép bạn xem chuỗi chuyển hướng và mã trạng thái HTTP (như 200, 301, 404, 503) của bất kỳ URL nào.
Truy cập nhật ký máy chủ (Server Logs): Đây là nguồn dữ liệu gốc, ghi lại mọi yêu cầu đến máy chủ của bạn, bao gồm cả các lượt truy cập từ Googlebot. Phân tích nhật ký là phương pháp tối ưu để tìm ra các vấn đề về hiệu suất và lỗi 5xx.
Công cụ kiểm tra của Google: Bao gồm Công cụ kiểm tra robots.txt để xác thực tệp robots.txt và Công cụ kiểm tra URL (URL Inspection Tool) trong GSC để xem Google nhìn nhận một URL cụ thể như thế nào.
Crawler bên thứ ba: Các công cụ như Screaming Frog SEO Spider hoặc Sitebulb cho phép bạn giả lập quá trình thu thập dữ liệu của Google, giúp phát hiện sớm các liên kết hỏng, chuỗi chuyển hướng và các vấn đề khác trên quy mô lớn.
Phân loại và hướng dẫn khắc phục crawl error chi tiết
Hầu hết các lỗi thu thập dữ liệu có thể được nhóm thành một vài loại chính. Hiểu rõ bản chất của từng loại là bước đầu tiên để giải quyết chúng một cách triệt để.
|
Lỗi |
Dấu hiệu |
Nguyên nhân |
Cách khắc phục |
Mức độ ưu tiên |
|
Lỗi Máy chủ (5xx) |
GSC báo cáo "Server error (5xx)", website tải chậm hoặc không thể truy cập. |
Máy chủ quá tải, cấu hình sai, sự cố hosting/CDN, lỗi mã nguồn ứng dụng. |
1. Kiểm tra nhật ký máy chủ để xác định nguyên nhân gốc. 2. Liên hệ nhà cung cấp hosting để kiểm tra tình trạng máy chủ. 3. Tối ưu hóa mã nguồn, cơ sở dữ liệu. 4. Nâng cấp gói hosting nếu cần. |
Cao |
|
Không tìm thấy (404) |
GSC báo cáo "Not found (404)", người dùng thấy trang "Page Not Found". |
URL bị xóa hoặc thay đổi mà không có chuyển hướng, lỗi đánh máy trong liên kết nội bộ. |
1. Nếu trang đã chuyển sang URL mới, sử dụng chuyển hướng 301 vĩnh viễn. 2. Nếu trang bị xóa vĩnh viễn và không có trang thay thế, hãy để nó trả về mã 404 hoặc 410. 3. Sửa các liên kết nội bộ bị hỏng. |
Cao |
|
Soft 404 |
GSC báo cáo "Soft 404". Trang hiển thị thông báo lỗi nhưng trả về mã trạng thái 200 (OK). |
Trang lỗi (vd: "sản phẩm không tìm thấy") nhưng máy chủ vẫn trả về mã 200 thay vì 404. |
Cấu hình máy chủ hoặc ứng dụng để các trang không có nội dung thực sự trả về mã trạng thái HTTP 404 (Not Found) hoặc 410 (Gone). |
Trung bình |
|
Bị chặn bởi robots.txt |
GSC báo cáo "Blocked by robots.txt". |
Tệp robots.txt chứa quy tắc Disallow đang chặn Googlebot truy cập vào các tài nguyên quan trọng (trang, CSS, JS). |
1. Mở tệp robots.txt và rà soát các quy tắc. 2. Xóa hoặc chỉnh sửa các dòng Disallow không cần thiết. 3. Sử dụng Công cụ kiểm tra robots.txt của GSC để xác thực thay đổi. |
Cao |
|
Lỗi chuyển hướng |
GSC báo cáo "Redirect error", chuỗi chuyển hướng (redirect chain), vòng lặp chuyển hướng (redirect loop). |
Cấu hình chuyển hướng sai, nhiều lớp chuyển hướng chồng chéo (A -> B -> C -> D). |
1. Sử dụng crawler để xác định các chuỗi chuyển hướng. 2. Cập nhật quy tắc chuyển hướng để trỏ trực tiếp từ URL ban đầu đến URL cuối cùng (A -> D). **3. **Loại bỏ các vòng lặp (A -> B -> A). |
Trung bình |
Việc xử lý các sự cố phía máy chủ là cực kỳ quan trọng; một Lỗi máy chủ 5xx kéo dài có thể khiến Google giảm tần suất thu thập dữ liệu trang web của bạn. Tương tự, một số lượng lớn Lỗi 404 không được quản lý có thể làm lãng phí ngân sách thu thập dữ liệu và ảnh hưởng đến trải nghiệm người dùng.
Các phương pháp chẩn đoán nâng cao và giám sát chủ động
Khắc phục lỗi khi chúng đã xảy ra là cần thiết, nhưng việc thiết lập một hệ thống giám sát chủ động sẽ giúp bạn đi trước một bước.
Phân tích nhật ký máy chủ (log file analysis) với bigquery
Nhật ký máy chủ là nguồn thông tin trung thực nhất về hoạt động của Googlebot. Bằng cách nhập nhật ký vào Google BigQuery, bạn có thể chạy các truy vấn SQL mạnh mẽ để tìm ra các vấn đề tiềm ẩn.
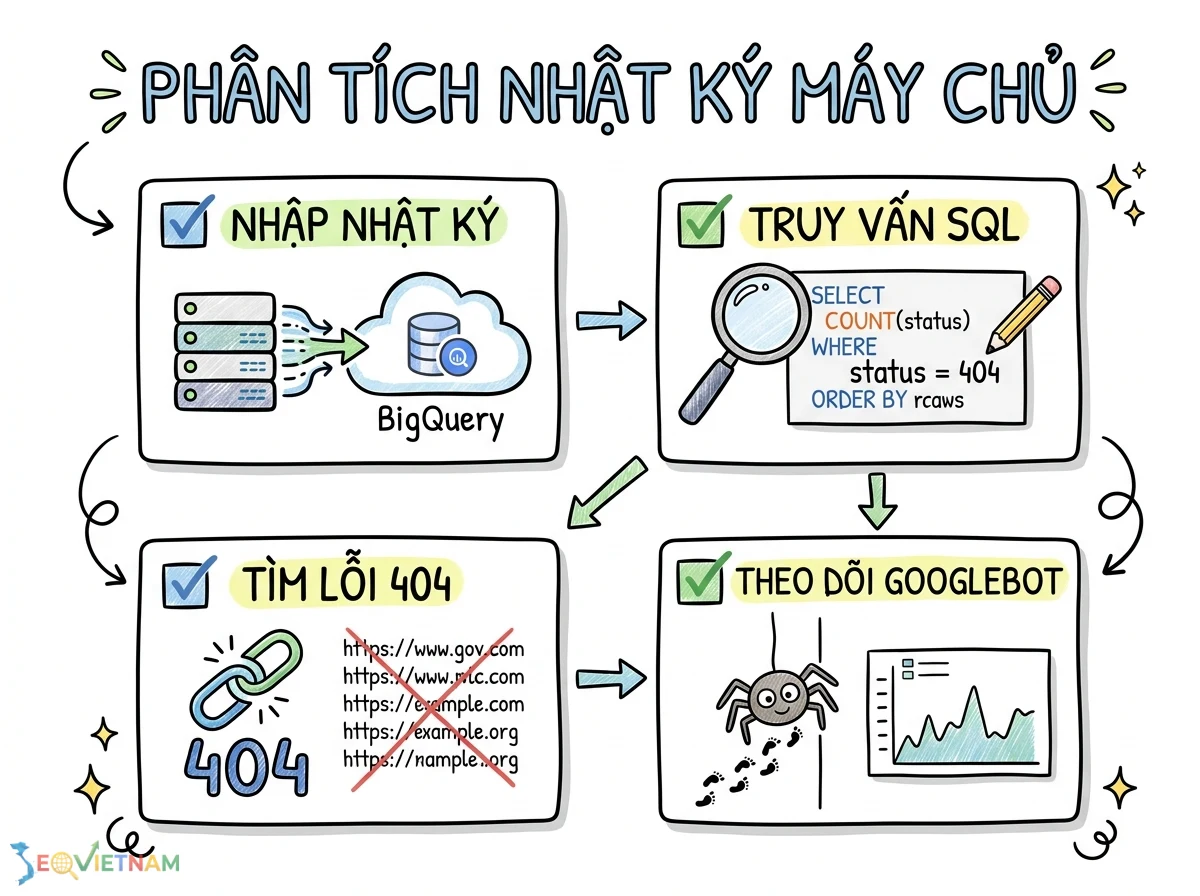
Ví dụ, truy vấn sau giúp tìm các URL thường xuyên bị Googlebot truy cập nhưng lại trả về mã trạng thái 404:
SELECT
req_url,
COUNT(*) AS crawl_hits
FROM
`your_project.your_dataset.server_logs_*`
WHERE
user_agent LIKE '%Googlebot%'
AND status = 404
GROUP BY
req_url
ORDER BY
crawl_hits DESC
LIMIT 100;
Thiết lập cảnh báo crawl error tự động với ga4 và gtm
Bạn có thể sử dụng Google Tag Manager (GTM) để kích hoạt một sự kiện Google Analytics 4 (GA4) mỗi khi một trang trả về tiêu đề là "Page Not Found".
Bước 1: Trong GTM, tạo một biến "JavaScript Variable" để lấy document.title.
Bước 2: Tạo một trigger loại "Page View" kích hoạt khi biến document.title chứa "Trang không tìm thấy" (hoặc văn bản tương ứng trên trang 404 của bạn).
Bước 3: Tạo một thẻ GA4 Event, đặt tên sự kiện là error_404, và liên kết nó với trigger vừa tạo.
Sau khi thiết lập, bạn có thể tạo cảnh báo tùy chỉnh trong GA4 để nhận email mỗi khi số lượng sự kiện error_404 tăng đột biến.
Tối ưu hóa crawl budget cho website quy mô lớn
Đối với các trang web lớn (thương mại điện tử, báo chí), việc đảm bảo Googlebot dành thời gian cho các trang quan trọng nhất là tối cần thiết.
Phương pháp: Sử dụng robots.txt để chặn các URL không có giá trị SEO (ví dụ: các trang kết quả tìm kiếm nội bộ có bộ lọc, trang đăng nhập/đăng ký). Tối ưu hóa cấu trúc liên kết nội bộ để các trang quan trọng có nhiều liên kết trỏ đến hơn. Đảm bảo tốc độ tải trang nhanh để Googlebot có thể thu thập nhiều trang hơn trong cùng một khoảng thời gian.
Khắc phục lỗi crawl do javascript (js rendering)
Với sự gia tăng của các website xây dựng trên nền tảng JavaScript (React, Vue, Angular), một loại lỗi thu thập dữ liệu mới đã xuất hiện, liên quan đến việc render nội dung.
Hiểu cách googlebot render javascript
Googlebot không chỉ đọc HTML tĩnh; nó còn có khả năng thực thi JavaScript để "thấy" nội dung được tạo ra sau khi trang tải xong, quá trình này gọi là rendering. Tuy nhiên, quá trình này tốn nhiều tài nguyên hơn. Nếu website của bạn phụ thuộc quá nhiều vào JS để hiển thị nội dung hoặc liên kết, Googlebot có thể gặp khó khăn hoặc bỏ lỡ các phần quan trọng.
Các kỹ thuật seo nâng cao cho website js-heavy
Để đảm bảo các trang web phụ thuộc vào JavaScript được thu thập dữ liệu đúng cách, các nhà phát triển và SEO cần hợp tác để triển khai các giải pháp kỹ thuật.
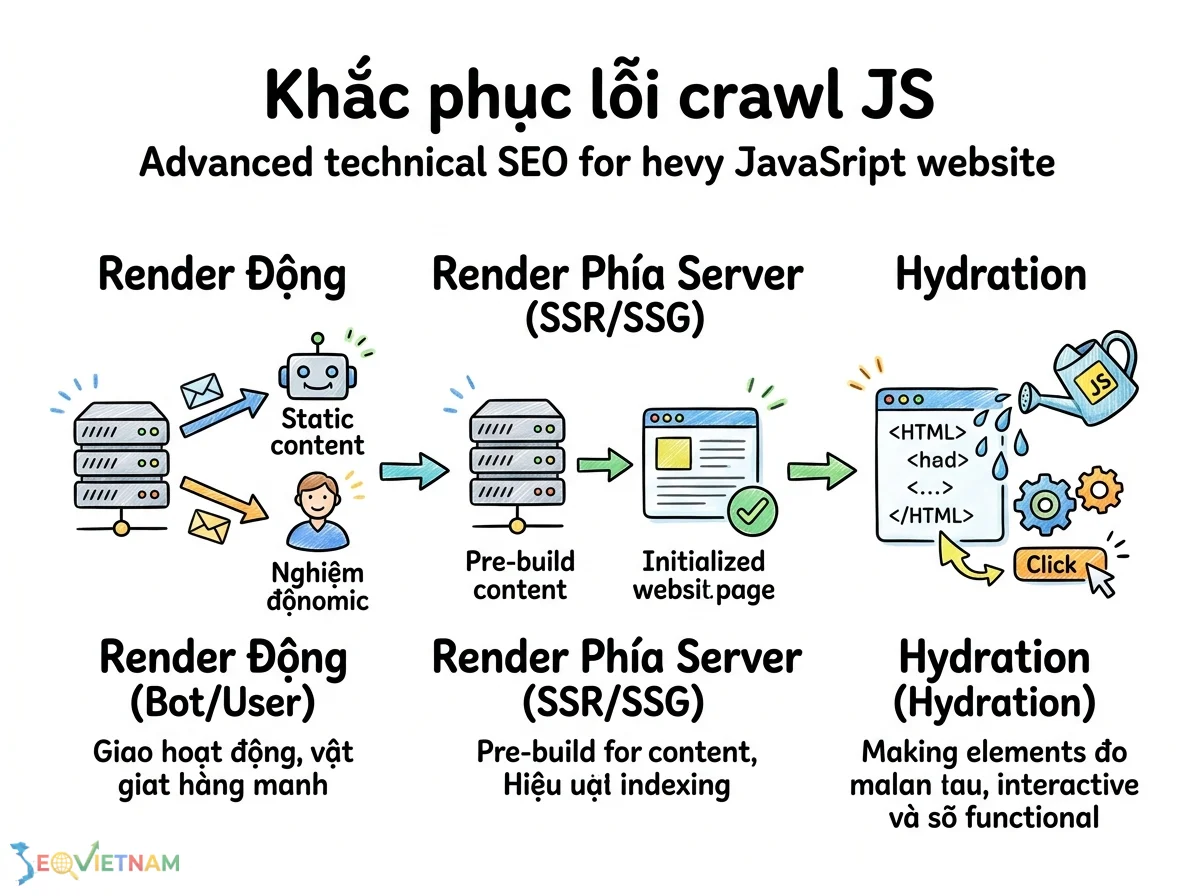
Dynamic Rendering: Cấu hình máy chủ để gửi một phiên bản HTML tĩnh, đã render sẵn cho các bot của công cụ tìm kiếm, trong khi người dùng thật vẫn nhận được phiên bản JS động.
Server-Side Rendering (SSR) hoặc Static Site Generation (SSG): Các framework hiện đại cho phép render nội dung HTML ngay trên máy chủ trước khi gửi đến trình duyệt. Đây là giải pháp ưu việt nhất cho cả SEO và hiệu suất.
Hydration: Một kỹ thuật kết hợp, nơi máy chủ gửi HTML tĩnh ban đầu và sau đó JavaScript "tiếp quản" trên trình duyệt để thêm tính tương tác.
Checklist khắc phục lỗi crawl error nhanh chóng
Sử dụng bảng kiểm tra này để hệ thống hóa quy trình của bạn khi đối mặt với các vấn đề về thu thập dữ liệu.
|
Hạng mục |
Chi tiết thực hiện |
Mức độ ưu tiên |
|
Kiểm tra GSC |
Truy cập báo cáo "Pages" > "Why pages aren't indexed". Phân tích các lỗi được liệt kê (404, 5xx, Soft 404, Blocked). |
Cao |
|
Phân tích Robots.txt |
Sử dụng Google's robots.txt Tester để đảm bảo không có quy tắc nào chặn các tài nguyên quan trọng. |
Cao |
|
Kiểm tra Sitemap |
Đảm bảo tệp sitemap.xml không có lỗi, được gửi trong GSC và chỉ chứa các URL trả về mã 200. |
Trung bình |
|
Kiểm tra Chuyển hướng |
Sử dụng Screaming Frog hoặc một tiện ích trình duyệt để phát hiện các chuỗi và vòng lặp chuyển hướng. |
Trung bình |
|
Phân tích Nhật ký Máy chủ |
Thiết lập quy trình phân tích nhật ký định kỳ để xác định các mẫu lỗi 4xx/5xx và hoạt động của Googlebot. |
Cao (cho web lớn) |
|
Kiểm tra Rendering |
Sử dụng URL Inspection Tool trong GSC để kiểm tra xem Googlebot có thể render trang JS của bạn đúng cách không. |
Cao (cho web JS) |
|
Giám sát chủ động |
Thiết lập cảnh báo tùy chỉnh trong GA4 hoặc các công cụ của bên thứ ba để phát hiện các đợt tăng đột biến về lỗi. |
Trung bình |
Câu hỏi thường gặp về crawl error
Câu hỏi: Lỗi soft 404 khác gì lỗi 404 thường? Lỗi 404 "chuẩn" xảy ra khi máy chủ trả về mã trạng thái HTTP 404, báo hiệu rõ ràng cho trình duyệt và bot rằng trang không tồn tại. Lỗi soft 404 xảy ra khi một trang trông giống như trang lỗi (ví dụ: "Sản phẩm không tìm thấy") nhưng máy chủ lại trả về mã trạng thái 200 (OK), gây nhầm lẫn cho Google và lãng phí ngân sách thu thập dữ liệu.
Câu hỏi: Tôi có nên chặn các trang 404 trong robots.txt không? Không. Việc chặn các trang 404 trong robots.txt sẽ ngăn Googlebot thấy mã trạng thái 404. Điều này khiến Google không thể loại bỏ các URL đó khỏi chỉ mục của mình một cách hiệu quả. Cách tốt nhất là để các URL bị xóa trả về mã 404 hoặc 410 một cách tự nhiên.
Câu hỏi: Mất bao lâu để Google xử lý các thay đổi sau khi tôi sửa lỗi? Sau khi bạn sửa lỗi và yêu cầu xác thực lại trong Google Search Console, thời gian để Google xử lý có thể từ vài ngày đến vài tuần, tùy thuộc vào quy mô trang web và tần suất thu thập dữ liệu của Googlebot. Hãy kiên nhẫn và theo dõi báo cáo trong GSC.
Kết luận
Việc quản lý và khắc phục lỗi crawl error là một quá trình liên tục, không phải là một nhiệm vụ chỉ thực hiện một lần. Một chiến lược SEO kỹ thuật vững chắc đòi hỏi sự giám sát thường xuyên đối với Google Search Console, phân tích định kỳ nhật ký máy chủ và một quy trình rõ ràng để xử lý các vấn đề ngay khi chúng phát sinh. Bằng cách đảm bảo Googlebot có thể truy cập và hiểu nội dung của bạn một cách liền mạch, bạn đang tạo ra nền tảng vững chắc nhất cho sự thành công trong xếp hạng tìm kiếm. Để được hỗ trợ chuyên sâu và triển khai một kế hoạch Fix Crawl Error toàn diện, hãy liên hệ với đội ngũ chuyên gia của SEO Việt Nam.
Bài viết liên quan
https://seovietnam.vn/loi-thu-thap-thong-tin-la-gi/